

WPS 黑马校对
专业AI校对工具,深度支持形近字纠错验收,精准识别"己已巳"等易混字,提供古籍、医学、法律等多行业专用词库配置。
专业AI校对工具,深度支持形近字纠错验收,精准识别"己已巳"等易混字,提供古籍、医学、法律等多行业专用词库配置。

管理形近字纠错验收全流程任务,支持跨部门协同建立测试集、跟踪误报处理进度,确保验收节点按时推进。

支持扫描文档OCR识别后的形近字智能纠错,精准检测影印件中的"戊戌戍"等疑难字形,助力古籍与档案数字化验收。

快速构建形近字纠错验收测试集提交表单,收集各行业特殊术语与误报案例,支持自定义字段与数据自动汇总。

在线协作文档实时启用形近字纠错功能,支持API对接与高并发测试,满足企业验收阶段的协同编辑与权限管理需求。
WPS黑马校对形近字纠错功能上线后,企业需建立科学验收机制确保AI识别准确性。验收应准备含"己已巳""戊戌戍"等高频易混字测试文档,核查误报率低于5%、漏报率低于10%;针对古籍、医学、法律、教育等不同行业制定场景化验证方案,测试疑难字形辨析与专业术语排查能力;评估大文档校对性能(延迟不超原功能20%);保密单位需断网验证单机版。建立持续监控机制,确保文本零差错。
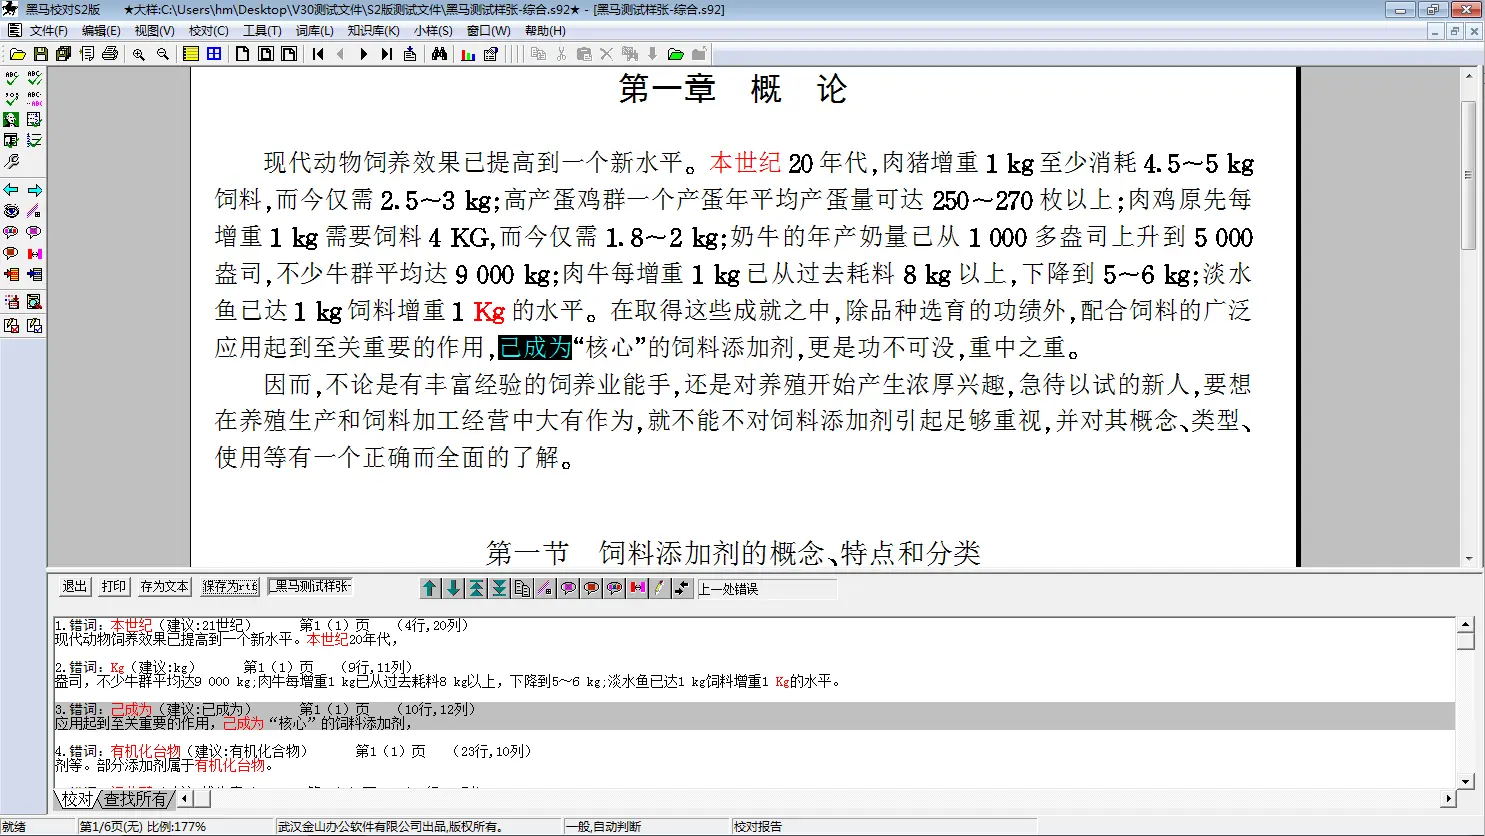
形近字纠错功能上线后,企业需建立科学的验收机制以确保AI识别准确性与业务适配度。验收阶段应准备包含"己已巳""戊戌戍""未末"等高频易混字及专业术语的测试文档,通过WPS Office扫描检测,重点核查误报率与漏报率是否分别低于5%和10%,并与人工校对结果交叉验证。针对古籍出版、医疗法律等不同行业,需专项验证疑难字形辨析与专业术语排查能力,确保符合《通用规范汉字表》及行业规范。
性能评估方面,需测试大文档校对速度,确保形近字检测延迟不超过原功能的20%,同时监控CPU与内存占用情况。对于党政机关及保密单位,建议在断网环境下使用脱敏文档验证单机版功能,确保数据不出本地。验收通过后,应建立持续监控机制,定期收集用户纠错日志与满意度评分,每周统计误报趋势并维护自定义词库。
需要注意的是,形近字纠错作为AI能力的重要组成部分,在WPS 365各版本中权益存在差异:商业旗舰版用户可使用完整的AI Hub与形近字智能校对功能;商业高级版用户需确认是否包含在AI 某在线文档额度内;而商业协作版及体验版用户可能需要联系销售开通或作为加价购选项单独购买。验收前应确认当前套餐版本的功能开放状态,避免因权限问题影响测试完整性。
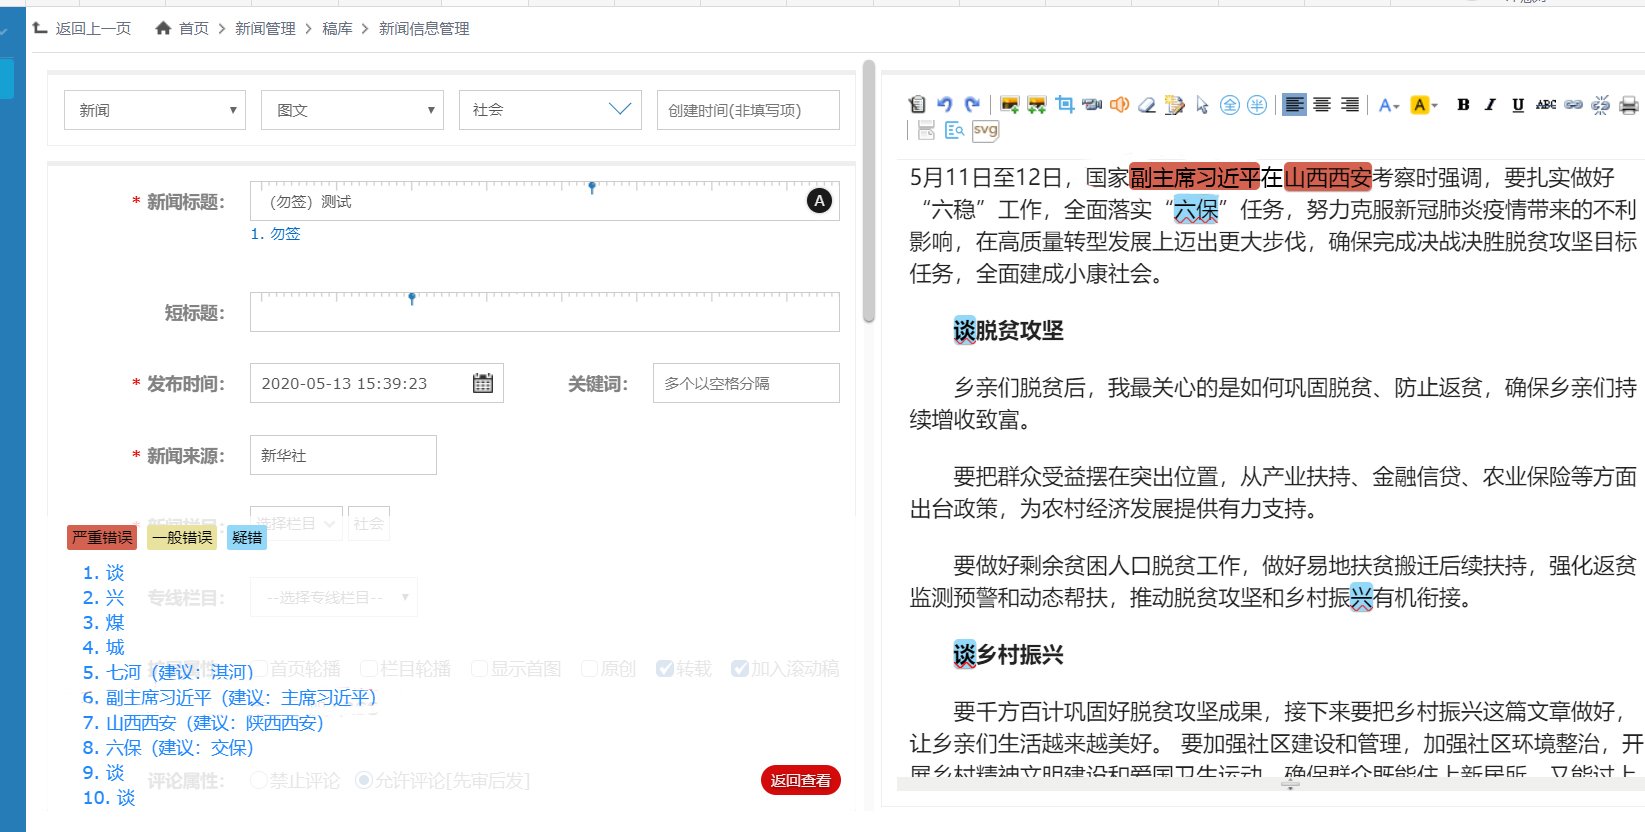
不同行业对形近字纠错的精准度要求存在显著差异,验收时需制定场景化验证方案而非统一标准。针对古籍出版与典籍整理团队,应重点测试"己已巳""戊戌戍戎"等疑难字形的辨析能力,验证异体字自动标记与历史字形对照功能,确保影印件OCR识别的准确率达标;对于医学出版机构,需构建包含"荼/茶""剌/刺""参/叁"等高危用药形近字的专用测试集,重点核查药品名称与解剖学术语的排查精度,防范因一字之差导致的临床误诊风险。
法律与政务场景验收应聚焦"帐/账""籍/藉""符/附"等直接影响法律效力的关键形近字,结合红头文件格式专项扫描,验证政治术语、领导姓名及法规条文中的强力校验机制。教育出版领域则需针对K12高频易错字如"辨/辩/辫""侯/候""霄/宵"进行专项过滤测试,确保教材与试题内容的零差错。对于采用API对接的中大型互联网企业,需在高并发环境下测试RESTful接口的毫秒级响应能力与分布式处理能力,验证信创环境及私有化部署的兼容性。
验收过程中应建立多维度评估矩阵,除基础的准确率与误报率指标外,还需记录行业特殊场景的识别成功率、系统资源占用情况及用户体验流畅度,最终形成包含问题清单与优化建议的正式验收报告,为后续全面上线提供数据支撑与决策依据。
形近字纠错功能上线后的验收并非终点,而应建立持续优化的闭环管理机制。企业需搭建跨部门协同验收小组,由编辑、技术、业务三方共同制定动态测试集,每周导入新增误报/漏报案例进行回归验证,确保模型迭代不降低识别精度。针对验收中发现的误报问题,应建立标准化处理流程:详细记录误报语句上下文并导出日志,同步提交技术支持分析根因,同时通过自定义词库临时屏蔽高频误报规则,保障业务连续性。
重点验证自定义规则灵活性是验收关键环节。企业需导入行业特有形近字词对(如古籍的异体字、医学的药品别名),测试系统是否优先采纳自定义规则而非通用规则,确保敏感术语不被错误标记。对于采用API对接的企业,需在生产环境模拟高并发场景,监控毫秒级响应稳定性与资源占用峰值,验证分布式架构下的负载均衡能力。
最终验收报告应包含多维度评估矩阵:除基础准确率指标外,需量化行业特殊场景识别成功率、用户满意度评分及系统性能损耗数据。建议建立季度复验机制,结合用户反馈日志与业务新需求,持续扩充形近字测试集,形成“部署-验收-监控-优化”的全生命周期质量管理体系,确保形近字校对能力随业务演进持续适配。
企业应建立由编辑部、信息技术与质量控制部门组成的联合验收小组,明确业务侧负责测试场景设计,技术侧负责系统稳定性验证,质控侧负责国家标准符合性审查。验收前需制定详细的Checklist,涵盖《通用规范汉字表》合规性、行业特殊术语覆盖度及数据安全要求,确保测试用例包含脱敏后的真实业务文档与极端场景样本。
验收过程必须形成标准化交付物,包括但不限于:《形近字纠错功能测试报告》(含误报率、漏报率、性能损耗量化数据)、《自定义词库配置指南》(记录行业特殊规则)、《风险管控确认书》(明确AI辅助而非替代人工的最终审核责任)。针对党政机关及法律出版等严肃场景,需额外提供《政治术语与敏感字形校验专项说明》,确认领导人名、法规条文等高危字段的识别精度达标。
为防范上线风险,应设立不少于两周的试运行缓冲期,期间保持人工复核机制与AI校对并行运作,建立24小时应急响应通道。若发现重大漏报(如法律术语"帐/账"混淆未识别)或系统性能严重衰减,立即触发功能回滚机制。验收最终需由三方负责人签署《上线确认书》,明确后续优化责任归属,确保形近字纠错从验收通过到正式投用的平稳过渡。
在《二十四史》整理稿验收阶段,导入含“己已巳”“戊戌戍戎”的测试文档,利用AI形近字辨析引擎进行专项扫描,结合影印件OCR识别与异体字自动标记,快速定位疑难字形并批量修正,显著提升古籍整理精度。
针对《临床用药指南》编审中“荼/茶”“剌/刺”“参/叁”等高危形近字,构建专用测试集进行深度排查,启用药品名称相似字形比对与临床高危用词预警,自动拦截易混用药术语,确保医疗内容零差错。
在《民法典合同编释义》验收中,聚焦“帐/账”“籍/藉”等关键形近字,运行法律术语智能辨析引擎与法条规范用语校验,对合同条款进行逐项排查,自动标记潜在法律歧义,杜绝字形混淆引发的效力争议。
企业应组建编辑、技术、质控三方联合验收小组,准备含"己已巳""戊戌戍"等高频易混字及行业术语的测试文档,重点核查误报率低于5%、漏报率低于10%,并与人工结果交叉验证。需针对古籍、医疗、法律等不同场景专项验证疑难字形与专业术语,性能上确保检测延迟不超原功能20%,保密单位应在断网环境验证单机版。设立两周试运行缓冲期,建立用户反馈与持续优化闭环,形成含量化指标的正式验收报告,确保AI校对能力与业务需求精准适配。

深度融入WPS全家桶,与黑马校对联动,自动检测合同文本中的“己已巳”等形近字错误,避免法律风险,保障合同条款的严谨准确。




依托WPS办公生态,集成黑马校对能力,精准识别进销存单据中的易混字,确保商品名称、规格信息零差错,提升业务数据可靠性。

在WPS环境中无缝协作,借助黑马校对纠正项目文档中的形近字,保障计划书、报告等内容精准无误,助力项目高效交付。

作为WPS生态三方财务软件,结合黑马校对形近字纠错,防范凭证、报表中的“帐/账”等关键错字,降低财务风险,提升做账合规性。




融入WPS智能办公场景,与黑马校对协同,审核业务单据中的易混字,确保交易信息准确,让生意管理更省心。

与WPS黑马校对深度适配,自动检查会计凭证、账簿中的形近字错误,保障财税文书规范,助力企业高效记账。
深度融入WPS全家桶,与黑马校对联动,自动检测合同文本中的“己已巳”等形近字错误,避免法律风险,保障合同条款的严谨准确。
依托WPS办公生态,集成黑马校对能力,精准识别进销存单据中的易混字,确保商品名称、规格信息零差错,提升业务数据可靠性。
在WPS环境中无缝协作,借助黑马校对纠正项目文档中的形近字,保障计划书、报告等内容精准无误,助力项目高效交付。
准备“己已巳”“戊戌戍”等高频形近字及专业术语测试文档,确保校验真实覆盖。
重点核查误报率低于5%、漏报率低于10%,并与人工校对结果交叉验证。
针对古籍、医疗、法律等场景,专项测试疑难字形辨析与高危术语排查能力。
测试大文档校对速度,确保形近字检测延迟不超原功能20%,监控CPU内存。
验收前确认当前套餐是否开放形近字智能校对,避免权限影响测试完整性。
建立日志收集与满意度评分机制,每周统计误报趋势,动态维护自定义词库。
专为企业验收场景打造,覆盖古籍、医疗、法律等多行业形近字辨析,提供误报漏报率量化指标与持续优化机制,确保AI纠错落地即用。