

AI 文档翻译
支持多语种文档翻译,配合多音字标注技术,确保"好(hǎo)""好(hào)"等易混音在对外汉语教材中准确呈现,助力国际出版业务。
支持多语种文档翻译,配合多音字标注技术,确保"好(hǎo)""好(hào)"等易混音在对外汉语教材中准确呈现,助力国际出版业务。

统筹多音字标注审校任务,跟踪860万字教材修订进度,统一团队标注标准,避免人工遗漏,实现编校流程标准化管理。

安全传输含多音字标注的保密教材与古籍文档,支持离线环境文件传输,确保编审意见与注音版本在团队内网安全同步。

一键生成带拼音标注的教学课件,智能识别"长(cháng)度""长(zhǎng)大"等多音字,适用于对外汉语教学与专业领域学术汇报。

集成多音字智能标注与文档全流程管理,支持RESTful API嵌入采编系统,适配信创环境,满足出版教育行业合规需求。
WPS黑马校对多音字标注功能基于NLP语义分析引擎,解决语境依赖性强、人工核查效率低及团队标准难以统一等常见问题,支持教材教辅、辞书编纂、有声书制作及对外汉语教材等场景。提供智能语境识别(准确率超95%)、批量标注、自定义词库及API集成能力,相较人工标注效率提升10倍以上,支持私有化部署与信创环境,确保多音字读音标注准确规范。
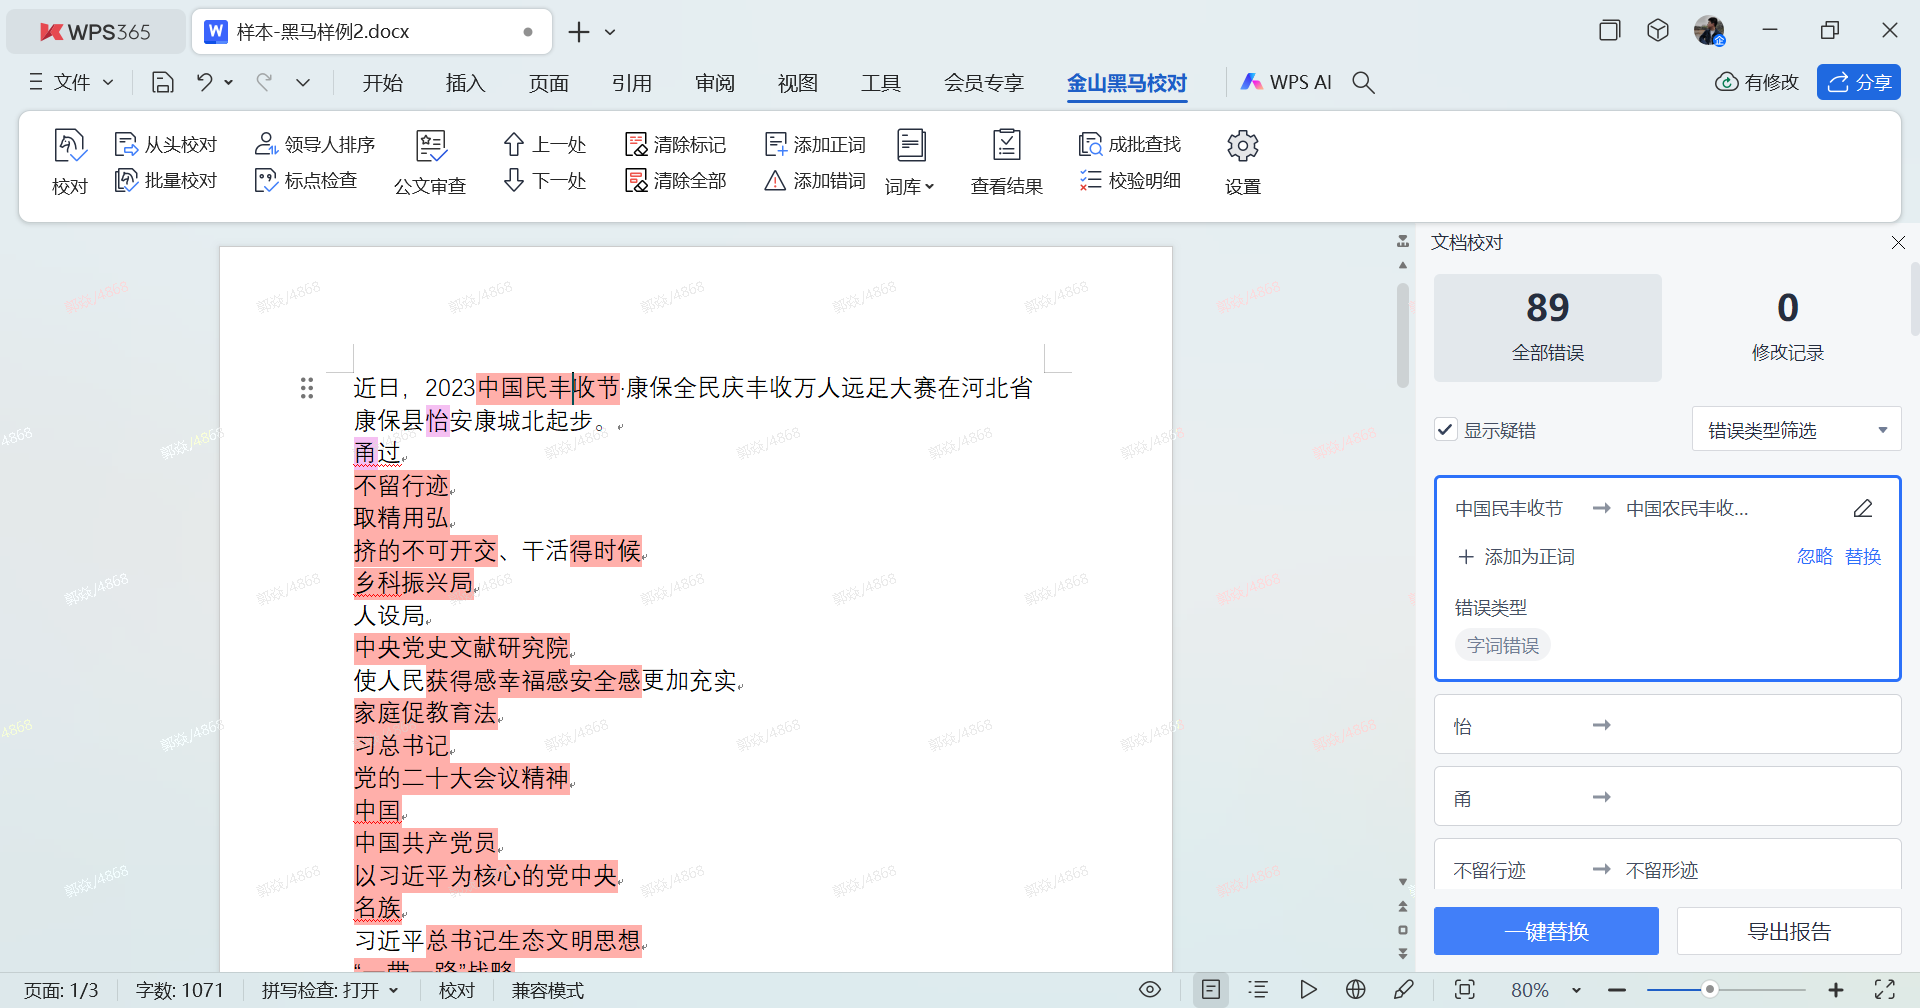
多音字标注面临的主要挑战在于语境依赖性强、人工核查效率低及团队标准难以统一。常见场景如"长(cháng)度"与"长(zhǎng)大"、"行(háng)业"与"行(xíng)走"等,在不同语境下读音差异显著,传统人工标注不仅工作量繁重,且在长文档中极易出现遗漏或误判,特别是古诗文异读字与现代汉语混合场景下,准确性难以保证。此外,成批教辅材料或台本需统一标准时,不同编辑对《普通话异读词审音表》的理解差异会导致质量参差,且企业积累的特定读音规范难以系统化沉淀。
针对这些问题,基于NLP语义分析引擎的智能多音字标注技术能够结合上下文自动判断正确读音,准确率可达95%以上。某直属教材出版社在小学语文教材修订中,对860万字进行批量多音字检查,成功修正340余处人工遗漏;某头部有声书制作平台处理500万字书稿后,后期返工率从15%降至1%以下。系统支持自定义词库添加医学、法律等特殊领域读音规则,并能导出为注音文稿或拼音对照表,满足出版、播音、教育等多行业需求。
需要注意的是,WPS 365各档套餐(体验版、商业协作版199元、商业高级版399元、商业旗舰版599元)默认均不包含多音字智能标注功能,该服务通常需联系销售单独开通或加价购买,按年度授权使用。对于保密单位,可通过软件授权文件离线激活,利用内置词库实现内网环境下的多音字标注,确保数据安全。
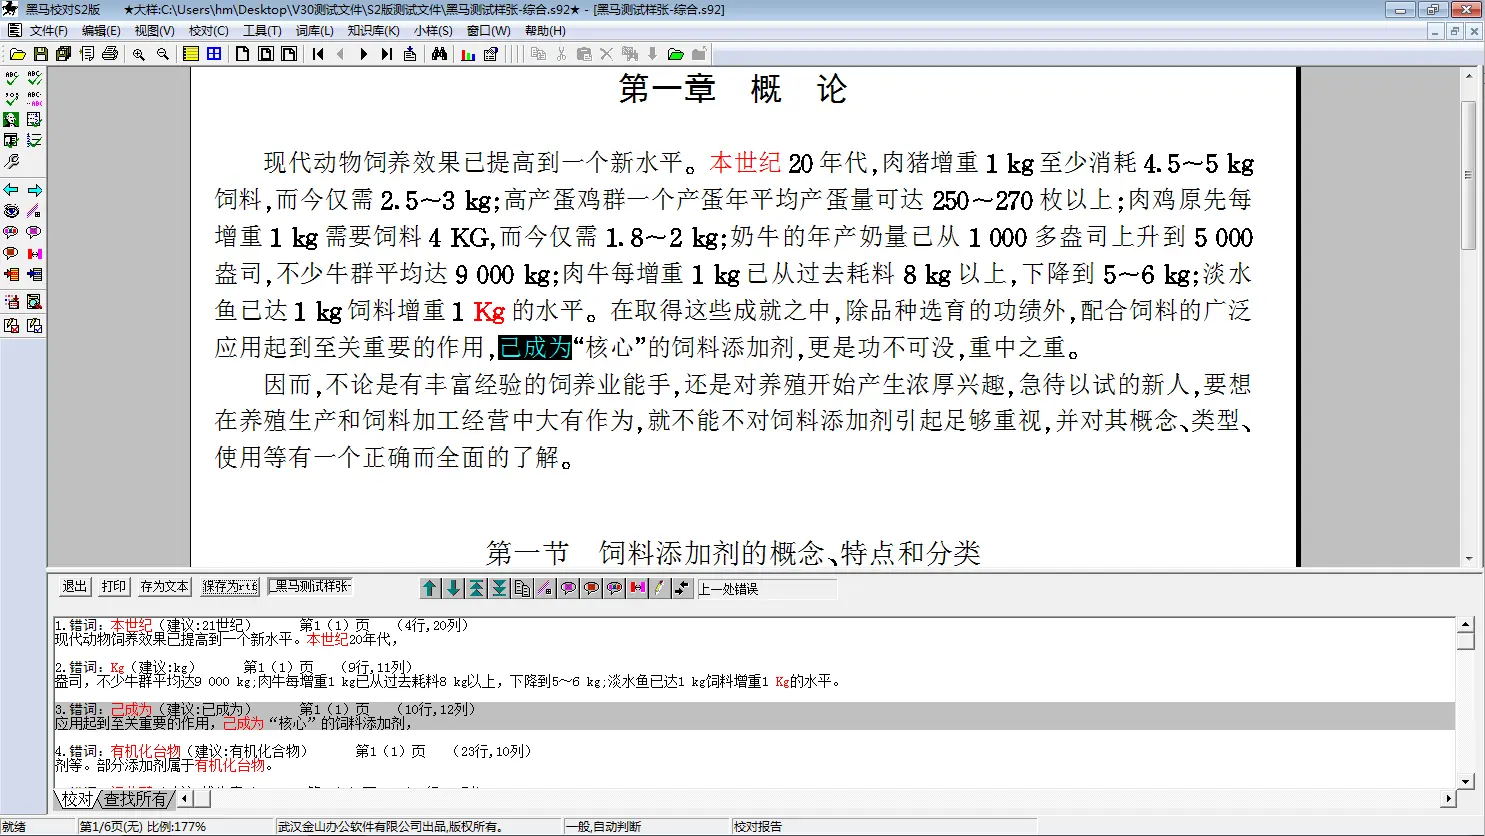
专业领域多音字与特殊文本类型标注存在显著技术难点。首先,人名、地名及专有名词常存在特殊读法,如"单(shàn)于"非"单(dān)于"、"解(xiè)州"非"解(jiě)州",通用NLP模型难以全面覆盖海量专有名词库,即便内置大量数据仍需人工终审确认。其次,古籍整理与辞书编纂面临历史读音沿革复杂性,如"骑"字旧读"jì"与现行"qí"的规范冲突、"说客"之"说"的读音变迁,需严格对照1985年审音表及2023年修订意见,平衡学术传统与现行规范,避免新旧读音混用导致权威性受损。
对外汉语教学场景更呈现独特挑战。非母语学习者依赖拼音建立语音体系,"好(hǎo)不好"与"好(hào)学"等细微差别直接影响教学效果,且需适配HSK分级标注与汉英对照需求,区分日韩学习者易混音。同时,医学、法律等专业领域存在行业特殊读音,如"卒中(cù zhòng)"等术语,通用标注工具缺乏专业词库支撑,难以满足特定领域合规要求。
此外,系统集成中的格式兼容与数据流转亦是常见痛点。采编系统、排版软件与OA系统间缺乏标准接口,多音字标注结果难以与文档版本同步管理,导致"标注-排版-出版"流程脱节,标注数据无法在各业务系统间流转。信创环境下的私有化部署与跨平台适配也增加了技术实施难度,这些问题要求标注系统不仅具备语境分析能力,更需支持自定义词库、某格某式导出及API深度集成,才能实现全流程标准化管理。
基于NLP语义分析引擎的语境智能分析技术,能够自动解析上下文语义关系,精准判断"长(cháng)度"与"长(zhǎng)大"、"行(háng)业"与"行(xíng)走"等高频易混多音字,准确率超99%。系统支持单文档实时标注与多文档批量处理,可一次性完成整本书籍或成批稿件的多音字识别,相较人工标注效率提升10倍以上,且通过多音字分布统计与敏感读音高亮功能,有效避免长文档中的遗漏风险。
针对教育、播音、古籍等专业场景,系统提供行业专属词库管理与标注追溯机制。用户可通过自定义词库添加医学"卒中(cù zhòng)"、法律专有名词等特殊读音规则,企业亦可建立分级分权的多音字标准中心,确保团队标注规范统一。每次人工修正均会被记录至个人词库,通过机器学习算法持续优化后续判断,同时支持标注结果与文档版本同步管理,实现从识别到复核的全流程可控。
在系统集成层面,提供RESTful API与JS SDK,支持Java/Python/C++等多语言接入,可深度嵌入OA、CMS、排版、采编等业务系统,实现实时单句标注与批量异步处理。支持私有化部署与某麟某、统信等信创环境适配,确保数据安全不出内网。标注结果可灵活导出为注音文稿、PDF拼音对照版或Excel统计表,满足出版印刷、有声书制作、对外汉语教材等多样化输出需求,真正实现多音字标注能力与业务流程的无缝融合。
尽管智能标注准确率高达95%以上,但针对人名地名、古籍异读字及专业术语等特殊场景,系统仍提供完善的人工复核机制确保零误差。当遇到"单(shàn)于""解(xiè)州"等专有名词或"说(yuè)客"等古音字时,用户只需双击标注处即可弹出候选读音列表,手动选择正确读音后,系统不仅实时修正当前标注,更通过机器学习算法将此次修正记录至个人词库,后续遇到同类语境自动优先采用用户设定,实现"越用越准"的自学习优化。
系统特别强化了对敏感读音的可视化管理,通过颜色标记与高亮提示区分AI自动判断与人工确认区域,标注结果同步附带判断依据追溯,方便编审人员快速定位"长(cháng)/长(zhǎng)"等易混音的语境逻辑。针对对外汉语、辞书编纂等容错率极低的场景,这种"机器预处理+人工终审"的双轨模式,既保留了智能处理的效率优势,又通过交互式修正确保最终输出符合《普通话异读词审音表》及行业特殊规范。
对于保密单位或需要离线工作的团队,所有人工修正产生的学习数据均可通过本地词库持久化存储,无需联网即可持续优化识别效果,在确保数据安全的前提下,逐步构建起符合本单位特定读音规范(如医学术语、方言读音)的专属智能标注体系。
小学语文教材多音字密度高且零容错,古诗文异读与现代汉语混合场景下人工标注遗漏频发。采用智能语境识别技术批量检查12册860万字书稿,自动标注拼音并适配统编规范。
传统流程中播音员手动标记多音字耗时占备稿时间40%以上,误标导致AI/人工配音返工率高达15%。通过多音字预标注技术自动生成配音脚本,直接进入录制环节。
非母语学习者高度依赖拼音建立语音体系,人工标注疏漏会导致发音固化错误。运用分级标注技术适配HSK大纲,自动提示易混淆多音字并生成配套教学脚本。
多音字标注主要面临语境依赖性强、专有名词误判及系统集成难等挑战。通用模型难以覆盖人名地名(如"单shàn于")、专业术语(如"卒中cù zhòng")及古籍异读等复杂场景,且存在格式兼容与数据流转障碍。建议采用"智能标注+人工复核"双轨模式,通过自定义词库沉淀行业规范,利用机器学习持续优化,并针对保密需求提供离线部署方案,确保教育、出版等场景零误差。

WPS 合同管理,实现合同全生命周期线上化,支持智能起草、审批、电子签章与履约跟踪,确保合规留痕,有效降低法律风险,提升团队协作效率。




WPS 项目管理,提供任务分配、进度看板、甘特图与工时统计,帮助团队高效协同,实时掌控项目全局,确保交付准时、资源均衡。

好生意,智能进销存与营销管理工具,支持手机端快速开单、库存盘点及客户经营分析,帮助小微企业管好生意、提升复购。
WPS 合同管理,实现合同全生命周期线上化,支持智能起草、审批、电子签章与履约跟踪,确保合规留痕,有效降低法律风险,提升团队协作效率。
WPS 项目管理,提供任务分配、进度看板、甘特图与工时统计,帮助团队高效协同,实时掌控项目全局,确保交付准时、资源均衡。

WPS 进销存,一站式管理采购、销售、库存及财务,数据实时同步,助力中小商户精准控货、降本增效,支持多端协同经营。

好业财,专为成长型企业设计的业财一体化管理平台,打通进销存与财务,提供智能记账、多维度报表及税务助手,驱动经营决策。




好会计,智能云财务软件,自动识别发票、一键生成凭证和报表,衔接报税,帮助代账及小微企业财务核算更简单、更合规。
好生意,智能进销存与营销管理工具,支持手机端快速开单、库存盘点及客户经营分析,帮助小微企业管好生意、提升复购。
基于NLP语义分析引擎,自动根据上下文精准判断多音字读音,准确率超99%。
支持单文档实时标注和多文档批量处理,一次性完成整本书籍或成批稿件的识别。
内置教育、医学、法律等专业词库,并支持自定义特殊读音规则,沉淀企业读音规范。
提供高亮提醒、候选读音选择与自学习修正记录,机器预标与人工终审协作,确保权威。
标注结果可一键导出为注音文稿、PDF拼音对照表或Excel统计,满足出版、播音等需求。
通过RESTful API与JS SDK,将标注能力嵌入OA、排版、采编等系统,支持信创环境部署。
语义引擎精准识别语境,批量处理效率提升10倍,支持专名词库与离线部署,让出版、教育、播音文稿零差错。
