

WPS 协作
支持多人实时协同编校,集成智能校对能力,确保团队文档内容安全合规,有效防范文字差错风险。
支持多人实时协同编校,集成智能校对能力,确保团队文档内容安全合规,有效防范文字差错风险。

构建专业术语库与差错案例库,支持出版行业知识管理,实现内容规范标准化管控与全链路追溯。

基于NLP的专业校对系统,精准识别字词混淆、政治性差错及知识性硬伤,保障出版内容安全零失误。

自动化管理审校流程与数据逻辑,支持古籍、医学等专业出版项目的精细化进度与质量管控。

远程编校协作与内容评审平台,支持屏幕共享实时标注差错,实现边讨论边修改的高效审核模式。
文字差错主要包括字词混淆(形近字、音近字、同音字)、政治性差错(领导人姓名职务、敏感词)、知识性硬伤(术语、引文、计量单位)及语法逻辑缺陷。WPS黑马校对基于NLP深度学习技术,内置千万级词库与实时政治术语库,提供错别字识别、敏感词检测、政治性差错拦截及专业术语校对,支持媒体、出版、法律、医学等多行业场景,实现秒级实时校对与离线部署,常见错别字识别率达99%以上,有效降低内容安全风险。
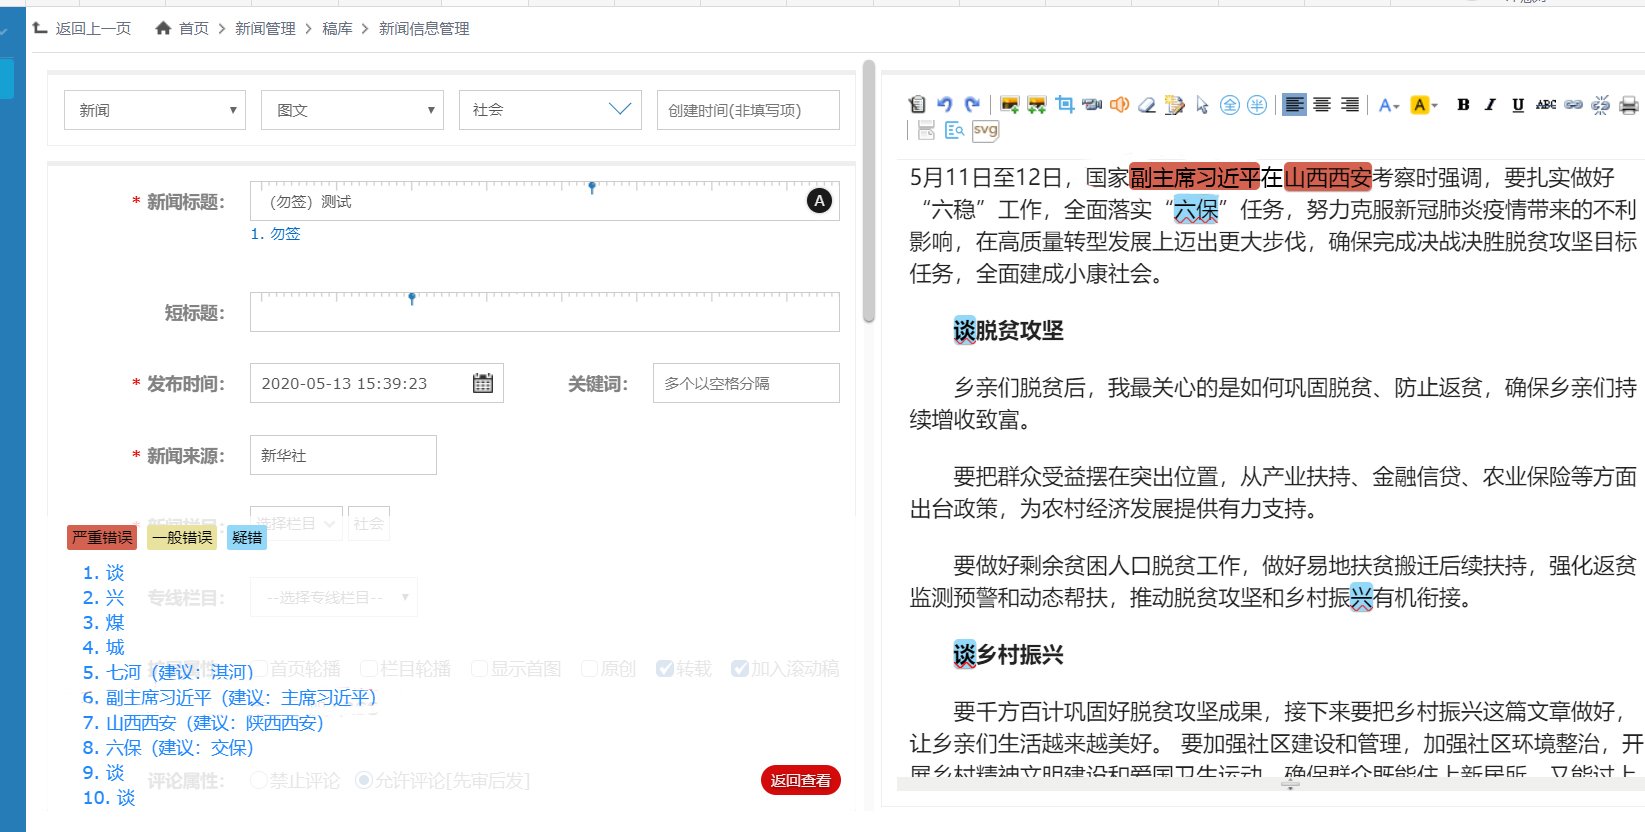
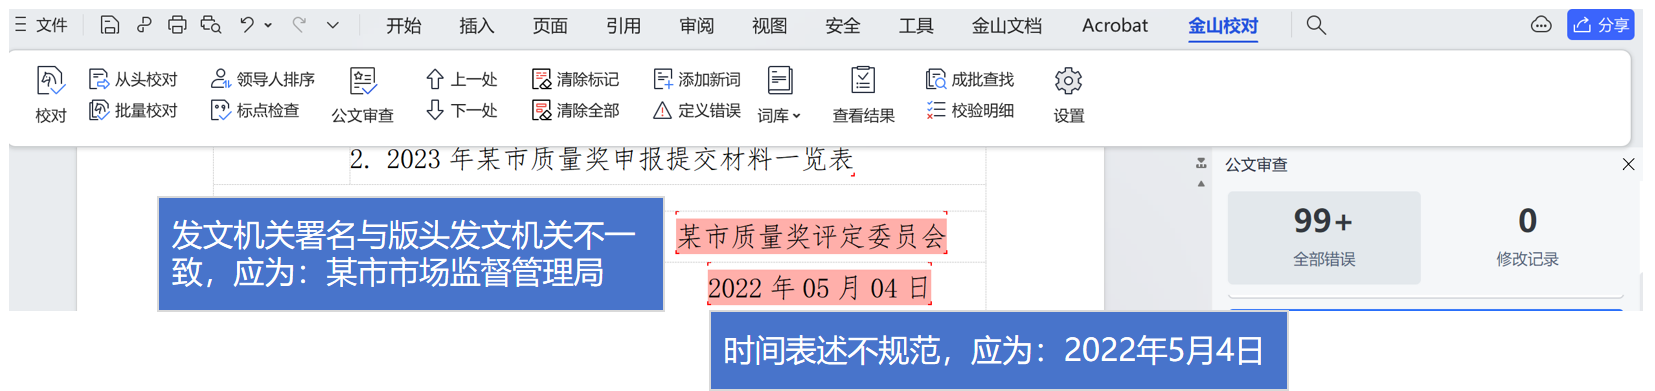
文字差错类型常见问题有哪些?从内容安全与出版规范角度,主要包括字词混淆、政治性差错、知识性硬伤及语法逻辑缺陷四类。字词层面高发形近字(如"戊/戌/戍")、音近字(如"作/做")及同音字(如"的/得/地")混用,同时存在多字漏字、繁简异体字转换错误;政治性差错涉及领导人姓名职务排序不当、敏感词违规及政治术语表述不规范;专业领域则常见计量单位混用(如"千米/公里")、历史人名地名错误、成语典故引文张冠李戴;语法逻辑方面包括病句成分残缺、前后时间矛盾、指代不明及搭配不当(如"提高水平"误用)。
针对这些问题,基于NLP技术的智能校对系统提供全链条检测方案。系统结合上下文语义精准识别"的得地"等高频混淆,通过权威政治词库实时校验敏感表述,依托专业知识库核查术语与引文准确性,并运用深度学习模型识别逻辑矛盾与语法病句,同时支持标点符号、数字日期格式规范检查。在WPS 365平台中,基础文字检查功能包含在商业协作版内,而深度智能校对、敏感词实时监测及专业术语库等高阶能力需升级某商某业高级版或商业旗舰版,部分专业模块亦可通过加价购或联系销售单独开通,以满足媒体、出版、法律等行业的高标准内容安全需求。
不同行业因业务特性差异,面临的文字差错类型呈现显著分化。新闻传媒领域时效性极强,高发"同音形近字"输入错误(如"作做""未末"混淆)及政治性表述风险,领导人姓名职务排序不当、敏感词违规、政治术语更新滞后等问题尤为突出,夜班编辑疲劳导致的漏检常引发严重舆情危机。
专业出版领域则聚焦深度知识性硬伤,医学出版物易现拉丁文药名拼写错误、化学符号格式混淆、计量单位不统一;古籍整理面临繁简转换失真、异体字讹变、历史人名地名同音异写等难题;法律财经文本要求法条引用精准到款项,合同金额数字差错、财务数据逻辑矛盾可能引发巨额经济损失或法律效力瑕疵。
相较于通用错别字,这类专业差错具有隐蔽性强、后果严重的特点。传统校对难以覆盖跨领域知识盲区,而基于深度学习的智能系统通过构建细分行业词库(如千万级医学术语库、实时更新的法条库、古籍专库),可实现对专业符号、引文出处、历史纪年、金额一致性等深度差错的精准识别,从源头防范行业特有风险。
传统基于规则的校对工具仅能识别显性拼写错误,而现代智能校对系统基于Transformer架构的深度学习模型,实现了从"字面匹配"到"语义理解"的跨越。系统通过上下文语义分析,不仅能精准识别"的/得/地"等高频混淆,更能发现"权利/权力"等深层语义错误,以及跨段落的人名指代不一致、时间线逻辑矛盾等复杂问题。结合千万级基础词库与百万级专业术语库,系统对常见错别字识别率达99%以上,且能随着用户反馈持续优化,实现"越用越准"的个性化适配。
针对新闻传媒"秒级"发稿需求,系统提供实时校对插件,可无缝嵌入WPS、采编系统及CMS发布平台,实现"边写边校、即发即审",批量文档扫描可在秒级定位全篇差错。同时支持多终端协同校对与API深度接入,满足融媒体中心多平台分发的统一审核需求,在重大报道期间提供7×24小时云端稳定服务。
在数据安全方面,系统支持本地化离线部署,所有校对在本地完成,无需联网传输敏感内容。政治术语库与敏感词库采用加密存储,配合加密锁授权机制,确保涉密单位、政务机关及金融机构的内容数据零泄露风险。用户还可自定义白名单与行业专词库,在保障合规的同时适配个性化业务场景,构建安全高效的内容生产闭环。
在实际应用中,智能校对系统已形成可量化的行业价值标杆。某省级古籍出版社借助专用版本整理地方志丛书,引文核对时间缩短三分之二,精准识别异体字与历史人名错误;某权威医学出版社审校《中华药典》配套图书时,拉丁文药名与计量单位差错率降至历史最低;而中央级新闻门户网站接入实时插件后,内容差错率下降90%以上,夜班编辑负担显著减轻。这些案例印证了系统对专业符号、引文出处、政治性表述的深度识别能力,真正实现了“秒级拦截”与“零失误”保障。
除核心的中文校对能力外,系统还覆盖英文拼写检查、成语误用识别、数字日期格式规范等全维度文本质量管控。用户可通过自定义词库导入行业术语、专有名词,使系统越用越准;同时支持离线部署与加密锁授权,确保涉密单位数据零泄露。试用版已开放错别字、标点、政治性差错等核心功能,正式版则解锁深度语义分析、批量文档处理及API接入能力,为媒体、出版、法律、金融等行业构建从内容生产到发布的全链条安全防护体系,在保障合规的同时释放专业人力,实现质量与效率的双重跃升。
重大会议报道中,同音字混淆与政治性差错频发,夜班编辑疲劳漏检严重。接入实时校对插件,嵌入采编系统,实现错别字与敏感词秒级拦截,边写边校不误发稿。
整理大型地方志丛书时,繁简转换失真、异体字讹误、历史人名地名错误频出,人工引文核对耗时极长。采用古籍专版,依托权威专库自动核对。
审校《中华药典》配套图书时,拉丁文药名拼写易错,计量单位不统一,专业差错风险高。应用医学版智能校对,深度核查术语与符号规范。
文字差错主要包括字词混淆(形近、音近、同音、繁简转换)、政治性差错(领导人信息、敏感词)、知识性硬伤(专业术语、计量单位、历史人名)及语法逻辑缺陷四类。不同行业风险各异:新闻传媒高发政治性表述与同音字错误,专业出版易出现医学符号、古籍异体等深度差错。建议采用基于NLP的智能校对系统,通过深度学习实现语义级检测,结合行业专库与实时更新机制,可有效降低90%以上差错率,同时支持离线部署保障数据安全,实现从基础错别字到专业知识的全面防控。

内置智能校对引擎,自动识别法律术语误用、金额不一致及条款歧义,确保合同文本零差错,符合出版级内容安全标准。




搭载实时校对插件,快速发现营销文案错别字、合同条款漏洞与敏感词,边写边校,维护品牌专业形象与商业安全。

集成深度语义分析,精准校对项目文档中的逻辑矛盾、时间线错误及专业术语,保障项目计划与报告的准确高效。

业财文档智能校对,自动校验业务单据与财务报表间的数据勾稽关系,识别逻辑矛盾,助力企业实现内容驱动的精准风控。




依托NLP核心技术,智能审校财务凭证与报表,识别金额差错、科目混淆及规则冲突,严防财务文档数据风险,提升合规性。
搭载实时校对插件,快速发现营销文案错别字、合同条款漏洞与敏感词,边写边校,维护品牌专业形象与商业安全。
内置智能校对引擎,自动识别法律术语误用、金额不一致及条款歧义,确保合同文本零差错,符合出版级内容安全标准。

支持批量文档校对,自动检测进销存报表中的数字格式、总量计算错误,结合行业术语库确保业务单据规范,降低人工成本。
集成深度语义分析,精准校对项目文档中的逻辑矛盾、时间线错误及专业术语,保障项目计划与报告的准确高效。
结合上下文语义,精准识别同音形近字错误,避免写作尴尬。
内置权威政治词库,自动预警涉政不规范表述,防范内容风险。
对接权威知识库,统一计量单位、科技名词,确保术语准确。
核查引文出处与原文一致性,避免知识性硬伤,提升专业度。
识别搭配不当、指代不明,推荐修改建议,让文稿更通顺。
无缝嵌入WPS与采编系统,边写边校,大幅提升审核效率。
深度融合NLP技术,精准识别形近字、政治性差错、知识硬伤与语法逻辑缺陷,支持实时校对与离线部署,护航专业内容零差错。