

WPS PDF
支持古籍扫描件OCR识别与竖排文本解析,解决生僻字乱码显示问题,提供超大字库挂接,确保数字化文本完整可读。
支持古籍扫描件OCR识别与竖排文本解析,解决生僻字乱码显示问题,提供超大字库挂接,确保数字化文本完整可读。

支持多人协作审校与版本比对,自动核对引文出处,智能规范专名号书名号体例,提升百万字级古籍整理效率。

专为古籍整理设计,智能识别避讳字、异体字、通假字,支持超大字符集与竖排文本解析,符合《古籍校勘整理规范》。

支持编校审读外审多环节远程协作,高清传输古籍扫描图像,实时沟通体例规范,确保整理标准统一与出版质量。

支持古籍大文件安全传输与版本管理,确保数字化成果在内外网隔离环境下高效流转,满足信创环境部署需求。
古籍整理面临繁简混用、异体字避讳字识别困难、竖排版式解析复杂等挑战。WPS黑马校对古籍专用版提供超大字符集支持、历代避讳字库与异体字库挂接,实现引文自动核对、竖排文本解析、缺笔字避讳字识别,适配OCR后处理与数字化加工流程,符合《古籍校勘整理规范》,已服务国家级古籍整理工程、图书馆数字化项目及高校古籍研究所,显著提升校勘效率与出版质量。
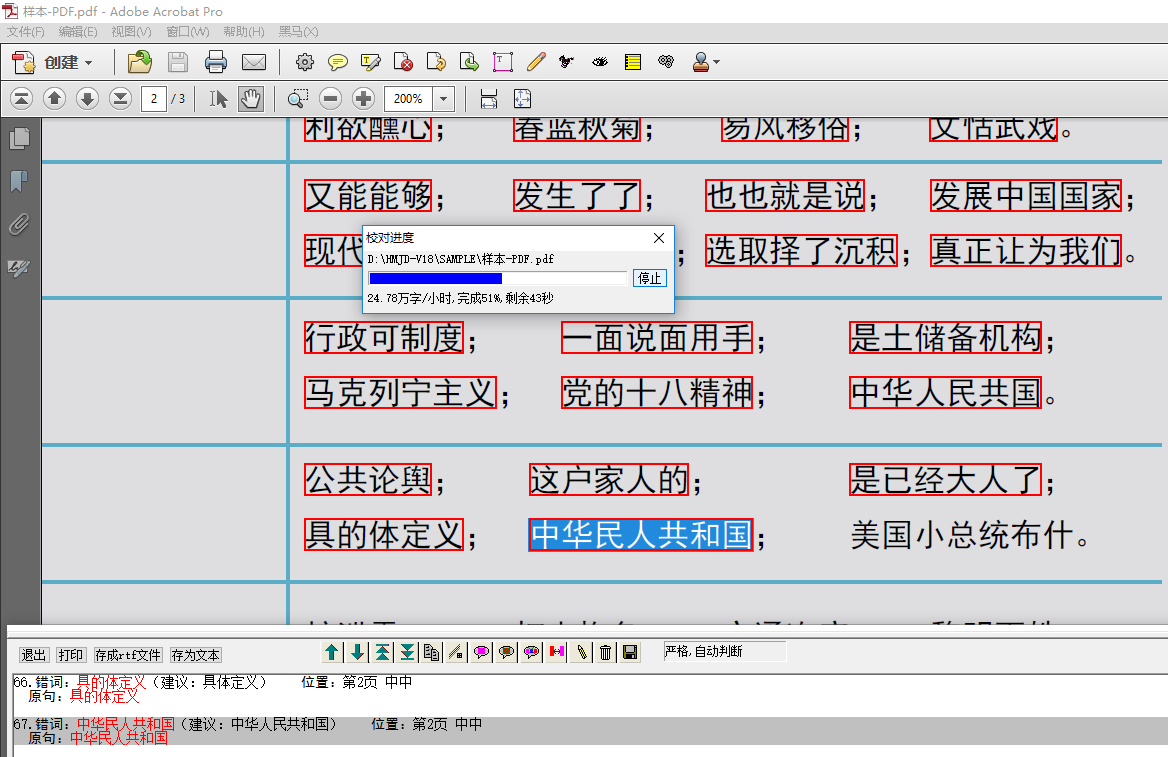
古籍校对面临繁简混用、异体字误报、避讳字与缺笔字识别及竖排版式解析等多重挑战。历代避讳字库、古今通假字规则及超大字符集支持是降低误报率的关键,而引文核对、版本比对与干支纪年换算更需专业工具辅助。由于默认知识库基于现代汉语,常规软件常将古籍专名线、书名号误判为错误,且对生僻字显示为乱码或方框,竖排文本转换格式后更易影响校对准确率,严重影响审校效率。
针对上述痛点,WPS 365商业旗舰版(599元/人/年)提供完整AI Hub与开放接口能力,支持竖排文本解析、API嵌入OCR后处理及文档接口调用,适合需要古籍数字化系统集成的机构;商业高级版(399元/人/年)提供日志审计与基础文档接口,可满足一般性审校需求。需要特别说明的是,古籍超大专用字库挂接、历代异体字深度比对、引文自动溯源及避讳字专项审查等专业功能通常需联系销售开通或作为行业解决方案加价购买,体验版及商业协作版(199元/人/年)仅支持基础文档协作,不具备处理繁异体字与避讳字的专业审校能力。
某国家级古籍整理工程在实践中,通过部署具备超大字符集支持的专业系统,成功解决卷帙浩繁导致的校勘周期冗长问题,繁异体字识别与版本比对难题得到显著改善,引文核对准确率大幅提升。建议机构根据典籍规模选择服务:涉及大规模数字化加工且需符合《古籍校勘整理规范》的学术出版项目,应选用商业旗舰版并配套专业字库模块;而对于仅需基础文本处理的用户,需注意通假字与古今字识别仍需自建词库并人工复核,以确保典籍出版内容的权威性与准确性。
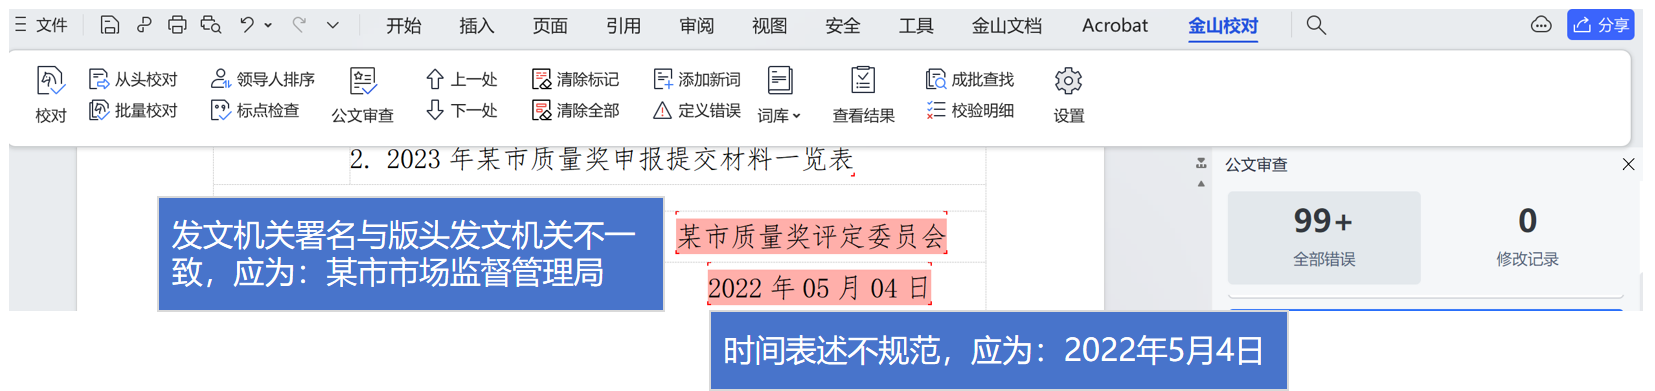
地方志与谱牒文献整理面临古今地名沿革复杂、干支纪年换算易错、生僻异体字众多等挑战,且世系交叉引用繁多,人工核查难度极大。某省级方志办在组织编纂历代地方志集成过程中,通过部署专业审校系统,精准解决年号干支换算与古今地名对照难题,大幅提升生僻字识别准确率,严格检查避讳字使用规范,全面提升了志书编纂质量与出版效率,确保成果符合国家级标准。
高校古籍研究所与学术出版社在处理经典释读著作时,需应对海量引文核对、注释体例统一及专名号规范使用等繁琐工作。依托引文大数据自动溯源与学术体例智能规范功能,系统实现古籍专名号、书名号合规检查与注释格式标准化,有效辅助百万字级古籍注释著作的整理出版,确保引文出处精准无误,显著提升学术出版的严谨性与权威性。
针对图书馆古籍数字化中心与OCR加工团队,专业系统提供残缺模糊字形智能判别、繁简混排自动规范化及复杂版式结构还原能力,支持百万页级批量质检与信创环境私有化部署。某国家级图书馆在珍贵古籍数字化保护工程中,通过字形比对技术大幅降低残字误判率,实现Unicode字符集编码统一,确保数字化成果准确可用,为数字人文研究奠定高质量数据基础。
针对古籍生僻字、俗字、讹字及Unicode未收录古文字的显示与识别难题,专业系统通过一键挂接《汉语大字典》《中华字海》等权威字形库,构建涵盖历代异体字、避讳字、缺笔字的超大字符集支持体系。系统可自动适配先秦至明清各时期文本特征,对字形变异、讹变字形进行智能比对与校正建议,同时支持自定义古籍专名字库(人名、地名、年号),彻底解决OCR识别结果中因字库缺失导致的乱码与方框问题,确保数字化文本的完整性与可读性。
在系统集成层面,通过提供标准API接口与SDK开发工具包,专业审校能力可无缝嵌入OCR后处理流程与数字化加工平台,支持竖排文本智能解析、繁简混排自动规范化及残字缺字智能标记。系统全面适配信创环境(某麟某、统信、某芯某、某腾某),支持私有化部署,确保古籍数据不出内网。相较于纯人工校勘,该技术方案使避讳字审查、异体字规范等工作效率提升数十倍,且通过统一《古籍校勘整理规范》审查标准,实现从扫描识别到出版发布的全流程质量管控。
某出土文献研究中心在整理战国秦汉简牍时,借助超大字符集挂接与字形比对技术,成功识别大量俗字与讹变字形,结合API接口与现有数字化平台对接,实现了残字缺字的智能标注与编码统一,显著提升了出土文献整理的标准化水平与出版效率。
古籍整理出版往往涉及编校、审读、外审等多环节协作,传统模式下版本传递频繁易导致体例混乱,且通假字、古今字识别需结合语境人工判断,单靠自动化规则易生谬误。针对古籍专名线、书名号等特殊标某易某被通用软件误判为错误符号的问题,专业系统支持装饰性排版标记智能识别与忽略,同时严格检查专名号、书名号规范使用情况,确保人名、地名、书名标注符合《古籍校勘整理规范》。
在通假字与古今字处理方面,系统内置历代通假字库与古今字对照表,提供智能识别标注与人工复核双重机制,有效降低"以今律古"的误改风险。针对校勘记撰写繁琐的痛点,系统支持版本差异自动比对与校勘记格式自动生成,大幅提升整理效率。某重点高校古籍整理研究所在整理历代注释著作时,依托协作审校功能实现多人分段校对与体例统一管控,结合引文自动溯源确保百万字著作中学术引证精准无误,显著提升了典籍出版的严谨性与权威性,为古籍出版社、高校古籍所等学术机构提供了标准化、高效率的数字化整理解决方案。
典籍卷帙浩繁,人工校勘周期极长,且繁异体字、通假字识别难度大,版本比对易遗漏。通过部署超大字符集与AI校勘系统,实现异体字自动规范、版本差异智能比对和引文自动溯源。
古今地名沿革复杂、干支纪年换算易错,生僻异体字与避讳字人工审核风险高。采用方志谱牒专用词库与纪年换算智能校对,实现地名自动核对、干支合规检查和避讳字严格审查。
OCR识别繁简混用、版式复杂导致错误率高,残字缺字误判严重,海量质检成本高昂。引入AIOCR纠错引擎与字形比对技术,实现残缺字精准判别、繁简混排自动规范化及批量质检。
古籍校对面临生僻字乱码、异体字与避讳字识别困难、竖排版式解析失真、繁简混排误判等挑战,常规软件基于现代汉语常误报专名线、书名号,且难以处理通假字、古今字及引文核对。建议选用支持超大字符集(如《汉语大字典》)的专业系统,通过API嵌入OCR后处理,结合自定义词库与人工复核,实现残字智能判别、避讳字审查及版本比对,有效降低误报率并保障出版质量。

专为古籍出版机构设计的智能财务管理工具,支持项目预算管控、费用报销与成本核算,与WPS 365深度协同,实现古籍整理经费的精细化、合规化管理,提升财务流程效率。




面向古籍出版社的进销存管理专家,无缝对接WPS文档处理,实现古籍出版物、线装书等库存管理、销售追踪与订单协同,助力古籍发行环节降本增效。

智能会计软件,适配古籍整理项目经费核算与审计需求,支持多账套管理,与WPS 365集成,为古籍数字化工程提供合规、高效的财务数据保障。
专为古籍出版机构设计的智能财务管理工具,支持项目预算管控、费用报销与成本核算,与WPS 365深度协同,实现古籍整理经费的精细化、合规化管理,提升财务流程效率。

帮助古籍书店、文化机构管理图书进销存与客户关系,与WPS办公套件无缝衔接,实现古籍文献及衍生品的线上线下销售一体化,拓展古籍传播渠道。
智能会计软件,适配古籍整理项目经费核算与审计需求,支持多账套管理,与WPS 365集成,为古籍数字化工程提供合规、高效的财务数据保障。

基于WPS文档协作的古籍合同管理专家,支持版权协议、数字化加工合同的审批、归档与履约跟踪,确保古籍出版合作规范,降低法律风险。




专为古籍整理工程打造的项目管理平台,支持校勘任务分配、进度追踪与多人协作,与WPS 365深度集成,实现编校流程数字化管控,提升典籍出版效率。
面向古籍出版社的进销存管理专家,无缝对接WPS文档处理,实现古籍出版物、线装书等库存管理、销售追踪与订单协同,助力古籍发行环节降本增效。
专名号、书名号合规检查,避讳字自动识别,大幅提升校勘效率与准确性。
一键挂接超大字符集,智能识别残字俗字,确保数字化成果准确可用。
干支纪年自动换算,古今地名对照,生僻字与避讳字严格审查,提升志书质量。
海量引文大数据核对,自动生成校勘记,确保学术引证精准无误。
API嵌入数字化流程,支持竖排解析和批量质检,实现数据安全不出内网。
超大字符集适配战国秦汉简牍,智能标注残字缺字,提升整理标准化水平。
专为古籍整理打造,内置超大字符集与历代避讳字库,支持竖排解析、繁异体字比对,助您高效完成合规出版。