

AIPPT
将古籍OCR结果与研究资料一键生成学术PPT,方便课堂展示与论文汇报,让典籍研究成果可视化呈现。
将古籍OCR结果与研究资料一键生成学术PPT,方便课堂展示与论文汇报,让典籍研究成果可视化呈现。

支持古籍文献中外互译及现代汉语转写,辅助处理涉外学术资料,让传统典籍研究跨越语言边界。

搭建古籍数字化审校流程与项目进度表,实时跟踪OCR识别、人工校对及签章确认,提升团队协作效率。

内置古籍OCR引擎,支持繁体竖排识别、双层PDF生成、批注签章与权限加密,覆盖从扫描到归档的全流程。

基于识别文本辅助撰写古籍解题、学术报告与考古著录,快速生成研究大纲,释放文史学者创作力。
针对古籍扫描件无法检索、繁体竖排及生僻字识别困难等痛点,WPS PDF提供内置古籍OCR引擎,支持繁体竖排文字提取、生僻字校对、双层PDF生成、页面整编与数字化签章保护。适用于图书馆、高校、出版社及博物馆,通过单本试做到批量上线的标准化流程,在本地安全环境下完成古籍扫描识别、审校订正与版权管理,替代专业OCR与排版工具,显著降低数字化建设与运维成本。
上手古籍文字识别,可直接在金山PDF中调用古籍优化OCR引擎处理扫描文献。将书叶图像或图片型PDF导入后,切换至繁体竖排识别模式,引擎会自动调整阅读方向并提取文字,输出可检索、可复制的双层PDF;面对生僻字与异体字,建议识别后对照原图逐字校对,以提升还原精度。如需批量处理,可先用页面整编功能合并多卷文献、智能裁剪扫描黑边,再按卷次拆分或插入补遗页,快速完成数字化前整理。
在机构部署层面,WPS 365企业用户可根据规模选择对应套餐:商业高级版399元/人/年提供PDF工具与365GB/人存储,商业旗舰版599元/人/年则含2TB/人存储及更完整的组织管理能力;但古籍专项签章、深度版权保护及部分专业OCR功能可能需联系销售开通或加价购买,WPS电子签等模块亦不包含在基础套餐内。某省级图书馆与某古籍出版社的应用实践表明,基于该体系可在本地安全环境下完成古籍扫描、识别与审校,有效降低多软件切换与运维成本,提升数字化加工效率。
识别提取只是古籍数字化的第一步,后续的审校订正、签章确认与版权管理才是成果定型的关键。在高校文史哲教学科研中,师生完成OCR识别后,可直接在PDF内对繁体竖排原文添加批注与修订标记,将识别结果转换为可编辑文稿或PPT课件,方便论文引用与课堂展示;学位论文指导环节,导师通过手写签名或文字签名完成审校确认,省去纸质稿本往返寄送的时间。
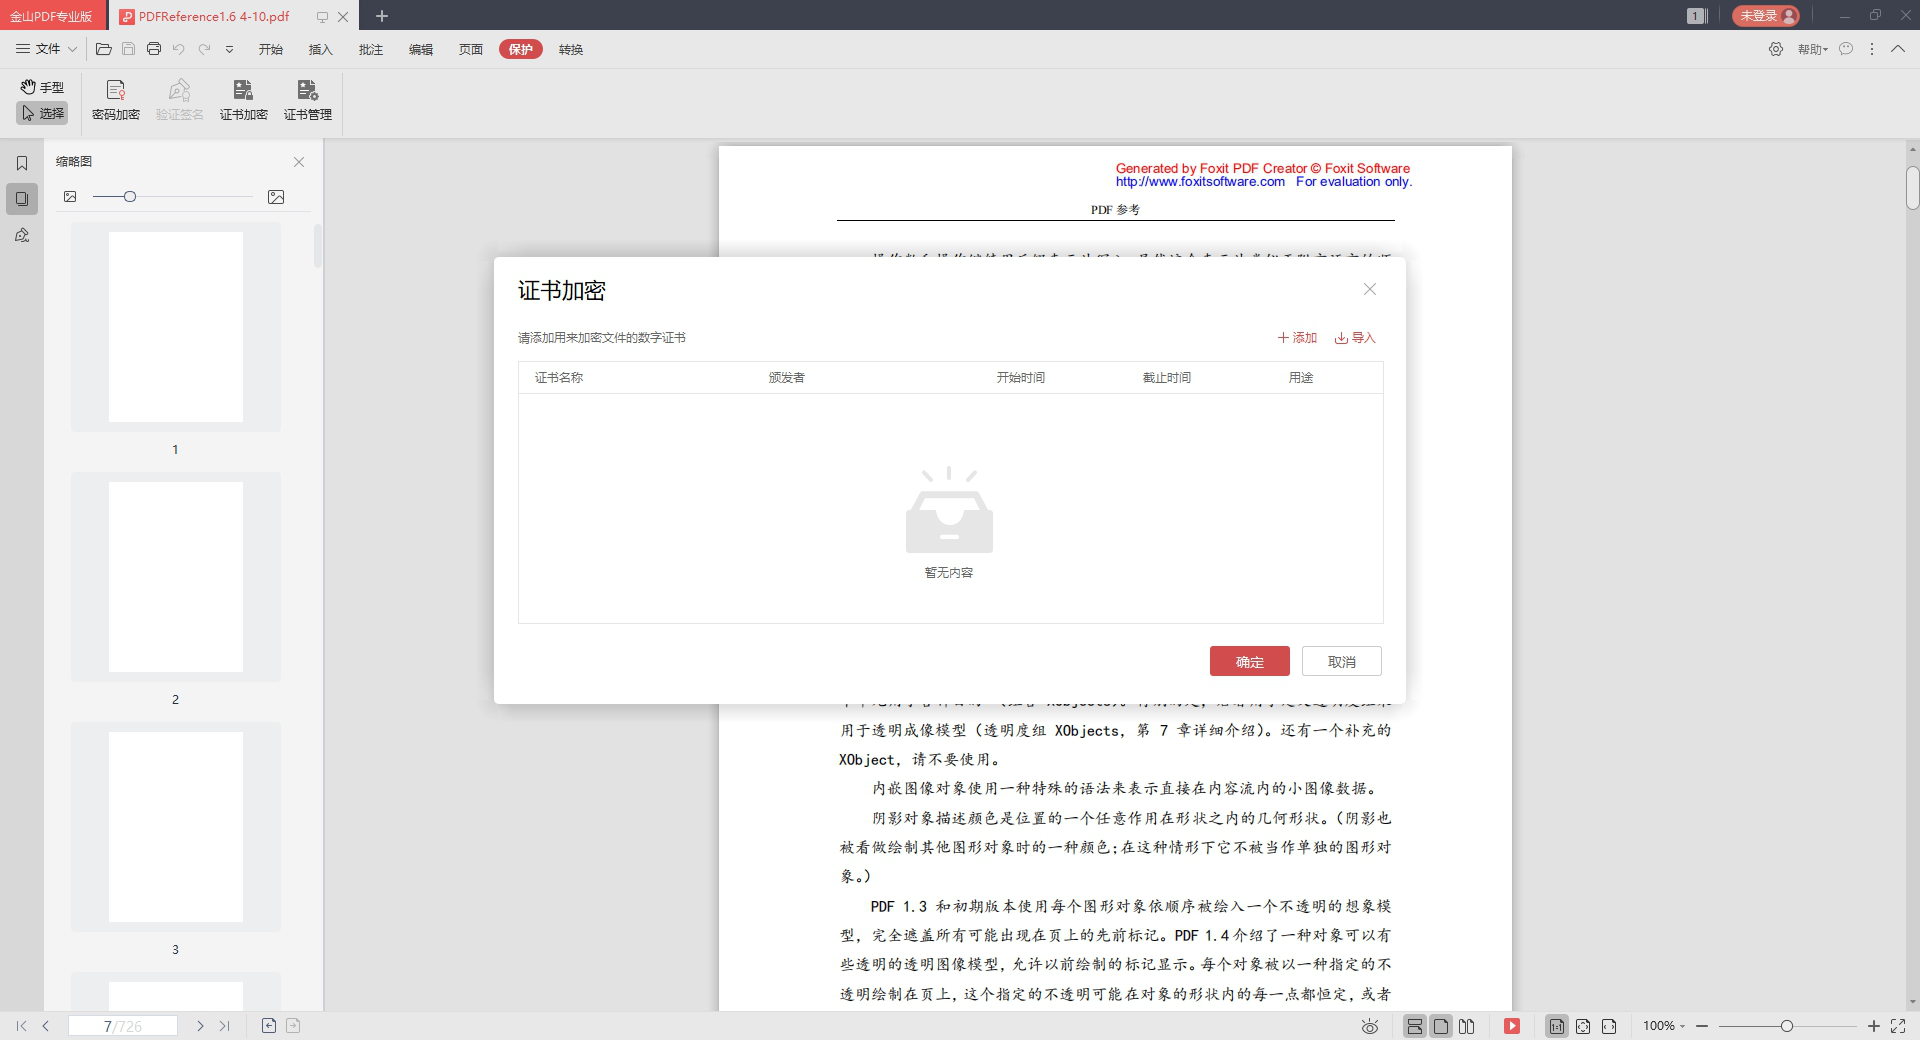
面向图书馆、博物馆等机构,金山PDF提供图片签章与权限加密双重保护:可将馆藏章、版权章自由拖拽定位加盖,并设置打开密码与操作权限,限制编辑、复制及打印,防止珍贵古籍影像与文本层非法传播。针对博物馆拓片、简牍等出土文献,研究员更能在纯本地环境中完成高清扫描、特殊字形释读批注与考古报告协同编写,全程数据不上云,既保障文物数字资源安全,又满足学术著录的严谨要求,真正实现从文字识别到成果归档的闭环管理。
对于承担大型古籍整理、方志汇刊或辞书编纂项目的出版机构与文保单位,数字化质量直接决定成书水准与学术价值。在金山PDF的古籍OCR工作流中,编辑可先于识别阶段对泛黄残页执行去污、色差调整与纠偏处理,再结合竖排版框还原与繁体字库智能匹配,最大限度降低生僻字、异体字的误识率;审校环节内嵌批注与电子签名能力,责任编辑、特约编审与排版设计可在同一PDF文件上完成三审三校与付型确认,省去纸质稿本往返与多系统切换的损耗。
在国产化替代与成本控制层面,该体系相较某国际软件巨头具有显著的中文古籍专项优势:竖排识别引擎与繁体字库深度适配,双层PDF生成速度更快,且原生支持国产操作系统与Windows混合部署,满足教育及文保领域自主可控要求。某古籍出版社的实践表明,采用WPS 365内置古籍识别能力后,无需额外采购专业OCR与排版软件,一套账号即可覆盖从底本扫描、文字提取到印刷级PDF输出的全生产链,整体IT投入与项目管理成本均大幅下降。
面向博物馆、考古所等机构的青铜铭文、某石某拓片与简帛文献,高清图像识别与特殊字形提取同样可在本地安全环境下完成。研究员不仅可对残缺字形进行释读批注,还能通过团队在线协作编研功能同步推进考古报告撰写,配合统一的权限管理与文档加密,确保珍贵文物数字资源在流转过程中的完整性与保密性,真正实现高质量、低成本、自主可控的古籍与出土文献数字化治理。
对于初次接触古籍数字化的机构,建议采用"单本试做—模板定型—批量上线"三步走策略快速上手。首阶段选取一至两种典型书叶,在金山PDF中完成图像去噪、纠偏与裁边预处理,切换至繁体竖排识别模式并针对生僻字、异体字进行逐字比对,确认版式还原度与识别准确率后再定型参数模板,避免大规模返工。
进入批量加工阶段后,可依托页面整编功能合并分散的多卷书叶、统一裁剪扫描黑边,并按卷次或回目自动拆分文档。针对地方志办公室、档案馆文献部处理的多卷本、丛书类文献,可预设馆藏水印、版权说明章与识别参数,实现"导入—识别—签章—导出"流程的标准化复用,显著降低数字化专员的学习成本与操作门槛。
成果验收环节需建立人工抽检与逐字校对机制,重点核查版心偏移、竖排断句及特殊字形误差,确认无误后输出双层PDF或纯文本格式,直接对接图书馆古籍数据库、档案馆文献管理系统或出版社排版平台。整个过程在本地环境完成,无需上传云端,既保障珍贵古籍影像安全,又满足古籍数字化工程长期保存与开放检索的双重标准。
馆藏善本扫描件无法直接检索编辑,人工誊录易出错,多软件切换导致流程断裂。引入WPS PDF古籍OCR后,直接对扫描版PDF进行竖排繁体识别与双层PDF生成,统一平台完成扫描、识别、校勘与归档,打破工具孤岛。
师生论文引用与课件制作需频繁处理繁体竖排扫描古籍,传统PDF无法识别文字,批注审阅与格式转换繁琐。部署WPS 365教育版,在PDF内直接识别、批注、转换古籍内容,教学资料一键整理并生成课件。
底本转电子文稿需单独采购专业OCR与排版工具,多软件管理复杂,出版周期长。将WPS PDF古籍识别作为内置能力,编辑直接提取文字、校对并输出印刷级PDF,替代第三方工具,覆盖全社古籍整理与辞书编纂。
建议采用“单本试做—模板定型—批量上线”三步策略上手古籍OCR。首阶段选取典型书叶,在金山PDF中完成去噪、纠偏、裁边,切换繁体竖排模式,对生僻字与异体字逐字比对,确认版式后定型参数模板。批量阶段利用页面整编合并多卷书叶、裁剪黑边并按卷次拆分,预设签章与识别参数,实现标准化复用。全程本地处理并输出双层PDF,既保障古籍影像安全,又降低数字化门槛与成本,实现从识别到归档的高效闭环。

基于WPS PDF电子签章与全文检索能力,实现合同起草、审批、归档全流程数字化管理,支持多层权限管控,有效降低合规风险与纸质流转成本。




与WPS PDF无缝协同,智能识别发票、银行回单等财务凭证,自动生成凭证与报表,支持电子归档,助力小微企业财税合规与成本管控。

借助WPS PDF单据识别与归档能力,实现进销存业务全链路数字化,自动生成销售、采购、库存报表,提升商贸企业管理效率与决策精度。
基于WPS PDF电子签章与全文检索能力,实现合同起草、审批、归档全流程数字化管理,支持多层权限管控,有效降低合规风险与纸质流转成本。

结合WPS PDF标注与协同审阅功能,实现项目计划、任务、文档的一体化管理,团队成员可在线批注与签章确认,提升项目交付透明度。

利用WPS PDF智能识别与表单归档特性,完成采购、销售、库存单据的数字化闭环,支持移动端扫码录单,轻松实现小企业业务在线化。

与WPS PDF深度集成,实现业务单据到财务凭证的自动生成,支持自定义报表与多维度经营分析,助力成长型企业业财一体化管理。



与WPS PDF无缝协同,智能识别发票、银行回单等财务凭证,自动生成凭证与报表,支持电子归档,助力小微企业财税合规与成本管控。
借助WPS PDF单据识别与归档能力,实现进销存业务全链路数字化,自动生成销售、采购、库存报表,提升商贸企业管理效率与决策精度。
切换繁体竖排模式,自动调整阅读方向,提取文字生成可检索、可复制的双层PDF。
识别后对照原图逐字比对异体字、生僻字,提升文字还原精度与学术可靠性。
批量合并多卷书叶,智能裁剪扫描黑边,按卷次或回目灵活拆分并插入补遗页。
手写签名或图片签章自由拖拽定位,完成审校确认与馆藏责任签署,省去纸质流转。
设置打开密码,限制编辑、复制及打印,保护珍贵古籍影像与文本层不被非法传播。
全程本地处理不上云,按“单本试做—模板定型—批量上线”策略快速复制加工流程。
金山PDF内置古籍OCR引擎,支持繁体竖排识别、本地签章加密与协同审校,从扫描到归档安全高效。