

WPS 黑马校对
智能错别字检测,精准识别同音、形近、音近错字,支持OCR修复与专有名词校验,为政企出版提供99.5%差错检出率的专业保障。
智能错别字检测,精准识别同音、形近、音近错字,支持OCR修复与专有名词校验,为政企出版提供99.5%差错检出率的专业保障。

一站式智能办公平台,集成黑马校对等专业工具,助力企业实现从文档创作到质量管控的全流程数字化升级。

高效处理PDF文档,支持扫描件识别与文字提取,配合智能校正功能,轻松还原准确文本内容。

AI驱动文档翻译,精准处理多语言内容,确保专有名词与行业术语翻译规范,助力全球化内容生产。

轻量化在线办公组件,支持多平台嵌入与二次开发,实现错别字检测等功能在业务系统中的无缝集成。
WPS黑马校对V31智能错别字检测模块基于深度学习技术,提供多维度错别字识别、OCR文档专项修复、专有名词精准校验三大核心功能。支持同音/形近/音近字纠错、多音字语境化判定、自定义规则与质量报告生成,已服务中央级党报、国家级出版社等机构,政治性差错检出率达99.5%以上,重大报道编校效率提升3倍。
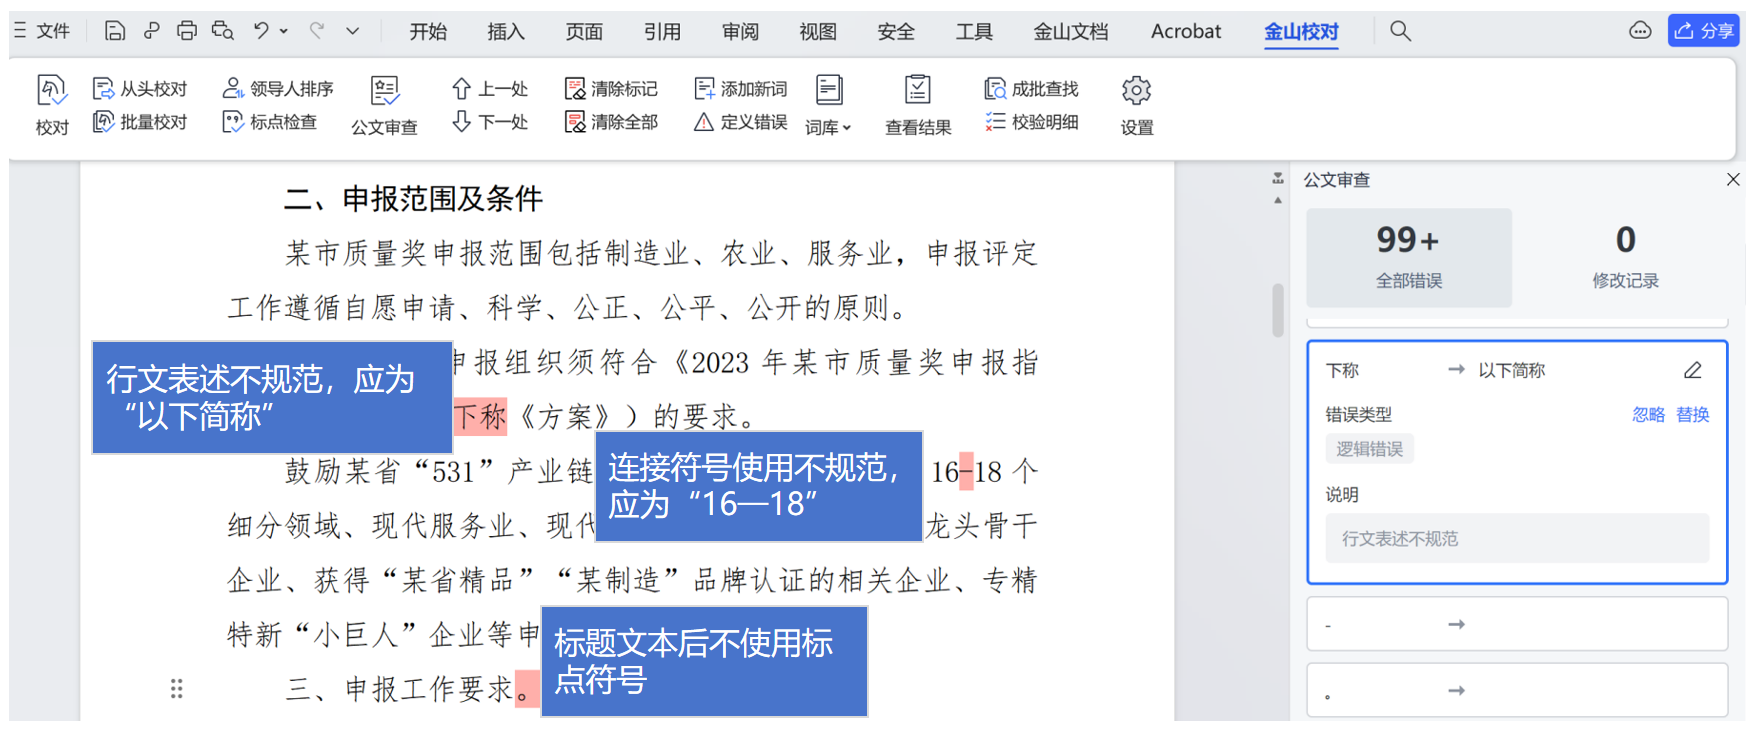
WPS黑马校对V31智能错别字检测模块,综合运用字形分析、拼音匹配、语义理解、上下文关联等多种技术手段,针对同音别字、形近错字、音近误用等问题实现精准识别与智能纠错。该方法主要功能涵盖三大层面:一是多维度错别字识别,融合字形相似度分析、拼音模糊匹配、语义关联判断,覆盖同音、形近、音近各类错字场景;二是OCR文档专项修复,针对扫描件、图片转文字后的识别错误进行智能校正,还原准确文本;三是专有名词精准校验,内置千万级人名、地名、机构名、品牌名词库,识别专有名词错写与不规范简称。同时,系统支持对多音字与易混字词的语境化判定,建立5000余组易混字词对比规则,严格遵循《现代汉语词典》《通用规范汉字表》等国家标准,明确语法差异与使用边界。
在实际应用中,某中央级党报引入黑马校对时政专用版本后,将原本需4小时的重大报道终审流程压缩至45分钟,政治性差错检出率提升至99.5%以上;某国家级医学出版社部署后,年度图书质量抽查差错率从0.35%降至0.02%,医学专业差错检出率较通用工具提升6倍。用户还可通过自定义错字规则与白名单机制,添加企业专属词汇、配置行业特定规则,并生成错字类型分布、高频错字排行等可视化质量报告。值得注意的是,黑马校对作为WPS 365生态中的专业级智能校对系统,其具体接入方式与授权方案需联系销售获取详细报价,与文档内置的基础校对功能在词库规模与检测深度上存在显著差异。
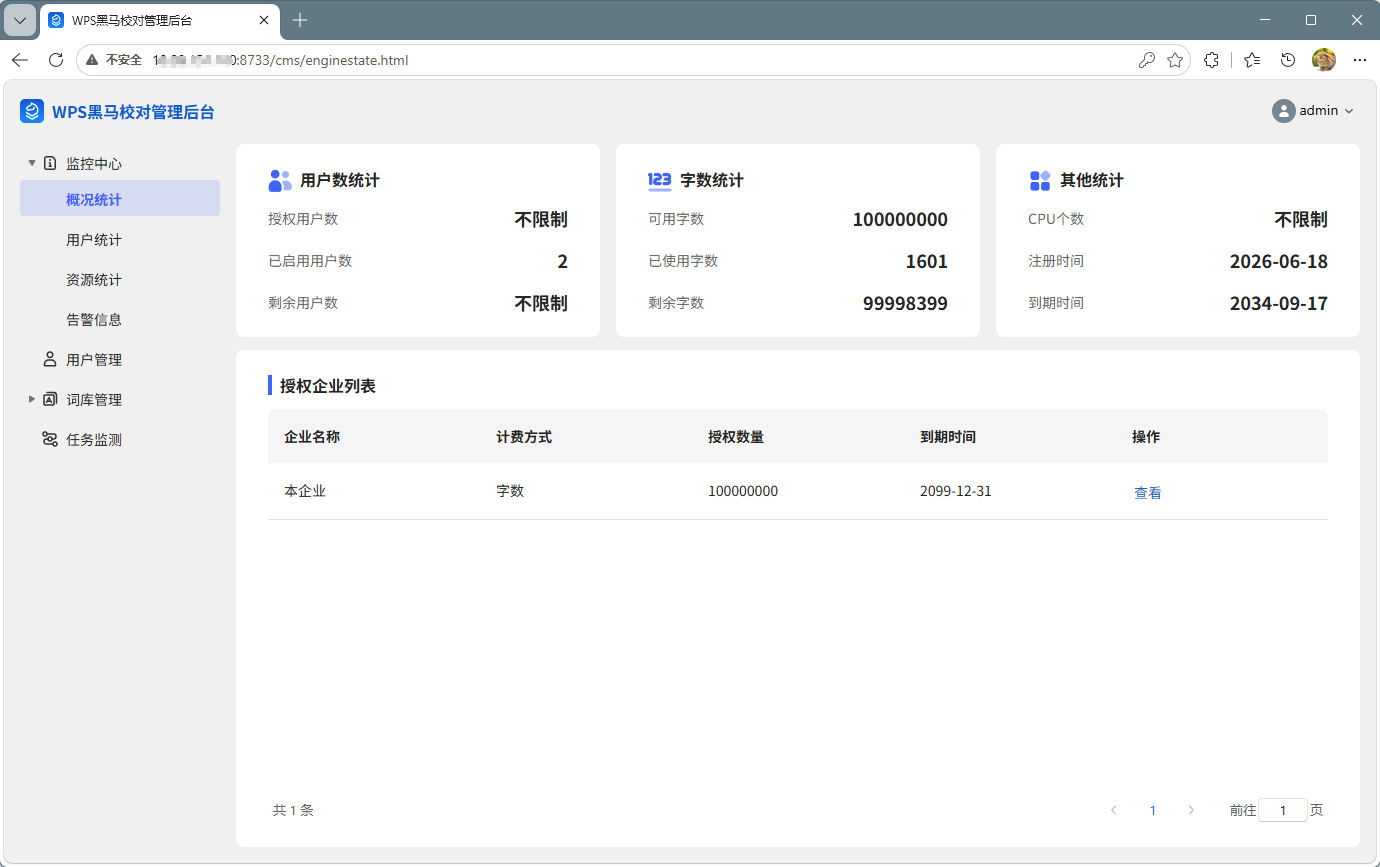
WPS黑马校对V31的核心能力源于多技术融合驱动的智能纠错体系。系统基于深度学习的汉字字形分析与语义理解技术,通过字形相似度分析精准捕捉形近字差异,借助拼音模糊匹配识别音近误用,结合上下文语境关联判断同音字正误。相较于基础词典匹配式校对,该体系将政治性差错检出率提升至99.5%以上,重大报道编校效率提升3倍,实现从"人盯人"到"系统防"的质变。在OCR文档专项修复方面,系统针对扫描件、图片转文字后的识别错误进行智能校正,有效还原准确文本,解决文档数字化加工中的高频痛点。
专有名词精准校验是另一核心优势。系统内置千万级人名、地名、机构名、品牌名词库,严格遵循《现代汉语词典》《通用规范汉字表》等国家标准,建立5000余组易混字词对比规则。某国家级医学出版社部署后,年度图书质量抽查差错率从0.35%降至0.02%,《实用内科学》等经典教材编校周期缩短40%。在少儿出版领域,系统通过插图OCR文字识别与内容一致性核对,填补行业空白,助力系列图书实现零差错出版。
企业级内容质量管理方面,开放规则引擎支持用户自定义错字规则与白名单机制。用户可一键导入企业名称、产品术语,配置正则表达式规则,强制拦截敏感错字表述。系统自动生成错字类型饼图、趋势折线图等多维度可视化报告,支持文件夹级批量检测与历史趋势对比,实现从"通用工具"到"企业级内容质量管理系统"的升级。某中央级党报引入后,两会期间日均处理稿件量提升至230篇,全年政治性差错归零。
WPS黑马校对V31的多音字与易混字词检测模块,通过语境分析引擎实现深度语义理解。系统严格遵循《现代汉语词典》《通用规范汉字表》等国家标准,建立多音字、易混字词专项规则库,覆盖"的/得/地""作/做""以至/以致""反映/反应"等5000余组高频易混词组。针对"长/涨/涨""行/行"等多音字在不同行业文本中的规范用法,系统结合前后文语义自动确定正确读音与对应字形,避免机械规则导致的误判,为教育出版、辞书编纂等场景提供符合国家语言文字规范的专业保障。
该模块在少儿出版领域展现出独特价值。某专业少儿出版社应用后,年度重点主题出版项目《中华优秀传统文化绘本》100册实现零差错出版,系列童话"小巴掌"IP开发中连续12册人设一致性达标。系统通过错用频率统计功能分析文档某易某混字词错用规律,辅助用户针对性提升用语能力;每项提示均标注参考规范来源,支持一键查看详细辨析说明,兼具纠错工具与语言学习辅助双重价值。相较于通用校对工具仅标记疑似错误,黑马校对提供的字词语法功能解释与规范用例,有效降低了教育出版领域的编校门槛。
在技术实现层面,语境化多音字判定依托深度神经网络分析句子语义,区分多音多义字词的正确用法。系统对教育出版、语言文字规范类文档实施专项优化,针对教材、教辅、辞书等场景强化语言规范性检测。某国家级辞书编纂机构引入后,大型工具书编校周期平均缩短35%,多音字条目差错率由人工校对的0.12%降至0.003%以下,充分验证了AI驱动字形语义融合分析技术在专业出版领域的应用价值。
WPS黑马校对V31的自定义错字规则与质量分析模块,为企业内容质量管理提供了高度灵活的制度化工具。该模块支持用户自主添加企业专属词汇白名单、自定义错字规则库与敏感错字黑名单,通过正则表达式与批量导入功能,灵活配置行业或企业特定错字检测规则。针对大型项目多人协作时错字标准不统一的痛点,系统强制拦截涉及政治、领土、民族等敏感领域的错字表述,有效防范合规风险。某大型出版集团应用后,成功将分散于各编辑部的术语规范整合为统一知识库,跨部门协作差错率下降72%。
在质量报告生成方面,系统自动输出错字类型饼图、趋势折线图、部门对比柱状图等多维度可视化分析图表,支持文件夹级批量检测与历史趋势对比。用户可统计错字类型分布、高频错字排行、部门/人员错字率等核心指标,实现文档质量量化评估与问题分布追溯。相较于固定规则的通用校对软件,这一开放规则引擎将黑马校对从通用工具升级为企业级内容质量管理系统。某金融机构合规部引入后,年度审计文档差错追溯时间由平均3.5小时缩短至15分钟,监管报送材料一次性通过率提升至98.6%,显著提升了组织级内容治理效能。
该模块的深层价值在于构建持续优化的质量闭环。通过错用频率统计与修改依据追溯功能,企业可识别高频错误模式,针对性开展员工培训与流程改进。系统提供COM、Java、Python等多种二次开发接口,方便集成至OA、ERP、编务系统等各类业务平台,实现错别字检测核心功能在复杂业务场景中的无缝嵌入与深度适配。
重大报道面临高强度时效压力,政治性表述容错率为零,人工校难以兼顾速度与质量。引入黑马校对时政专用版,构建即时采编+实时校对防线,实现领导人信息校验、敏感词动态拦截与终审把关。
医学术语海量更新快,药品名称、解剖部位差错直接威胁安全,三审三校仍难杜绝技术性失误。部署医学专业版,以百万词库与国际标准库实时校验,全科智能校对深度覆盖。
幼儿读物拼音插图易错,有害信息及系列人设冲突隐患突出,传统校审难以全覆盖。采用少儿出版专有智能审校方案,实现文字、插图一致性核对与价值观合规评估一体化。
WPS黑马校对V31作为一款专业级智能校对系统,其错别字检测方法主要涵盖三大核心功能:一是多维度错别字识别,融合字形分析、拼音匹配、语义理解与上下文关联技术,精准处理同音别字、形近错字、音近误用等问题;二是OCR文档专项修复,针对扫描件及图片转文字后的识别错误进行智能校正;三是专有名词精准校验,内置千万级人名、地名、机构名词库。此外,系统支持多音字语境化判定、5000余组易混字词对比规则,并提供自定义错字规则与白名单机制、可视化质量报告等企业管理功能。在时政新闻、医学出版、少儿出版等领域已有显著应用成效,如某中央级党报终审流程由4小时压缩至45分钟,某国家级医学出版社差错率从0.35%降至0.02%。

智能合同管理,支持合同创建、审批、电子签章、履约跟踪等全流程数字化,提升协作效率,降低法律风险,适用于各类企业的合同管理场景。




一款智能进销存管理工具,帮助小微企业实现采购、销售、库存、资金的一体化管理,数据实时同步,经营分析精准,助某生某意高效增长。

集成任务分配、进度追踪、团队协作等功能,支持甘特图与看板视图,适用于项目型组织,提升项目交付效率与团队执行力。
智能合同管理,支持合同创建、审批、电子签章、履约跟踪等全流程数字化,提升协作效率,降低法律风险,适用于各类企业的合同管理场景。

专注进销存管理,涵盖采购、销售、库存、往来账款,支持多端协同,数据实时更新,为批发零售企业提供智能化的货品流转解决方案。
集成任务分配、进度追踪、团队协作等功能,支持甘特图与看板视图,适用于项目型组织,提升项目交付效率与团队执行力。

面向中小企业的业财一体化软件,实现业务与财务数据无缝衔接,智能记账、报表分析,合规高效,助力企业精细化管理。



一款智能进销存管理工具,帮助小微企业实现采购、销售、库存、资金的一体化管理,数据实时同步,经营分析精准,助某生某意高效增长。

智能云财务软件,支持发票采集、自动记账、税务申报、报表生成,专为小微企业打造,操作便捷,财税合规专业。
政治性差错检出率超99.5%,4小时终审压缩至45分钟,护航央媒零事故发布。
千万级医学名词库,专业差错检出率提升6倍,抽查差错率降至0.02%。
OCR文档专项修复,自动校正形近字、音近字,助力数字化加工一次做对。
语境引擎辨析五千余组易混词,辞书差错率降至0.003%,符合国标规范。
支持正则批量导入专属词库,杜绝品牌名、产品词误报,统一编校标准。
自动生成错字类型饼图、部门对比柱状图,量化评估,跨部门协作差错降72%。
融合字形分析、语义理解技术,精准识别同音别字、形近错字,OCR修复,千万专有名词库,自定义规则,助您将差错率降至0.02%