

WPS 邮箱
作为企业知识流通的数字枢纽,支持大附件安全传输与文档集中管理,与智能文档系统无缝对接,确保重要资料高效分发与归档。
作为企业知识流通的数字枢纽,支持大附件安全传输与文档集中管理,与智能文档系统无缝对接,确保重要资料高效分发与归档。

内置语义级相似度检测引擎,实现"边写边查"零感知体验,自动识别重复内容并推荐可复用知识,构建从创作到归档的全流程内容风控体系。

结合文档相似度检测技术,提供深度内容风控与智能校对服务,精准识别公文与合同中的表述风险,确保学术与政务文档的合规准确性。

支持远程协同中的文档实时共享与讨论,自动归档会议纪要去重存储,结合知识库智能推荐历史资料,提升跨部门协作效率。

管理文档审阅与合规检查任务流程,智能提醒合同比对、政策同步等关键节点,确保知识治理与版本控制工作及时完成。
WPS智能文档相似度检测基于NLP语义分析技术,自动识别企业知识库重复文档,支持一键合并归档释放存储空间;秒级定位合同、公文多版本间条款增删改差异,生成可视化比对报告;实时检测创作内容与历史文档相似度,避免重复造轮子。适用于学术期刊审稿、律所合同审查、政府机关公文管理及媒体内容风控,与WPS办公生态无缝整合,助力企业建立唯一可信知识源,降低合规风险。
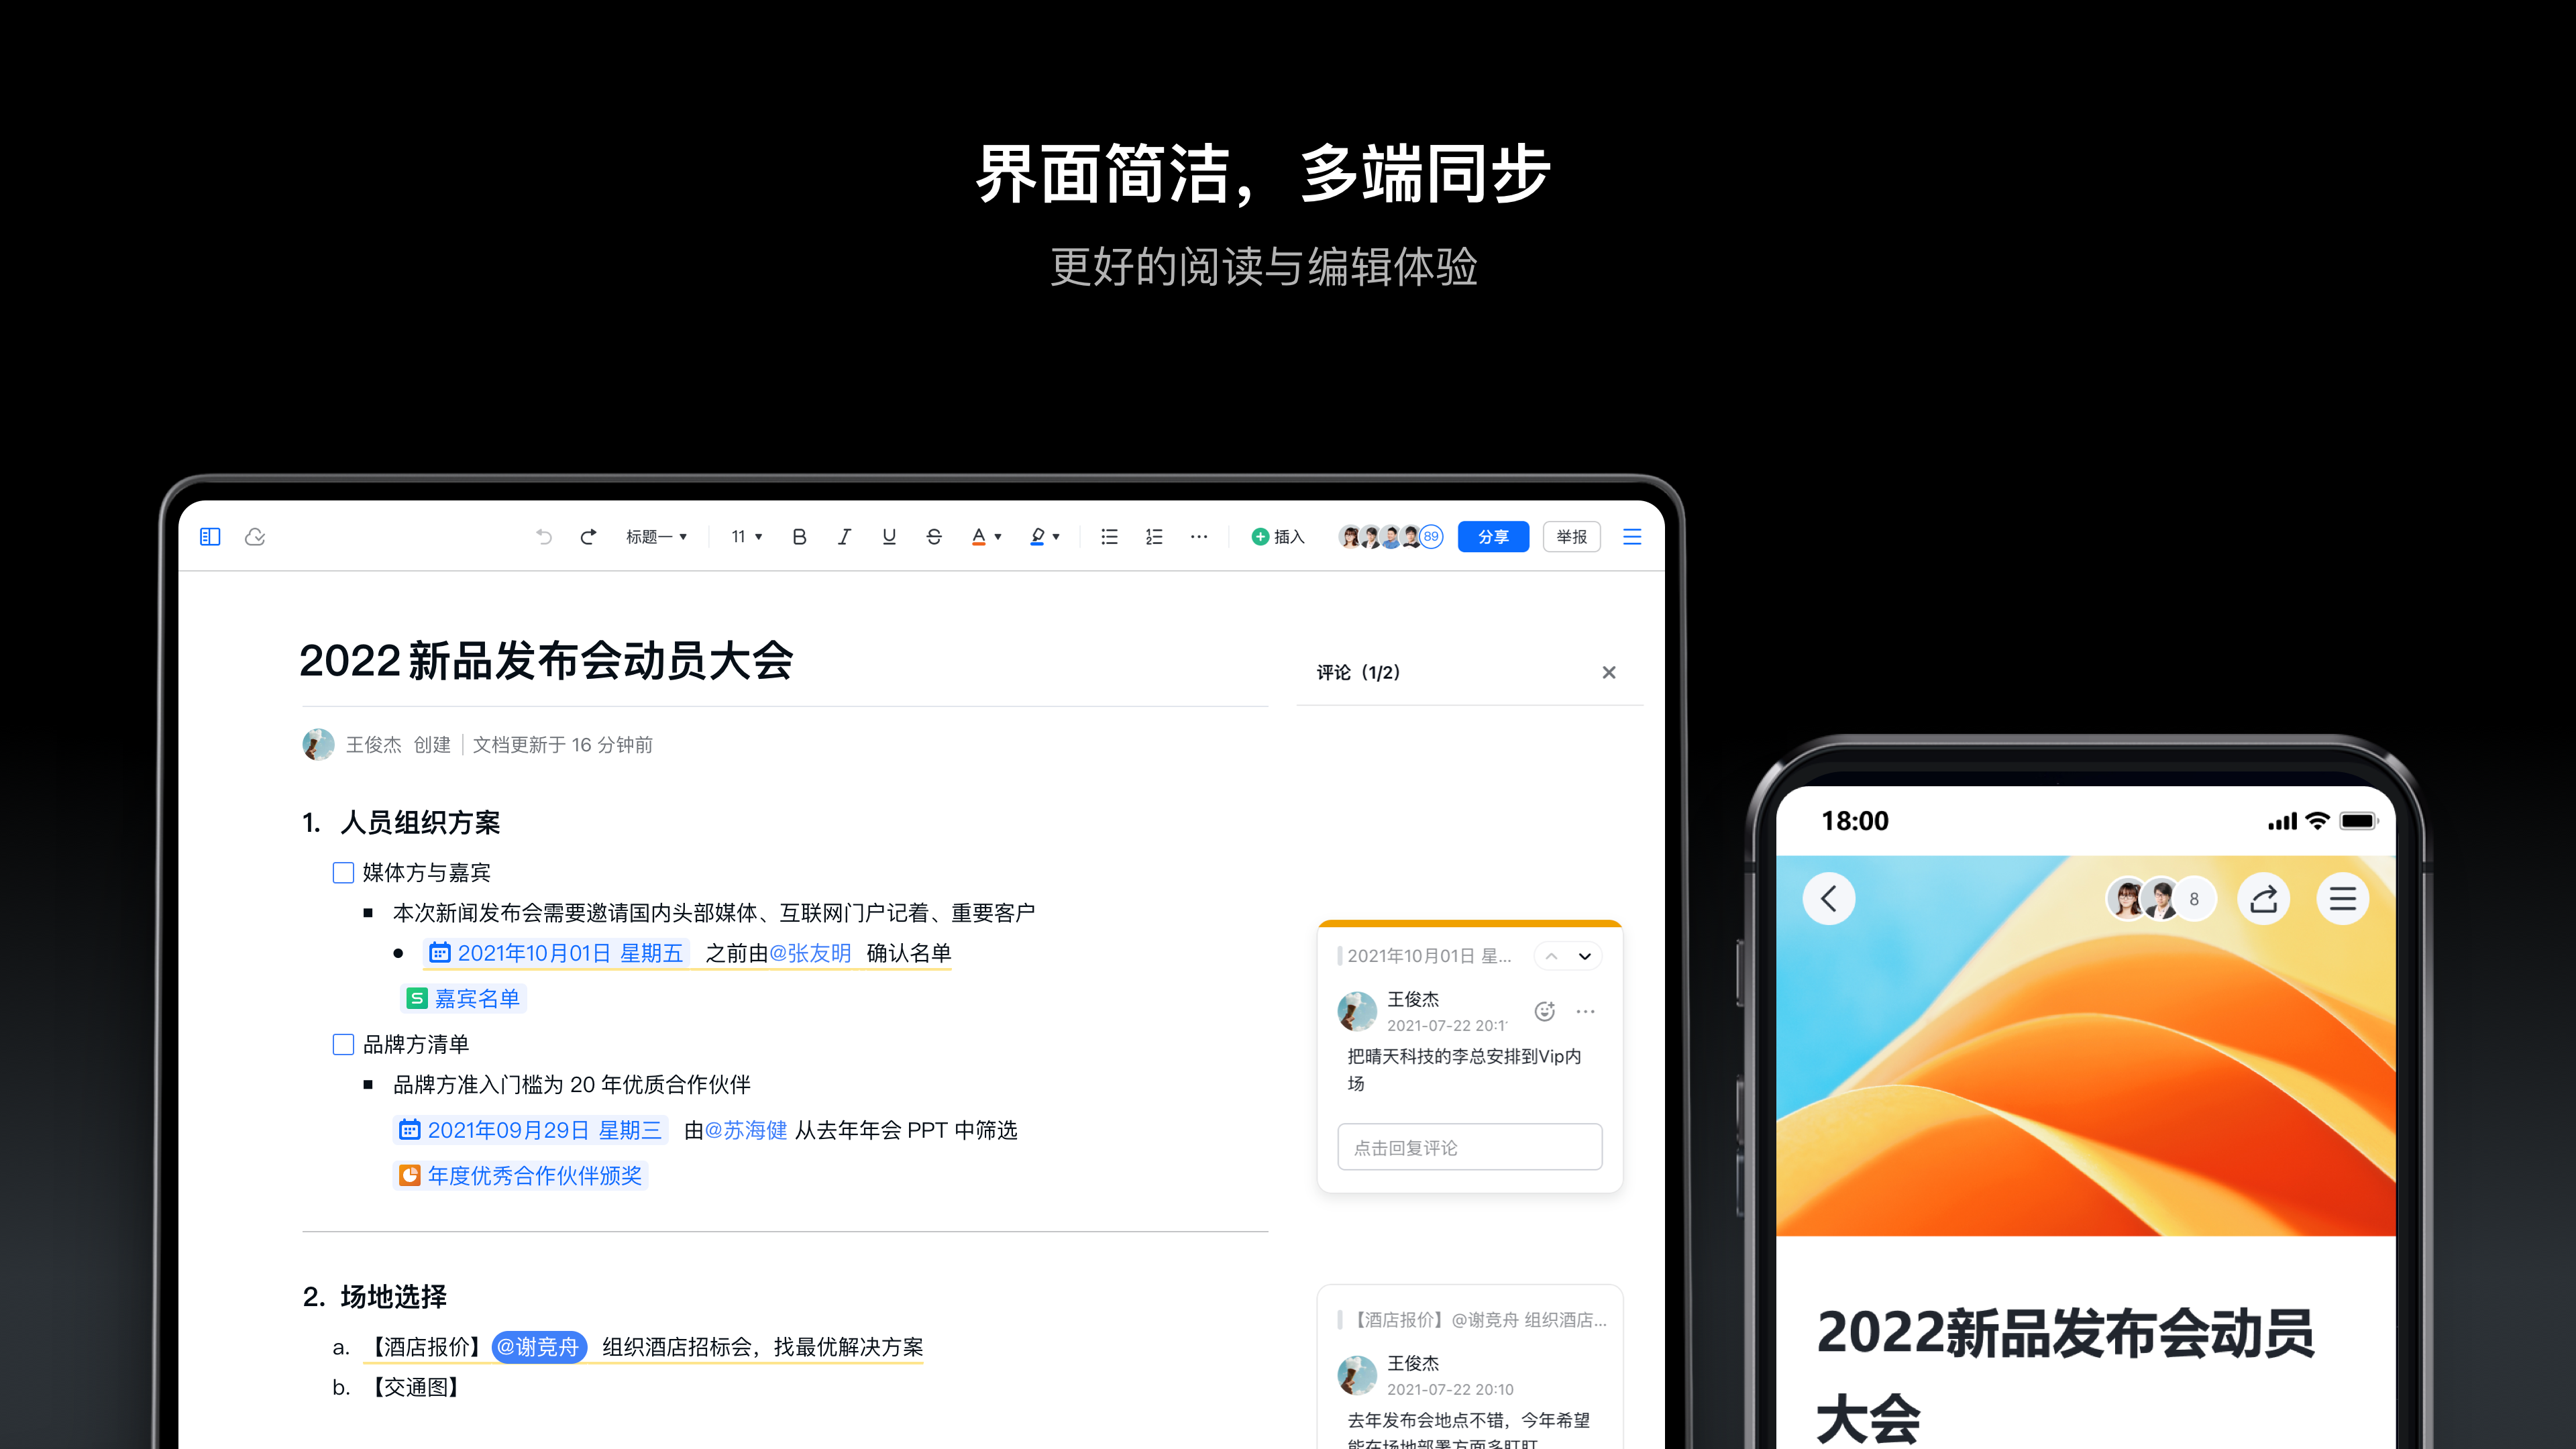
企业知识库中历史资料重复存储、版本混乱导致的资源浪费与检索低效,是传统文档管理难以逾越的障碍。基于NLP语义分析的文档相似度检测技术,通过自动扫描识别重复或高度相似内容,不仅能精准计算内容重复率,还支持一键合并、归档冗余文档,从而释放存储空间、建立唯一可信知识源。在合同审阅与公文处理场景中,该技术可秒级定位多版本间的条款增删改细节,生成可视化差异报告,避免人工逐行核对可能遗漏的风险点,满足法务审计与政务合规的严苛要求。
针对创作环节的重复造轮子问题,实时相似度检测能够在撰写过程中即时比对历史文档,主动推荐可复用的段落与数据,前置拦截重复创作并加速新人对企业知识资产的掌握。无论是学术期刊识别一稿多投、律所追踪合同修订痕迹,还是媒体机构监测洗稿行为,这一技术均能通过跨文档语义比对,构建从创作、审阅到归档的全流程内容风控体系。需要注意的是,此类AI驱动的深度文档分析功能通常包含在WPS 365商业旗舰版或通过联系销售开通,企业可根据知识管理成熟度与合规需求选择合适的服务层级。
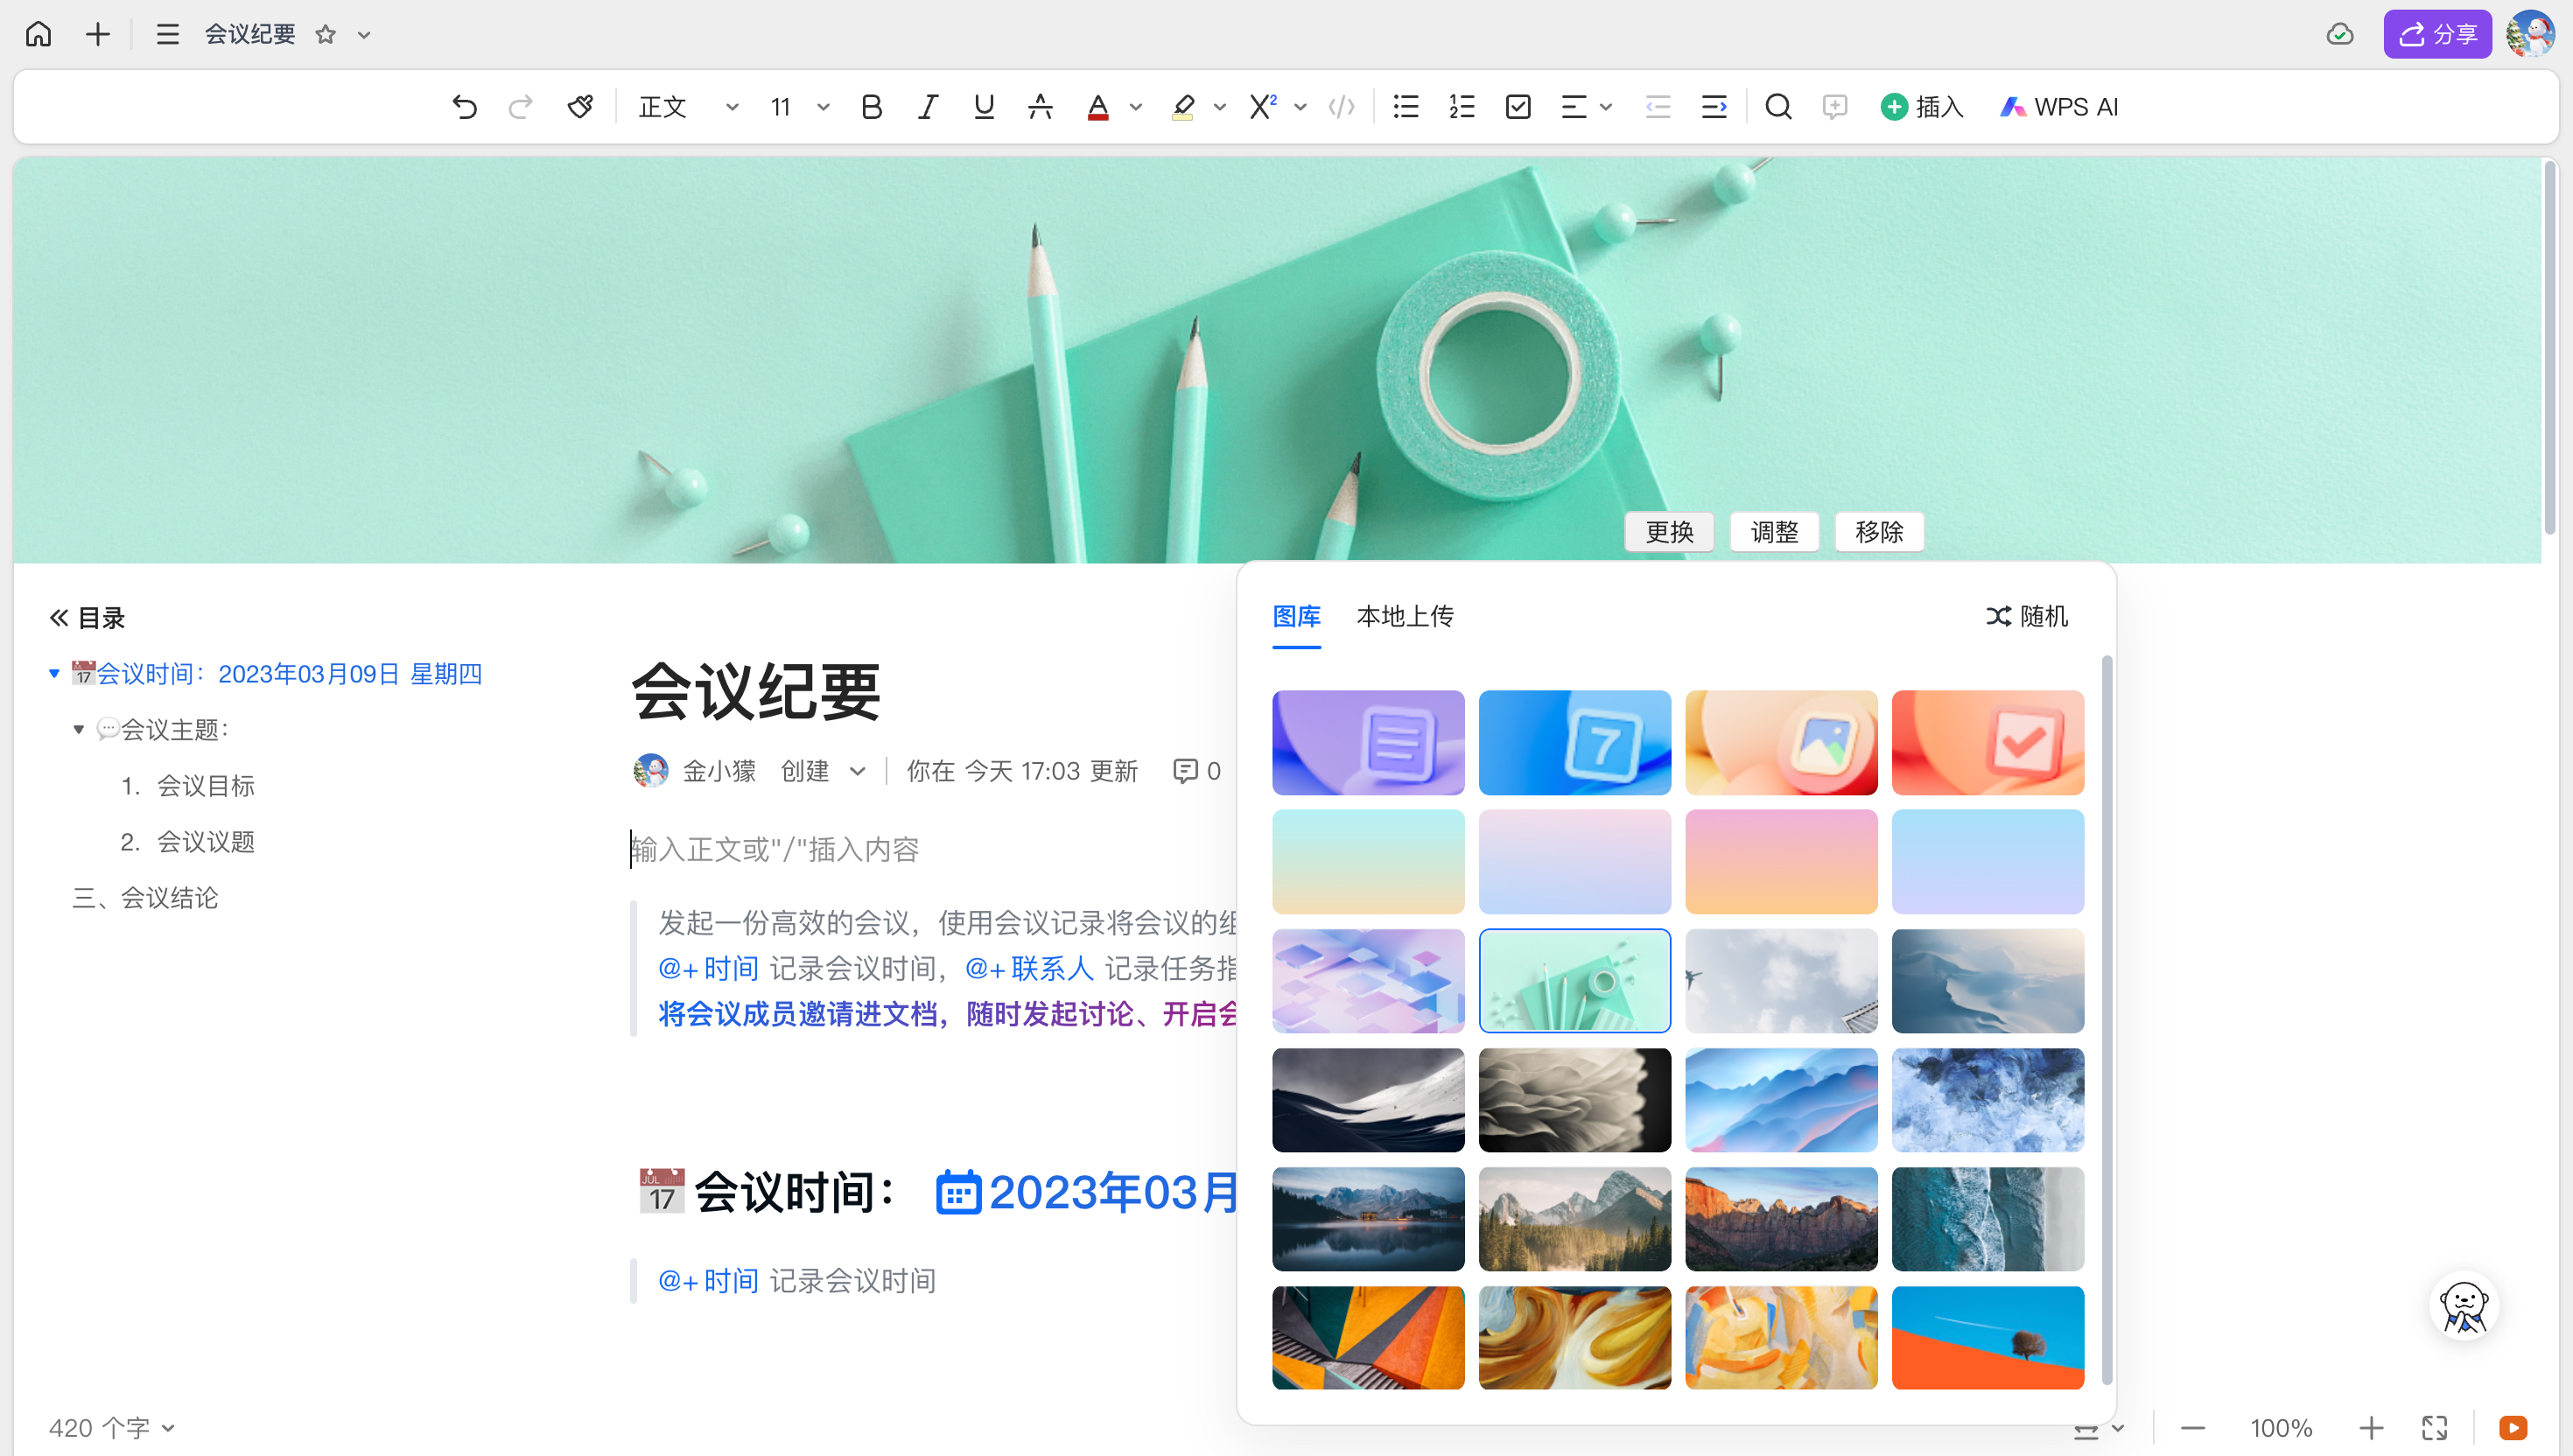
在学术出版领域,文档相似度检测已成为维护科研诚信的核心防线。通过构建跨期刊数据库重复发表预警系统,编辑部可自动识别一稿多投、自我抄袭及不当引用行为,将传统需要数天的人工查重压缩至秒级完成,使审稿周期缩短40%以上。某CSSCI核心期刊的实践表明,该系统不仅能精准拦截学术不端稿件,更能通过返修版本的智能差异比对,自动高亮修改痕迹,帮助编辑专注学术质量而非格式审查。
法律与政务场景同样受益于深度语义比对技术。律师事务所借助合同版本差异分析,可在复杂并购协议中秒级定位担保条款等关键内容的擅自修改,避免潜在千万元级损失;政府机关则通过政策文件修订自动对比,确保上下级文件表述一致,消除部门间发文内容冲突。某省级政府部署后年度公文退文率下降60%,有效维护了行政权威性与执行准确性。
对于媒体机构,该技术构建了从内容生产到分发的原创保护闭环。通过实时监测海量稿件库与网络公开内容,系统可精准识别洗稿、抄袭及过度同质化选题,在保障SEO效果的同时释放30%的存储资源。这种贯穿学术、法律、政务与传媒领域的全流程风控能力,使文档相似度检测从简单的查重工具升级为组织知识治理与合规管理的基础设施。
不同于依赖文件名或简单关键词匹配的传统工具,基于深度学习的语义级相似度检测能够穿透文本表层,理解段落核心意图与概念关联,即使面对同义词替换、语序调整或跨语言表述,仍能精准识别内容同质化问题。这种技术突破使企业得以突破"形式去重"的局限,实现真正意义上的知识唯一性管理,将分散在各部门的隐性知识资产显化并整合。
在协同创作场景中,实时相似度检测前置拦截机制彻底改变了知识生产方式。当多人并行编辑项目方案或技术文档时,系统不仅即时标记内容冲突与雷同修改,更基于语义关联主动推送历史可复用素材,自动生成合并建议,将版本冲突处理成本降低70%以上。这种"边写边查"的模式有效破解了新人重复造轮子、跨部门信息孤岛等顽疾,使组织经验在创作源头即被充分激活。
更深层次的价值在于构建自适应知识治理体系。通过持续分析文档血缘关系与内容相似性,系统可自动完成知识归类与标签化管理,释放高达30%的存储资源,并为构建企业知识图谱提供结构化数据基础。与WPS办公生态的无缝整合,使查重、比对、去重能力内嵌于日常编辑工作流,无需切换工具即可实现从创作、审阅到归档的全生命周期内容风控,真正成为组织知识管理的数字基础设施。
传统文档查重往往作为独立环节割裂于创作流程之外,不仅因关键词匹配导致误判率高,更因频繁的系统切换打断工作流。WPS智能文档将语义级相似度检测深度嵌入编辑内核,实现"边写边查"的零感知体验,相比单纯查重工具节省90%整理时间。这种与办公生态的无缝整合,使查重从被动的事后审查转为主动的创作辅助,基于NLP的语义理解即使面对同义词替换、语序调整仍能精准识别潜在重复,突破传统文件名检索的局限。
在知识治理层面,系统通过分析文档内容相似性自动完成智能分类与标签化管理,将散乱文档自动归档至对应知识域,无需人工逐篇筛查即可构建有序知识库。针对合规审查场景,自动比对制度文件与政策条款的细微差异,确保引用准确同步;在版权保护领域,持续监控网络公开内容,及时发现侵权转载并为维权提供证据链。这种从字符级比对到语义级理解的跃迁,不仅释放30%存储资源,更通过建立文档血缘分析体系,使隐性知识关联显性化。
当技术从辅助工具进化为组织基础设施,文档相似度检测已超越简单的重复识别,成为驱动知识复用与创新的数字底座。无论是加速新人对企业知识资产的掌握,还是构建跨部门统一知识口径,AI驱动的深度文档分析均实现了从"人找知识"到"知识找人"的范式转变,为组织沉淀可信赖的单一知识源,在保障合规的同时激活沉睡的知识价值。
投稿量激增导致人工查重耗时且易漏检一稿多投,返修版本逐字比对效率低下。引入WPS智能文档相似度检测系统,实现投稿自动查重、返修版本智能差异比对与跨库重复发表预警,覆盖初审至终审全流程。
复杂并购协议多版本人工比对易遗漏关键条款修改,审查周期长、风险高。部署WPS智能文档合同比对平台,实现百页合同秒级差异定位与风险条款自动标注,修改痕迹全程留痕可追溯。
多部门发文内容重复、政策文件修订前后比对耗时,易出现与上位法冲突的隐性风险。采用WPS智能文档公文比对系统,实现政策修订自动对比、多部门发文查重与矛盾预警,确保规范性文件一致性。
文档相似度检测通过NLP语义分析技术,系统性解决企业知识库重复存储与版本混乱导致的资源浪费,实现秒级定位合同、公文多版本差异,避免人工核对遗漏风险。在学术出版、法律政务及媒体领域,该技术有效拦截一稿多投、自我抄袭与洗稿行为,构建原创保护防线。同时,实时检测机制前置拦截重复创作,主动推荐可复用知识资产,并结合自动分类与合规比对功能,降低协作冲突处理成本,释放存储资源,建立唯一可信知识源与全流程内容风控体系。

基于NLP语义分析,自动检测业财文档重复内容,一键合并冗余,构建唯一可信知识源,降低存储成本,提升业财协同效率。




借助WPS智能文档的深度语义比对,实现财务报告智能查重与版本管理,确保数据准确一致,满足审计合规,简化财务流程。

结合语义相似度分析,智能管理进销存单据,自动去重与归档,确保数据唯一性,提升库存管理效率,降低存储成本。
基于NLP语义分析,自动检测业财文档重复内容,一键合并冗余,构建唯一可信知识源,降低存储成本,提升业财协同效率。

融合文档相似度技术,自动比对销售合同与订单,避免重复录入,保障业务数据唯一可靠,助力企业高效决策。
借助WPS智能文档的深度语义比对,实现财务报告智能查重与版本管理,确保数据准确一致,满足审计合规,简化财务流程。

基于WPS智能文档语义分析,自动比对合同版本差异,秒级定位条款增删改细节,保障法务审计与合规要求,避免人工核对遗漏风险。



结合语义相似度分析,智能管理进销存单据,自动去重与归档,确保数据唯一性,提升库存管理效率,降低存储成本。

集成文档相似度检测,前置拦截重复造轮子,实时推荐可复用项目文档,加速团队协作与新人上手,释放知识资产价值。
自动扫描重复文档,一键合并冗余内容,释放存储空间,建立唯一可信知识源。
比对合同版本,高亮条款增删改细节,生成可视化报告,规避千万元级风险。
撰写时即时比对历史文档,主动推荐可复用段落,拦截重复造轮子,加速新人上手。
跨期刊数据库查重,秒级识别一稿多投与自我抄袭,缩短审稿周期40%以上。
自动对比上下级公文表述差异,确保政策一致,年退文率下降60%,维护行政权威。
监测海量稿件与网络内容,精准识别洗稿与同质化选题,释放30%存储资源。
将语义相似度检测嵌入编辑流程,实现边写边查、智能去重与知识归集,释放30%存储资源,构建企业唯一可信知识源。