

WPS 智能表单
支持古籍校勘流程数字化,快速创建避讳字登记表、异体字对照表等,实现整理数据结构化采集与多维度统计。
支持古籍校勘流程数字化,快速创建避讳字登记表、异体字对照表等,实现整理数据结构化采集与多维度统计。

内置古籍专用词库与避讳字表,精准识别形近讹字、音近借字及脱衍倒文,确保百万字典籍零差错出版。

提供古籍整理全流程协同平台,支持多团队云端协作、版本控制与权限管理,保障大型典籍项目标准统一。

AI辅助识别残泐字形、自动比对OCR结果,智能生成校勘记与引文核对报告,提升珍稀文献整理效率。

安全传输高清古籍扫描件与大型语料库,支持TB级附件云端暂存,保障跨地域团队资料交换高效安全。
针对古籍整理中生僻字异体字误报、避讳字缺笔识别困难、引文核对耗时及OCR转录错误等痛点,WPS黑马校对古籍版提供智能化解决方案。系统支持Unicode古籍字符集与CJK扩展区,精准识别异体字、避讳缺笔、形近讹字,自动核对经史子集引文,纠正OCR识别错误,规范竖排版式与校勘记格式。适用于古籍出版社、高校古籍所、图书馆及地方志办公室,使百万字典籍校勘时间缩短90%,引文核对效率提升3倍以上,确保重大出版工程零差错。
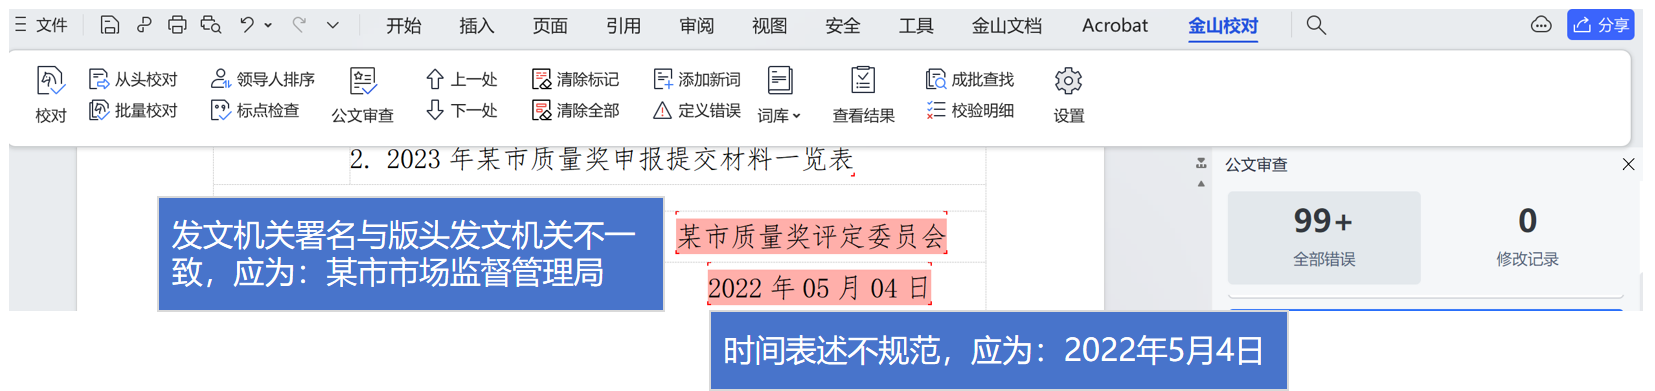
古籍整理长期面临文字讹误、异体字混杂及避讳字识别等多重挑战,专业校对系统通过智能化手段系统性解决这些痛点。针对人工校勘效率低、易漏检形近讹字(鲁鱼亥豕)、音近借字及脱衍倒文等问题,系统基于权威辞书与历代避讳字表,自动识别十四类古籍错误,支持多版本比对校勘,生成标准校勘记,使百万字典籍处理时间从数月缩短至数十分钟,同时精准检测缺笔、改字、空围等避讳现象并还原本字。
在异体字与版式规范方面,系统支持CJK扩展区及Unicode古籍字符集,建立古今字、通假字映射关系,避免生僻字误报,统一历代人名、地名、官名译写标准。针对数字化场景,系统可自动比对OCR识别结果与原始图像,纠正形近字误识,补全残泐字形,确保出土文献、简帛碑刻等特殊文本的准确转录。此外,系统严格对标古籍整理出版规范,自动检查句读使用、繁简转换、专名号书名号规范及竖排版式,统一校勘记格式,有效避免体例混乱,保障学术出版质量。
针对古籍整理中引文核对繁琐、典故出处难以考证的痛点,专业校对系统内置大型权威文献数据库,可自动校验经史子集引文的准确性与完整性,精准识别张冠李戴、断章取义及注释与正文错位等学术差错,确保重大出版工程零引文失误。系统支持多版本典籍自动比对,通过异文分析帮助学者判断原文与后人改动,生成符合学术规范的校勘记与按语,大幅降低人工核对成本,使引文核查效率提升三倍以上。
在出土文献与特殊载体整理方面,系统针对简帛、碑刻、方志等文本提供专项支持,可智能识别残泐字形、缀合断片,辅助复原历史原貌。通过内置避讳字表与缺笔规则,自动检测改字、空围、缺笔等古代特殊书写现象并提示时代背景;同时支持年号干支纪年换算校验,消除方志编纂中的纪年错误,使碑刻文献识别效率提升数倍,保障文史资料准确权威。
面向古籍数字化全流程,系统构建从OCR识别到文本发布的质量保障链路,不仅可自动纠正扫描转录中的形近字误识、补全Unicode扩展区生僻字,更支持多用户协同校对模式与古籍专名词库云端管理。通过统一历代人名地名译写标准、管控异体字变异规则,有效解决大型整理项目中版本差异混乱、整理标准不一的问题,助力图书馆、档案馆实现千万字级古籍数字化工程的高质量完成。
针对古籍出版社、高校古籍所、图书馆特藏部及地方志办公室等不同机构的差异化需求,专业校对系统提供定制化解决方案。出版社可依托系统完成《中华大典》等重大出版工程的文字规范与引文核对,确保零差错率;高校研究团队借助出土文献字库与通假字识别功能,有效降低研究生校对门槛,使《敦煌文献集成》等冷门绝学项目顺利推进;图书馆与档案馆则通过OCR智能纠错与Unicode生僻字补全,实现《四库全书》千万字级数字化工程的高质量完成。
系统特别强化大型项目的协同管理能力,支持多级权限设置与云端古籍专名词库统一管理。在《历代方志集成》等跨地域、跨团队项目中,可实现异体字规则、避讳字标准、人名地名译写的版本控制与实时同步,彻底解决了传统整理中因标准不一导致的体例混乱问题。通过批量导入字形变异规则与自定义词库,各整理环节均能保持口径统一,大幅提升多卷本典籍的整理效率。
依托符合《古籍整理出版规范》及《通用规范汉字表》的严格标准,系统为各类古籍整理机构构建起从文本识别、内容校对到出版发布的全流程质量保障体系。实际应用数据显示,系统可使百万字典籍校勘时间缩短90%,数字化错误率降低80%,生僻字识别准确率达99%以上,真正成为守护古籍整理学术规范与出版质量的智能屏障。
针对古籍中"已""己""巳"、"戊""戌""戍"等形近字极易混淆的难题,系统采用字形相似度算法结合历代用字规则库,精准识别因抄刻不清导致的形讹错误。通过内置唐五代俗字、宋元古字及六朝碑别字等时代特征字表,自动区分不同时期的用字习惯,避免以今律古的误校,确保宋版书用宋体字、唐写本用唐俗字的原貌保留,使形近字辨析准确率达到学术出版要求。
在版式符号规范方面,系统严格区分古籍句读与现代标点混用问题,自动检查专名线、书名号、浪线号的正确使用,以及"校""讹""衍""脱""倒"等校勘符号的标准格式。针对繁简转换中的一简多繁难题,如"發"与"髮"、"後"与"后"的智能选择,系统依据上下文语义自动匹配正确繁体,杜绝机械转换导致的文义颠倒,保障竖排、双行小字、朱墨套印等特殊版式的学术规范性。
面对残损文献的缺字、泐痕与虫蛀模糊区域,系统结合上下文语义关联与大型语料库,智能推测缺文内容并标记置信度,辅助专家补全残卷。同时,通过交叉核对注释与正文的对应关系,自动发现注文张冠李戴、引书卷次错误及释义与原文矛盾等问题,构建从字形辨析、版式规范到内容补全的全方位质量保障体系,确保珍稀古籍整理的真实性与完整性。
书稿异体字混乱、避讳字疏漏频发,引文人工核对耗时易错。引入古籍专用校对引擎,自动识别异体字、排查避讳字并校验经史子集引文,全面规范文字与版式。
出土文献生僻字难识别,古今字通假字混用,研究生校对能力不足。系统提供出土文献字库与通假字智能辨析,支持多版本引文比对,降低学术整理门槛。
OCR识别古籍错误率高,生僻异体字缺字严重,人工逐字比对耗时巨大。采用OCR智能纠错与Unicode生僻字补全,实现图文自动比对校验,保障数字化质量。
古籍校对系统系统性解决文字讹误(形近音近、脱衍倒文)、避讳字识别(缺笔改字、空围)、异体字与古今字规范等核心难题。支持多版本自动比对生成校勘记,精准校验引某典某故与注释对应,智能识别简帛碑刻残泐字形并推测缺文。针对数字化需求,可纠正OCR误识、补全Unicode生僻字,严格管控繁简转换与竖排版式,实现从图像识别到出版发布的全流程质量保障,大幅提升整理效率与学术严谨性。

专为古籍整理项目打造的智能财务工具,精准管控经费预算与成本,自动生成多卷本工程核算报表,助力《中华大典》等重大出版任务高效完成。




面向古籍出版机构的一体化销售管理平台,整合古籍发行、客户关系与渠道分销,智能追踪销量,提升《四库全书》等大型数字化成果的发行效率。

为古籍整理团队提供专业云财务服务,自动归集项目成本,一键生成审计报表,简化高校古籍所、出版社的经费核算,保障学术工程资金透明合规。
专为古籍整理项目打造的智能财务工具,精准管控经费预算与成本,自动生成多卷本工程核算报表,助力《中华大典》等重大出版任务高效完成。
面向古籍出版机构的一体化销售管理平台,整合古籍发行、客户关系与渠道分销,智能追踪销量,提升《四库全书》等大型数字化成果的发行效率。
为古籍整理团队提供专业云财务服务,自动归集项目成本,一键生成审计报表,简化高校古籍所、出版社的经费核算,保障学术工程资金透明合规。

专注古籍出版合同管理,智能比对条款异同,自动提醒版权风险,确保《历代方志集成》等跨团队项目的合作协议零差错,守护学术出版法律权益。




面向古籍数字化工程的项目协同平台,支持多级权限与云端专名词库,实时追踪校勘、排版进度,助力《敦煌文献集成》等冷门绝学高效落地。

为古籍出版机构提供进销存一体化管理,精准核算古籍印制成本,无缝对接线上线下发行渠道,保障《四库全书》等重大成果的库存与销售高效运转。
精准识别形近讹字、音近借字、脱衍倒文等14类错误,百万字校勘仅需30分钟。
自动检测缺笔、改字、空围等避讳现象,提示时代背景,还原本字。
支持CJK扩展区及Unicode全集,建立古今字映射,避免误报,统一译写标准。
内置权威文献数据库,校验经史子集引文,杜绝张冠李戴,效率提升3倍。
自动检查句读、专名号、繁简转换,统一校勘记格式,符合出版规范。
支持多版本比对、异文分析,生成标准校勘记,云端协同管理,保障大型项目。
专为古籍整理打造的智能校对系统,一键识别形讹、避讳、异体字等十四类问题,让百万字校勘从数月缩短至数十分钟。