

AI 智能抽取
针对检测报告字段提取中的标准不一、数据混杂等难题,AI智能抽取支持自定义字段配置与跨页表格识别,实现多源格式报告的结构化解析与自动入库。
针对检测报告字段提取中的标准不一、数据混杂等难题,AI智能抽取支持自定义字段配置与跨页表格识别,实现多源格式报告的结构化解析与自动入库。

支持检测实验室远程评审与多方协同,通过高清视频会议实现检测报告会商、技术专家在线签认,提升跨地域质控协作效率。

集中管理海量检测报告与标准文件,支持OCR识别与智能检索,实现CMA资质文件、检测原始记录的版本控制与合规存储。

安全传输加密检测报告与原始记录,支持大附件批量发送与阅后即焚,确保第三方检测数据在传输过程中的机密性与完整性。

在线预览与批注PDF检测报告,支持多人在线协同审核检测数据,无需下载即可完成报告会签与质量台账的实时同步。
针对第三方检测、环境监测、食品建材等领域检测报告字段提取难题,AI智能抽取支持PDF/扫描件/图片批量解析,通过single/group自定义字段配置解决跨页表格、多批次数据混杂问题,内置环境/食品/建材行业预置模板,结果以JSON/Excel格式对接LIMS、ERP及质量管理系统,实现检测数据自动入库与质量台账生成。
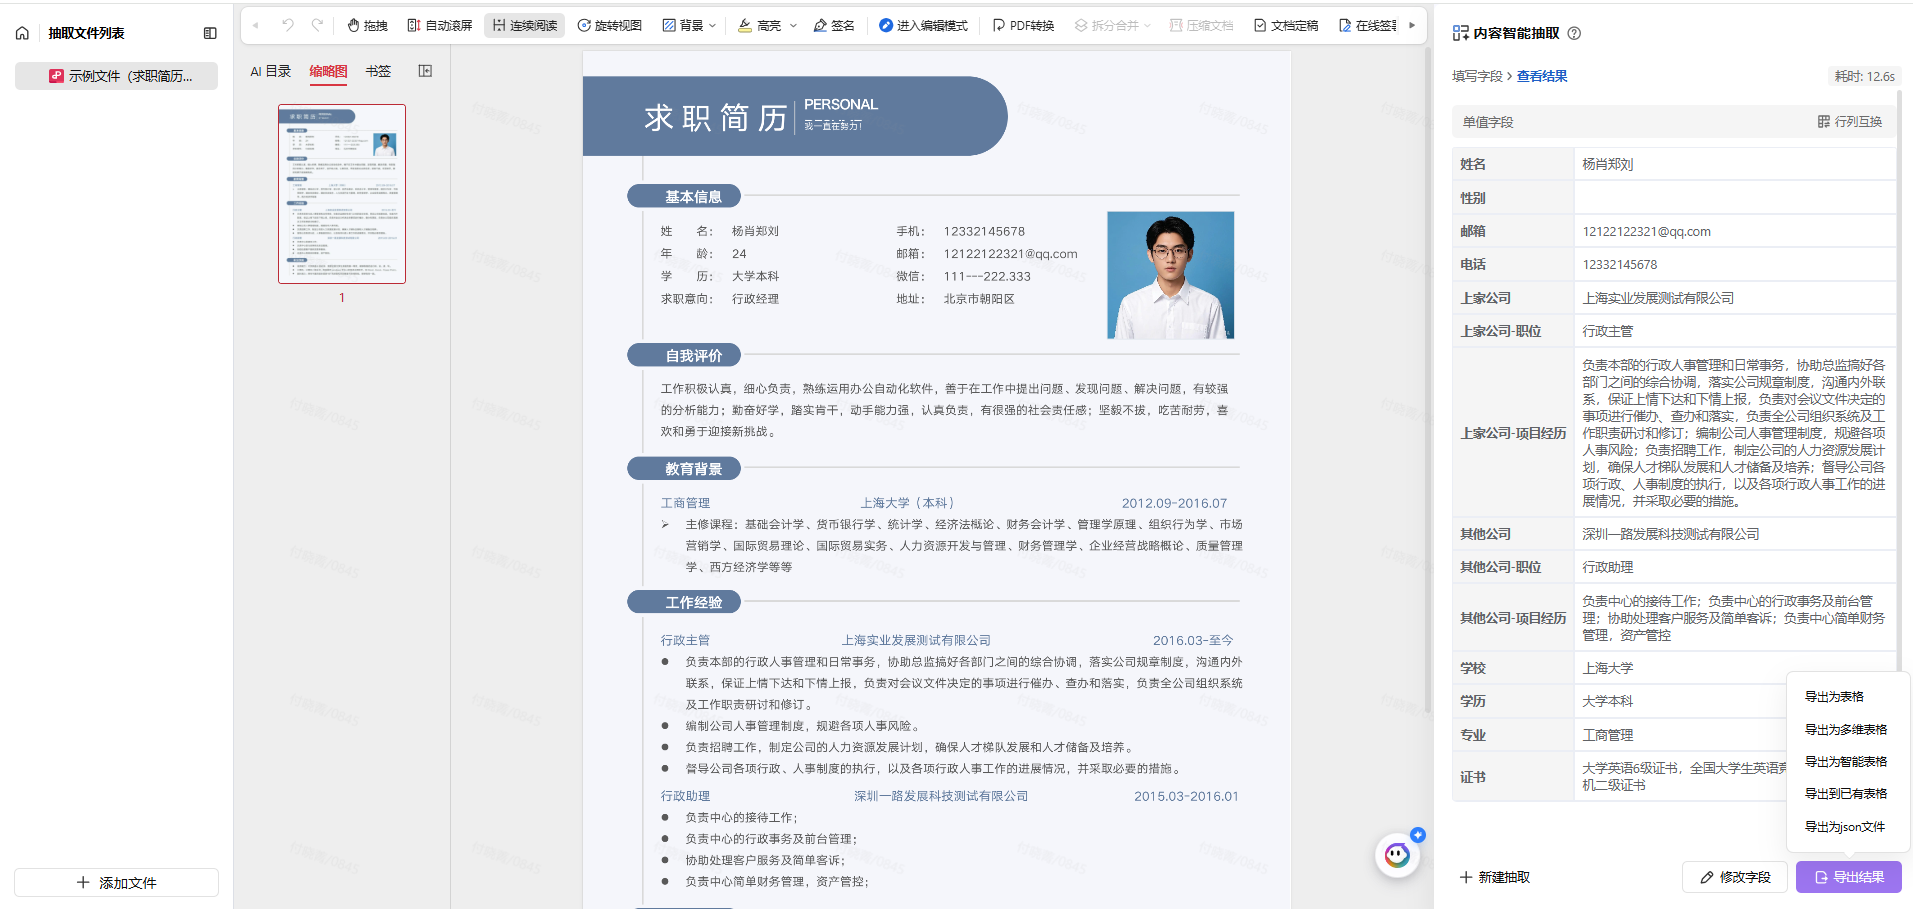
在第三方检测、环境监测及食品检验等场景中,检测报告字段提取常面临三类典型问题:一是不同检测标准(国标、行标、企标)所需字段与预置口径不完全对应,实验室难以按LIMS规则增补检测项、标准限值与实测值;二是多批次检测数据挤在同一单元格,跨页表格解析困难导致数据错位或遗漏;三是PDF、扫描件与图片混杂时,关键信息依赖人工抄录,结构化数据无法及时入库。
针对这些痛点,可通过自定义字段配置实现精准抽取。支持按检测业务口径配置single类型(如报告编号、CMA编号)与group类型(如多批次检测项目),并为字段补充parent层级、position页码与desc描述以提升准确性。组字段可将多批次数据拆分为多行记录,检测项、限值、实测值分列进入质量台账,解决数据混杂难题。同时,系统支持跨页表格识别与OCR校正,单次可异步处理多达50份、500页文档,通过file_id或file_url提交后,以结构化JSON返回结果。
实际应用中,汽车制造企业通过智能抽取原材料检测数据写入来料检验台账,食品企业则将微生物指标自动录入追溯系统。抽取结果支持回流ERP与质量管理系统,实现检测数据从非结构化文档到业务系统的无缝贯通。
针对环境、建材、食品等领域报告格式差异大、配置成本高的痛点,平台内置环境检测、食品检测、建材检测等行业预置模板,开箱即可启用。模板已固化报告编号、CMA编号等单值字段与检测项目组字段的抽取口径,支持在组织内沉淀GB、ISO、ASTM等标准字段说明,避免同类报告重复配置,确保不同实验室数据口径一致。监理单位启用建材模板后可自动提取混凝土强度、钢筋成分等关键指标,环保监测机构通过环境模板可批量解析废水废气中的污染物浓度与限值对比,直接生成合规台账。
在建筑工程监理场景中,某大型集团监理部门将数百份混凝土与钢筋检测报告智能解析,关键指标自动写入工程监理验收台账,实现施工合规检查与质量追溯;生态环境监测部门则依托异步处理能力,单次提交50份、500页环境监测报告,自动识别跨页表格与骑缝章,将污染物浓度数据实时录入环保合规系统,支撑排污许可执行报告快速编制。
系统支持通过标准RESTful API接入,采用KSO-1签名与Bearer token双重鉴权保障安全。提交任务后无需同步等待,可通过任务ID轮询或回调通知获取结果,返回统一JSON结构包含字段值、置信度及坐标信息,即使面对"<0.01"等特殊符号也能准确识别。解析结果可导出为Excel或JSON格式,直接对接LIMS、ERP及政府监管平台,实现检测数据从原始报告到业务系统的无缝流转。
针对检测报告中CMA资质章、骑缝章与跨页表格等复杂版面元素导致的解析难题,系统依托WPS文档结构解析底座进行OCR校正与版面分析增强,实现章印位置溯源与表格结构重建。通过识别骑缝章覆盖区域与跨页表格的连续性,有效解决数据错位或遗漏问题,确保多页检测报告中的检测项、实测值与结论完整抽取。
为提升非标检测方法的抽取准确性,系统支持为字段配置parent层级明确所属检测项目类别(如重金属检测中的铅含量),设定position页码锁定字段所在具体位置,并通过desc描述以自然语言定义抽取目标(如"提取GB 5009.3-2016标准下的水分实测值")。这种精细化配置与CMA章位置核验相结合,可自动识别资质认定标识的真伪与坐标,确保关键检测数据的可追溯性。
抽取结果以结构化JSON返回,包含字段值、置信度、页面坐标及字段类型等元数据,支持对抽取过程进行全链路溯源。在医疗器械检测场景中,该能力可精准提取生物相容性、性能检测等注册检验要求字段,即使面对复杂版面与特殊符号(如"<0.01")也能保持数据完整性,确保检测数据无缝回流至质量管理系统与监管平台。
针对企业检测数据敏感性与系统异构性挑战,平台支持PDF、某办公软件、图片及扫描件混合批量提交,依托WPS文档解析底座进行OCR校正与版面还原,即使面对复印件模糊、印章遮盖等复杂情况,仍可通过图像增强技术准确识别检测数值与文字信息,确保多源格式报告的统一结构化处理。
在数据安全层面,系统采用KSO-1签名与Bearer token双重鉴权机制,企业须按规范计算KSO-1签名完成身份核验,同时支持私有化部署模式,满足第三方检测机构与制造业质控部门对数据不出库、内网闭环处理的合规要求,保障CMA编号、商业数据等敏感信息的安全性。
解析完成后,检测结果以标准化JSON或Excel格式输出,通过RESTful API直接回流至企业已有的LIMS、ERP及质量管理系统,实现检测项、实测值、合格判定等关键数据从原始报告到业务台账的无缝贯通,消除人工二次录入环节,构建从报告解析到质量决策的自动化数据链路。
来料检测报告格式多样、数量庞大,关键检测项与判定结果靠人工录入,检验周期长且易出错。通过智能解析PDF及纸质报告,自动提取检测项目、实测值与合格判定,写入来料检验台账,实现快速放行。
混凝土、钢筋等建材检测报告格式各异,强度与成分等关键指标依赖人工核对,监理验收周期长且合规风险排查滞后。通过配置建材模板智能抽取关键指标,自动写入工程监理台账,驱动施工合规检查与质量追溯。
批次检验报告数量庞大,微生物、添加剂等关键指标靠人工摘录,检验周期长且易漏检,批次放行决策缺乏数据支撑。通过智能解析自动提取指标与判定结果,写入食品安全追溯台账,打通批次放行与合规监管链路。
检测报告字段提取常面临标准差异、版面复杂与数据混杂三大痛点:不同检测标准(国标、行标、企标)字段口径不匹配,多批次数据挤占单元格导致跨页表格错位,PDF与扫描件混杂依赖人工抄录。建议采用自定义字段配置(设定parent层级、position页码与desc描述),结合OCR校正与跨页表格识别技术解决章印遮盖与数据错位;利用环境、食品、建材等预置模板降低配置成本,通过异步处理与RESTful API实现系统无缝接入。实践表明,该方案可提升来料放行效率80%,降低录入错误率95%,实现检测数据向业务系统的自动化贯通。

智能抽取发票、检测报告等财务单据,支持自定义字段与跨页表格,数据直联ERP,实现业财税高效贯通。




自动解析订单、出库单等业务凭证,精准提取商品与金额信息,助某生某意数据实时入库,降低人工录入成本。

支持项目报告、验收单据的智能抽取,自动识别检测项与实测值,一键生成质量台账,提升项目交付效率。

智能识别合同关键条款、签约主体及印章,支持跨页与扫描件解析,合同数据自动归档,加速法务审批流程。




自动抽取采购单、入库单中的商品、规格与数量,支持多源格式混合提交,进销存数据无缝同步,降低出错率。
支持项目报告、验收单据的智能抽取,自动识别检测项与实测值,一键生成质量台账,提升项目交付效率。
智能抽取发票、检测报告等财务单据,支持自定义字段与跨页表格,数据直联ERP,实现业财税高效贯通。
自动解析订单、出库单等业务凭证,精准提取商品与金额信息,助某生某意数据实时入库,降低人工录入成本。

自动抽取会计凭证、报表及税务文档,支持OCR校正与印章识别,财务数据一键生成,赋能智慧核算与合规。
支持single与group类型字段,按国标、行标、企标灵活增补检测项,解决预置口径不匹配问题。
组字段将同单元格多批检测数据拆为多行记录,实测值、限值分列进入台账,杜绝数据混杂错位。
内置环境、食品、建材等高频模板,固化单值与组字段口径,同类报告可复用,保障实验室数据一致。
OCR增强识别跨页表格与骑缝章,重建表格结构并定位CMA章,确保多页报告数据抽取完整无遗漏。
PDF、扫描件、图片等混合提交,单次最大50份500页,异步处理不卡顿,大批量检测报告高效转化。
结构化JSON/Excel输出,通过API直连LIMS与ERP,消除人工录入,实现检测数据无缝贯通与溯源。
自定义字段配置、跨页表格识别与OCR校正,一键将多源检测报告转为结构化台账,无缝对接LIMS/ERP系统。