

WPS 协作
支持修复后PDF的安全共享与协同编辑,确保跨平台协作时字体编码一致,杜绝乱码复发,实现法律卷宗、设计图纸的高效流转。
支持修复后PDF的安全共享与协同编辑,确保跨平台协作时字体编码一致,杜绝乱码复发,实现法律卷宗、设计图纸的高效流转。

集成OCR识别与智能编码修复技术,自动识别PDF乱码类型并转换为可编辑文本层,支持历史档案、扫描卷宗的AI增强处理。

针对修复后的PDF文本进行深度校对,智能识别医学符号、法律术语等特殊字符准确性,确保OCR识别与编码转换后的数据零差错。

精准提取CAD图纸、财务报表中的表格数据,自动修复因字体缺失导致的乱码数值,支持扫描件表格的OCR识别与结构化转换。

发送PDF时自动检测字体嵌入状态,预警跨系统传输风险,支持大体积扫描卷宗的安全传输,确保法律文件在邮件流转中保持编码完整。
PDF复制文本出现乱码、方框或问号怎么办?本文详解字体未嵌入、编码格式错误、扫描件无文本层等常见原因,提供WPS PDF专业解决方案:通过高精度OCR文字识别、智能字体修复与多编码转换技术,精准提取法律卷宗、金融研报、CAD图纸及病历档案内容,支持批量处理与本地化安全部署,确保跨平台复制准确性,助力企业文档数字化与知识库建设。
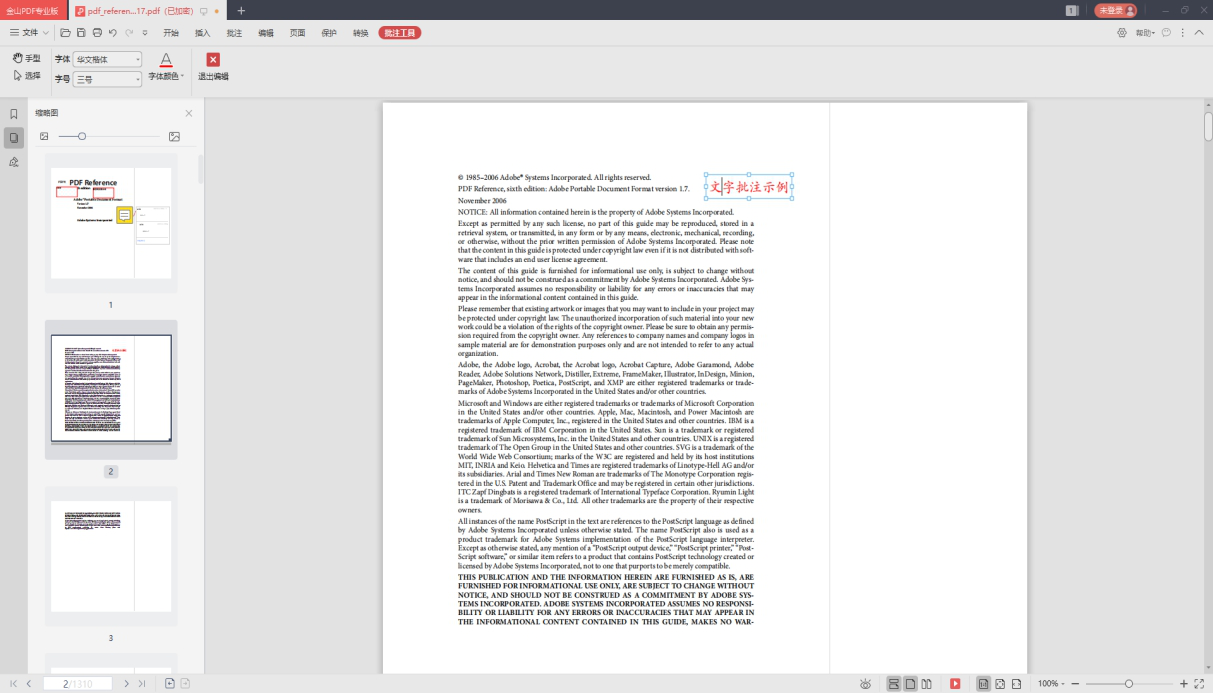
从PDF文档复制文本时出现乱码、方框或问号,主要源于三类技术瓶颈:字体未嵌入导致的字符映射缺失、历史文档编码格式不兼容,以及扫描件本质为图片而非文本层。当PDF使用特殊字体但未嵌入文件时,跨系统传输后常出现复制内容显示为空白或乱码;而早期GBK、Unicode等编码混乱的历史档案,在多平台打开后字符集解析错误,导致内容无法直接引用。此外,图片型PDF或扫描件因缺乏文字层信息,直接复制会抓取到像素噪声而非实际字符,这是金融研报、法律卷宗、病历档案数字化中的常见痛点。
不同行业面临的乱码场景各有特征:建筑设计院CAD导出的技术说明常因字体缺失导致参数复制错乱;律师事务所的扫描版判决书和历史卷宗无法直接检索引用;医疗机构影像设备生成的特殊编码病历,复制时经常出现医学符号与数值丢失。这些乱码问题不仅影响单个文档编辑,更阻碍了企业知识库建设与档案数字化进程,使得跨部门协作时需耗费大量人工进行内容校对与重新录入。
针对上述问题,专业PDF工具提供系统性解决方案:通过OCR文字识别技术将图片型PDF转换为可编辑文本层,利用智能字体匹配修复嵌入缺失导致的编码错误,并支持多语言字符集自动转换以兼容历史文档格式。值得注意的是,此类高级PDF修复功能主要包含在WPS 365商业高级版(399元/人/年)及商业旗舰版(599元/人/年)中,而体验版与商业协作版用户如需使用完整PDF工具、OCR识别及字体修复能力,通常需通过加价购买或联系销售开通相应权限。
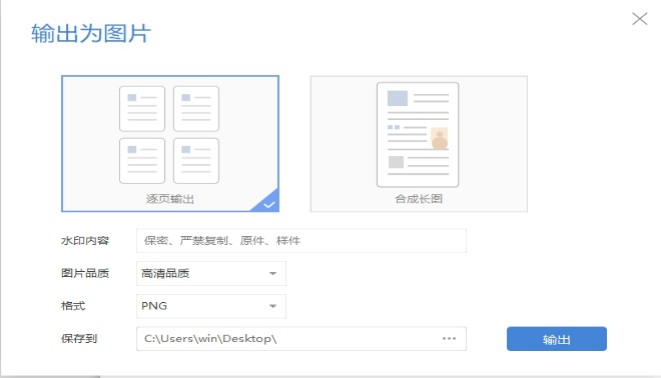
乱码症状的表现形态往往暗示着不同的技术根源。当复制内容显示为方框或问号时,通常预示字体嵌入缺失或字符映射表损坏;若出现无规律的乱码字符组合,则多为GBK与UTF-8等编码格式跨系统传输时的解码错误;而完全无法选中文字或复制后得到空白内容,则表明该PDF实质为图片型扫描件或加密文档限制了文本提取权限。精准识别这些症状差异,是选择正确修复路径的前提。
针对不同的乱码类型,需采取分层修复策略。对于字体缺失导致的符号异常,可通过字体嵌入检测工具识别缺失字体族,利用智能字体替换库自动匹配相似字形进行修复;面对历史文档的编码混乱,应采用多编码格式自动识别技术,在GB2312、Big5、Unicode等字符集间智能转换;而对于扫描件及图片型PDF,则需启用高精度OCR引擎,通过版面分析技术还原段落结构,将像素文字转化为可编辑文本层。值得注意的是,部分加密文档虽表面显示正常,但权限限制会导致复制乱码,此时需先解除文档安全限制再进行文本提取。
在实际操作中,双层PDF构建技术提供了标本兼治的方案。通过在图像层之上叠加可检索的文字层,既保留原始文档的视觉保真度,又确保复制时调用标准编码的文本数据。专业工具如金山PDF提供的批量预处理功能,可自动诊断文档乱码风险类型,对海量历史档案实施字体修复、编码标准化与OCR文字层叠加的批量处理,从根本上消除跨平台复制时的乱码隐患,保障科研数据提取与法律文书引用的准确性。
在头部律师事务所的卷宗数字化实践中,扫描版判决书与历史档案的乱码修复成为提升办案效率的关键。通过部署金山PDF专业版,律师团队利用高精度OCR技术将数万份扫描卷宗转为可编辑文本,彻底解决复制乱码与方框问题,案件材料整理效率提升3倍,实现秒级检索与智能引用,同时通过法律级加密保障客户隐私安全。
金融机构与建筑设计院同样面临特殊字体导致的复制困境。证券公司研究所借助智能编码修复与表格识别技术,精准提取加密研报中的财务数据,数据准确率达99%,支持直接导入量化分析系统;甲级设计院则通过CAD字体修复功能,解决历史图纸技术参数的复制错乱,配合施工现场变更单OCR识别,实现竣工资料100%数字化归档与版本管理。
医疗行业的病历数字化更具挑战性。三甲医院采用医学专用OCR引擎处理DICOM文档与手写病历,不仅解决影像设备生成PDF的复制乱码问题,更精准抓取检查数值与医学符号,科研数据提取准确率达99%,助力医院通过电子病历评级。这些跨行业实践共同证明,结合智能字体匹配、编码自动转换与高精度OCR的系统性方案,不仅能根治复制乱码顽疾,更能构建安全合规的企业知识库,推动文档管理从人工录入向智能数据提取的范式转变。
企业在选择PDF乱码修复工具时,面临在线转换与本地专业软件的关键抉择。普通在线工具虽能处理简单格式转换,但难以解决字体编码层级的深度损坏,且上传敏感文档至云端存在严重的隐私泄露风险,对于法律卷宗、医疗病历、金融研报等机密文件尤为危险。相比之下,金山PDF专业版采用本地化智能处理架构,在隔离环境中完成字体嵌入修复、编码转换与OCR识别,确保核心数据不出本地,满足政企单位的合规审计要求。
深度修复能力与批量处理效率是专业方案的核心指标。不同于仅做表面格式转换的通用工具,企业级解决方案需具备字符集智能嗅探、缺失字体自动匹配、复杂版面还原等底层技术,能够精准修复GBK/Unicode编码混乱、CAD特殊字体映射错误等复杂场景。同时,面对档案馆、律所动辄数万份的历史卷宗,批量自动化处理能力与API系统集成接口,可将数字化效率提升十倍以上,显著降低人工校对成本。
对于跨国企业、政府机关及涉及敏感数据的行业而言,选择具备端到端加密、细粒度权限管控的本地PDF修复方案,不仅是解决乱码的技术需求,更是构建文档安全防线的基础设施建设。通过私有化部署实现从源头预防(字体嵌入检测)到事后修复(OCR抢救)的全生命周期管理,方能真正打通企业知识库建设的最后一公里。
扫描件判决书复制乱码,导致案件材料整理耗时易错。采用WPS PDF OCR与智能排版修复,将扫描卷宗转为可编辑文本,精准提取法条与判决内容,实现全文检索与引用。
加密研报复制出现乱码与表格错乱,财务数据难以提取。通过WPS PDF金融OCR与智能编码修复,精准识别研报文字与表格,数据结构化导出至Excel,彻底解决乱码与数据丢失。
影像设备PDF病历复制乱码、无法选中文字,影响病案摘要与科研数据提取。部署医学专用OCR引擎,智能识别病历文字与检查数值,将扫描病历转为结构化电子档案,修复乱码与缺失符号。
PDF文本复制乱码主要源于三类技术瓶颈:字体未嵌入导致字符映射缺失、历史文档编码格式(如GBK/Unicode)不兼容,以及扫描件本质为图片而非文本层。症状表现各异:方框/问号多因字体缺失,无规律乱码常为编码错误,无法选中则表明是图片型PDF。针对这些问题,建议采用OCR文字识别技术提取图片型PDF内容,利用智能字体匹配修复嵌入缺失,通过编码转换兼容历史文档。企业用户应优先选择本地化专业工具(如金山PDF),确保敏感数据不出本地,同时利用批量处理功能提升效率,构建安全合规的知识库。

WPS合同管理集成智能PDF修复引擎,自动识别扫描合同中的乱码与方框,精准提取条款文字,保障法务审查与归档时内容零差错,显著提升合同数字化管理效率。




好生意无缝对接WPS PDF处理能力,进货单、销售报表等PDF复制不再出现问号或乱码,数据准确率达99%,助力小微商户实现单据高效录入与智能分析。

好会计内置编码自动转换与 OCR 识别,解决财务凭证 PDF 的复制乱码难题,确保数字、符号完整提取,让税务申报与审计底稿整理更精准可靠。

好业财借助WPS文档修复技术,对业财 PDF 报表进行乱码纠偏与文字层重建,财务数据提取准确率高达99%,为企业经营分析提供可靠数据底座。



好生意无缝对接WPS PDF处理能力,进货单、销售报表等PDF复制不再出现问号或乱码,数据准确率达99%,助力小微商户实现单据高效录入与智能分析。
好会计内置编码自动转换与 OCR 识别,解决财务凭证 PDF 的复制乱码难题,确保数字、符号完整提取,让税务申报与审计底稿整理更精准可靠。
WPS合同管理集成智能PDF修复引擎,自动识别扫描合同中的乱码与方框,精准提取条款文字,保障法务审查与归档时内容零差错,显著提升合同数字化管理效率。

WPS进销存依托PDF OCR与字体修复技术,消除库存单据、采购单复制时的乱码与空白,数据准确同步,让盘库与对账从人工录入转向智能提取。

WPS项目管理将CAD图纸、技术说明等PDF乱码一站式修复,保留原始参数与排版,确保跨部门协作时文档内容精准传递,加速项目交付与验收。
自动匹配缺失字体,解决复制出现方框或问号问题,确保文本显示正常。
高精度识别扫描件与图片PDF,还原段落结构与排版,复制准确率超99%。
一键检测并修复GBK、UTF-8等编码混乱,杜绝跨平台乱码与格式错乱。
自动诊断海量文档乱码风险,批量修复字体、编码与叠加文字层,效率倍增。
本地化处理敏感文档,杜绝云端泄露风险,满足法律、金融等合规要求。
识别复杂版面与表格,精准提取财务数据、技术参数,保留原始格式逻辑。
集成高精度OCR、智能字体修复与多编码转换,让扫描件、加密文档与历史档案的文本提取准确率达99%,安全本地化处理,杜绝隐私泄露。
