

WPS PDF
解决OCR识别与PDF转换中的形近字混淆问题,穿透图文层精准定位"己/已/巳"等错误,支持扫描件批量校验,确保数字化文档准确性。
解决OCR识别与PDF转换中的形近字混淆问题,穿透图文层精准定位"己/已/巳"等错误,支持扫描件批量校验,确保数字化文档准确性。

解决海量历史档案与OCR识别稿的批量排查难题,自动标记"未/末"等易混字,生成风险分布报告并精确定位,实现数万字/分钟处理速度。

解决数据录入环节的形近字预防问题,实时拦截"人/入""土/士"等错误,结合上下文语义即时预警,降低手写转录偏差风险。

解决专业术语深度辨析需求,内置医学、法律等50+行业词库,精准区分"氨/胺""定金/订金"等异义词,构建零差错内容生产防线。

解决表格金融数据的形近字风险,精准识别"壹/弌""仟/阡"等大写金额错误,支持复杂排版深度检查,防范一字千金的法律经济风险。
WPS黑马校对提供形近字智能辨析功能,基于AI字形分析与上下文语义判断,精准识别"己已巳""戊戌戍"等通用形近字及OCR识别错误。内置医学、法律、财经等50+行业专业词库,可辨析"氨/胺""权力/权利"等专业术语,支持批量文档扫描与风险定位。有效解决古籍整理、教育出版、法律金融文档中的形近字混淆问题,降低人工审校强度,防范因一字之差导致的法律风险与经济损失,提升文档准确性与专业性。
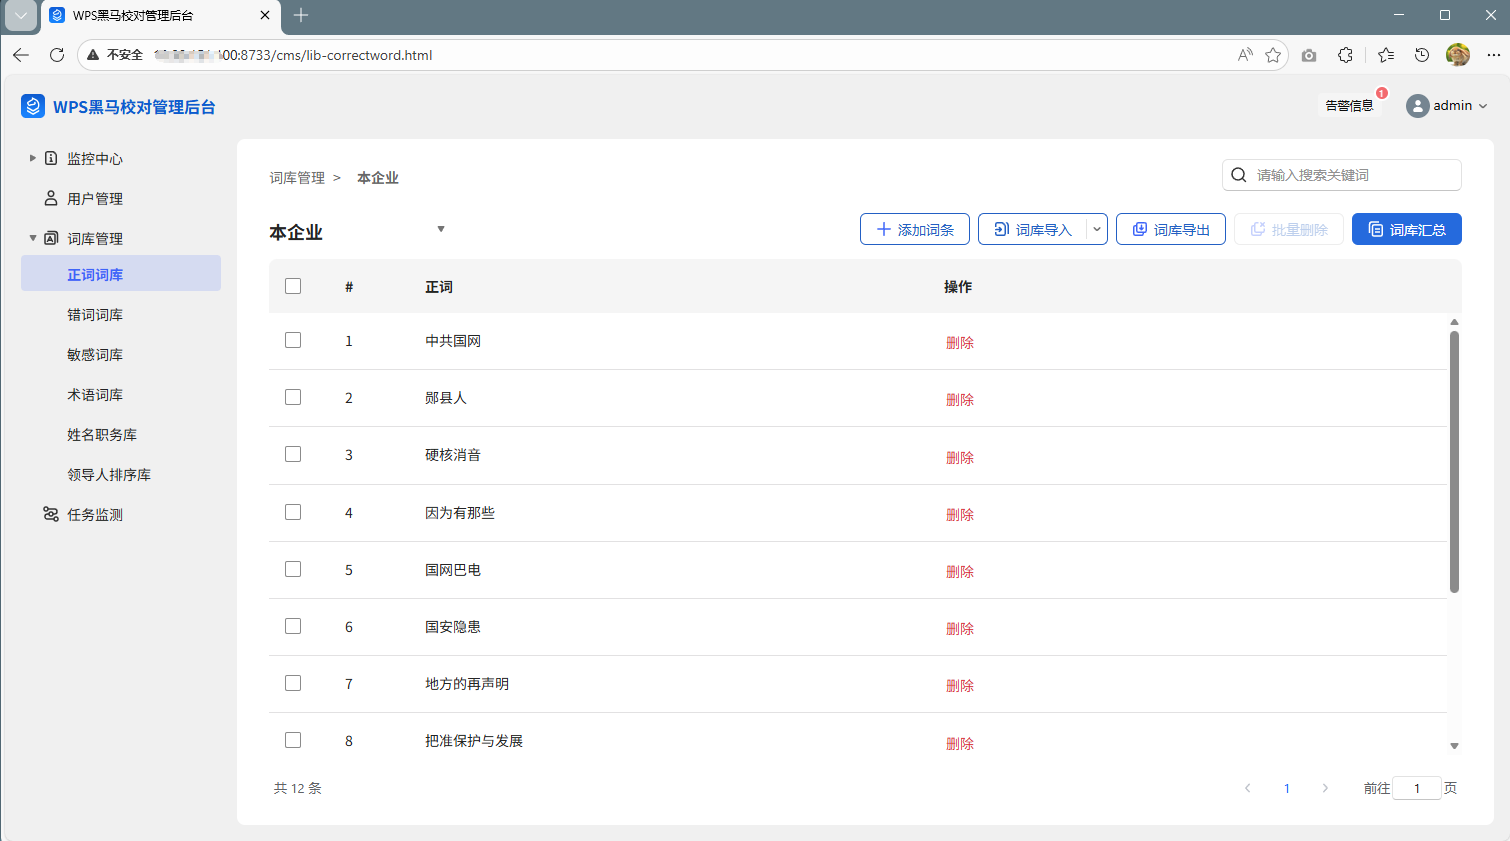
在文档处理与内容生产场景中,形近字混淆(如"己已巳"、"未末"、"人入")是引发语义偏差与法律风险的隐形隐患,尤其在OCR识别、手写稿转录及关键数据录入过程中,视觉疲劳极易导致"戊戌戍"、"兖衮"等错误遗漏。基于《通用规范汉字表》及现代汉语语料库的形近字智能辨析技术,通过AI字形分析与上下文语义判断,不仅能精准识别通用形近字,更能针对古籍整理中的避讳字异体字、教育出版中的基础汉字规范、学术领域的化学医学术语(如"氨胺"、"醛酮")以及法律金融文本中的"权利权力"、"定金订金"等专业形近异义词进行深度校验。
对于企业用户而言,WPS 365提供分层的AI能力支持:体验版及商业协作版(199元/人/年)可满足基础文档的通用形近字识别需求;而涉及医学、法律等50+个行业专业词库及批量历史文档扫描等企业级功能,则需依托商业旗舰版(599元/人/年)的完整AI Hub与AI写作助手能力。值得注意的是,部分专业领域形近字库及深度定制化功能可能需联系销售开通或属于加价购项目,建议企业根据文档安全等级与专业校对需求选择适配版本,避免因一字之差造成不可挽回的学术声誉损失或经济法律风险。
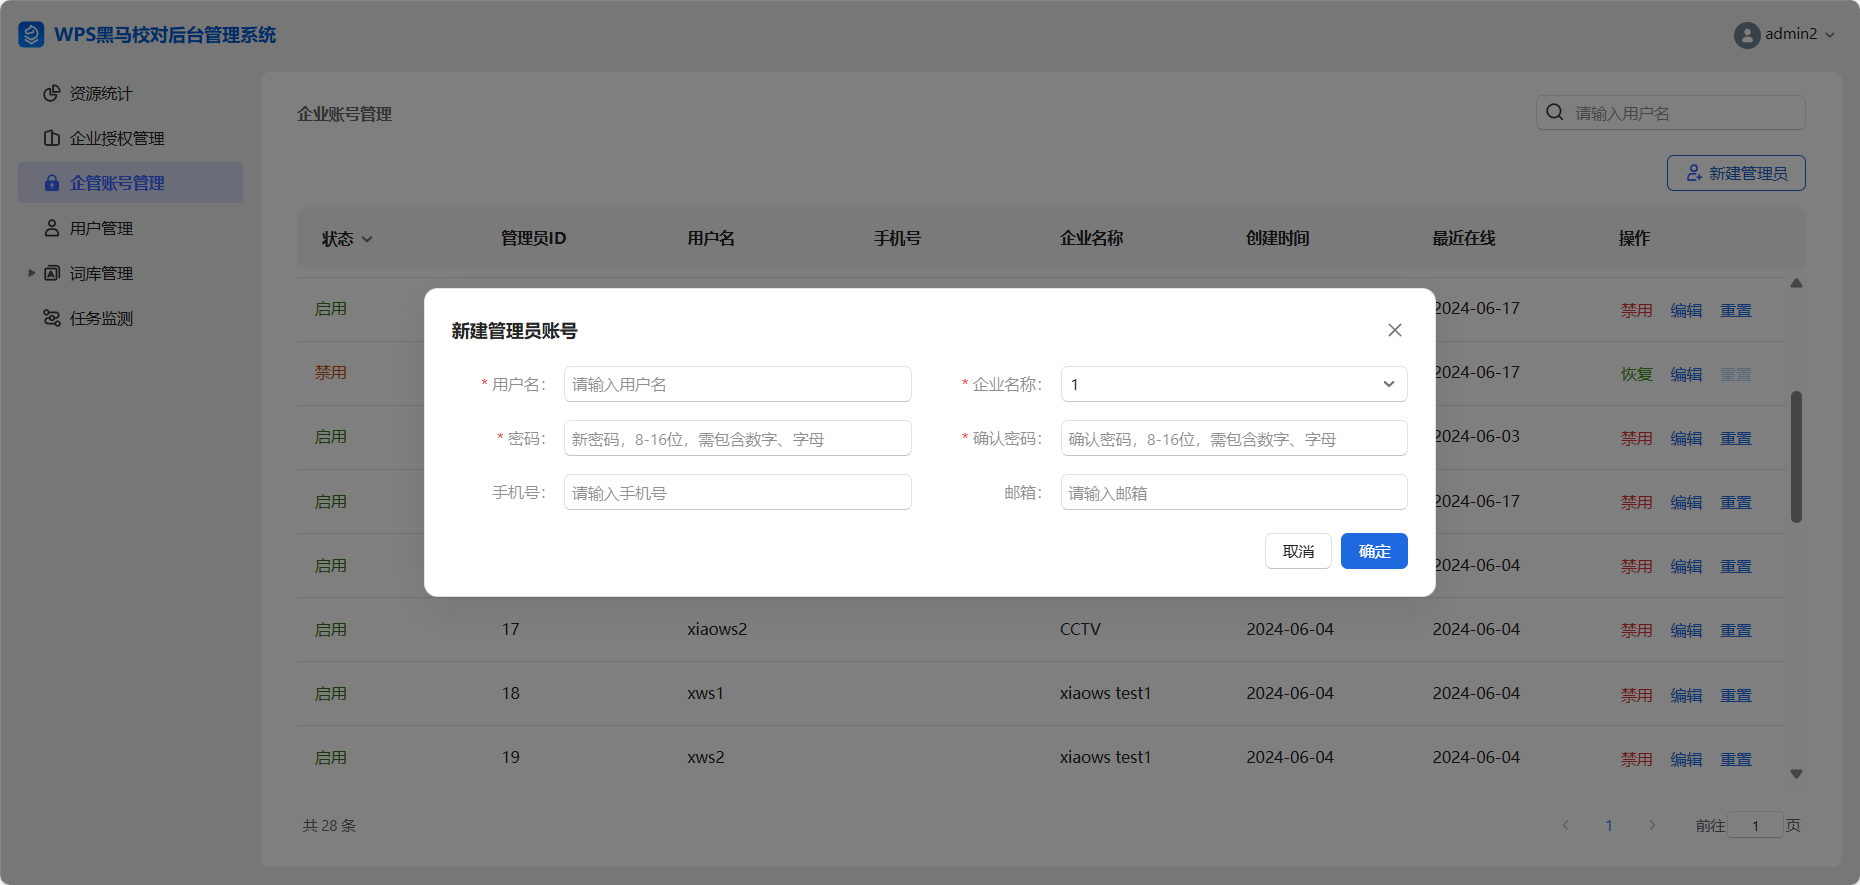
针对专业出版与文档数字化场景,形近字辨析的核心价值不仅在于识别"人入""未末"等通用易混字,更在于对垂直行业术语的深度理解。系统内置医学、法律、财经、化工等50余个行业形近字专业库,可精准区分"氨/胺""醛/酮""权力/权利""定金/订金"等专业领域形近异义词,避免通用规则误判。同时,针对古籍整理中的避讳字异体字、教育出版中的基础汉字规范,以及学术文献中的化学符号与汉字混排问题,提供专项识别引擎,确保各专业场景下的文字严谨性。
在企业级应用层面,批量形近字扫描与定位功能解决了海量文档排查难题。支持对OCR识别稿、历史档案及集团文档进行全量批量扫描,可成批查找特定形近字对(如所有"未/末"混用处),生成风险分布统计报告并精确页码定位,实现每分钟数万字的处理速度。实际应用中,某省级古籍整理中心成功修正"戊戌/戊戍""兖州/衮州"等混淆三百余处,某教育出版社在教材审校中识别"人/入""土/士"等问题两百余处,某法律出版社则在法规汇编中排查关键术语混用四十余处,显著降低人工审校强度与视觉疲劳导致的遗漏风险。
针对OCR识别错误、手写稿转录偏差及图文混排文档中的隐蔽形近字风险,智能辨析系统提供全场景覆盖能力。无论是扫描件中的"己/已/巳"混淆,还是PDF转换后的"未/末"错误,系统均能穿透图文层精准定位,彻底解决人工审校因视觉疲劳导致的遗漏问题。支持对文本框、表格、页眉页脚等复杂排版区域的深度检查,确保古籍数字化、档案整理等场景下的文字准确性。
在交互体验上,系统提供高亮标注与一键修正建议,用户可快速审阅"戊/戌/戍"等疑似错误,结合上下文语义判断实现安全替换。支持自定义企业专用形近字词库,将特定行业术语、企业名称中的易混字纳入校对规则,实现个性化精准风控。批量处理功能可在数分钟内完成传统人工数小时的抽检工作,实现全量文档100%覆盖。
在关键业务场景中,系统重点防范一字千金的致命风险:自动校验法律合同中的"权利/权力""侦查/侦察"等术语混用,识别金融文本中大写金额"壹/弌""仟/阡"的形近错误,以及医学文献里"氨/胺""苷/甙"等药品名混淆。通过持续更新的50+个专业领域词库,确保从基础教育教材到高精尖学术著作的全谱系内容安全,为出版机构、律所、金融机构构建零差错的内容生产防线。
传统文档审校依赖人工逐字比对,不仅效率低下更易因视觉疲劳导致遗漏。形近字智能辨析技术通过嵌入写作与审校全流程,实现了从"事后纠错"向"实时预警"的范式转变。在内容生产阶段即对"己/已/巳""未/末"等高危形近字进行高亮标注与即时提示,大幅降低编校人员用眼强度;结合上下文语义分析的精准推荐,使审校人员从繁琐的字形比对中解放,专注于内容逻辑与专业深度的把关,构建起"AI预处理+人工终审"的高效协同新模式。
在关键业务风控层面,该技术已成为防范"一字千金"风险的核心屏障。系统针对合同条款中的"定金/订金"、医疗文书中的"氨/胺"、金融数据中的大写金额形近字等高危场景设置专项校验规则,通过自定义企业专用词库与敏感词双重排查,确保特定行业术语、企业名称及关键数据的绝对准确。这种前置化风险管控不仅避免了因形近字混淆导致的法律纠纷与经济损失,更在古籍整理、学术出版等领域维护了文化传承与学术传播的严肃性。
系统支持持续学习的智能优化机制,能够根据用户修正反馈与企业特定用语习惯,动态更新形近字识别模型与专业词库。无论是应对OCR识别稿的批量纠错,还是图文混排文档的隐蔽错误排查,均能通过一键批量修正与安全还原操作,在保障文档安全的前提下实现全量内容覆盖。这种兼具精准度与灵活性的智能审校能力,正成为出版、法律、金融等机构构建内容安全生产体系的标准配置。
在《地方志珍本丛刊》数字化中,OCR稿形近字如“戊戌/戊戍”“兖州/衮州”混淆严重,避讳字、异体字识别困难。引入形近字智能辨析与古籍专用规则库,实现批量扫描与精准修正。
小学语文教材审校中,“人/入”“土/士”“已/己”等形近字易混淆,人工排查工作量大且易疏漏。部署笔画级形近字辨析,在审校流程中实时预警与提示。
《民法典释义》及金融法规汇编中,“权利/权力”“侦查/侦察”等术语混用,大写金额形近字“壹/弌”等错误难以发现。利用法律专用词库与形近字辨析,批量排查关键术语。
形近字辨析技术基于深度学习和50+专业词库,精准识别“己已巳”“戊戌戍”等通用形近字及“定金订金”“权利权力”等专业术语,解决OCR识别、手写稿转录及图文混排中的隐蔽错误。支持古籍避讳字、异体字及批量文档扫描,实现每分钟数万字的全量校验,构建“AI预处理+人工终审”的高效模式,有效防范法律纠纷、经济损失及学术声誉风险,为出版、法律、金融、教育等行业提供零差错内容安全保障。

WPS 合同管理,集成智能校对引擎,自动识别合同中的“定金/订金”“权利/权力”等关键术语形近错误,助力企业规避法律风险,提升合同规范性。




WPS 项目管理,提供项目文档批量审校与形近字预警,确保方案、报告用字准确,降低沟通误解,提升项目交付质量。

好生意进销存,集成WPS文档校对能力,自动核查出入库单、发票中的金额大写、品名形近错误,保障数据精准,避免财务损失。

好业财业财一体化,结合WPS智能校对,自动校验财务报告、合同中的专业术语与数字形近字,确保财税文档合规准确,提升审计效率。




好会计智能财税,内嵌WPS形近字校对,自动检测会计凭证、报表中的金额数字、科目名称易混字,防范财务录入差错,保障账务清晰。
好生意进销存,集成WPS文档校对能力,自动核查出入库单、发票中的金额大写、品名形近错误,保障数据精准,避免财务损失。
WPS 合同管理,集成智能校对引擎,自动识别合同中的“定金/订金”“权利/权力”等关键术语形近错误,助力企业规避法律风险,提升合同规范性。
WPS 项目管理,提供项目文档批量审校与形近字预警,确保方案、报告用字准确,降低沟通误解,提升项目交付质量。

WPS 进销存,支持海量单据批量扫描,精准识别商品名、规格形近混淆,确保库存账实一致,降低因一字之差导致的经营风险。
自动校验“权利/权力”“定金/订金”等术语混用,一字之差规避百万级法律风险。
精准区分“氨/胺”“苷/甙”等药品名混淆,避免用药说明产生致命歧义。
专项识别避讳字、异体字及“戊戌/戊戍”等混淆,守护文化传承的严谨性。
扫描大写金额“壹/弌”“仟/阡”形近错误,确保票据与报表数字绝对准确。
捕捉“人/入”“未/末”等基础汉字混淆,为教育出版筑牢文字规范防线。
穿透图文层定位扫描件中的“己/已/巳”等错误,分钟级完成全量修正。
基于AI字形分析、上下文语义及50+行业词库,精准识别形近字与专业术语混淆,提供全流程实时预警与批量处理,防范法律与商业风险。
