

AIPPT
基于识别文档一键生成PPT,智能排版提炼内容,让扫描件数字化成果直接转化为演示汇报。
基于识别文档一键生成PPT,智能排版提炼内容,让扫描件数字化成果直接转化为演示汇报。

支持网页端直接打开与编辑双层PDF及扫描文档,无需安装客户端,实现跨平台在线协作办公。

OCR识别的表格数据一键导入多维表格,轻松对接业务系统,实现质检工单与发票信息的结构化流转。

扫描合同与公文识别后,任务自动同步至待办中心,跟踪审批进度,确保档案数字化流程高效闭环。

针对OCR识别后的文档进行智能校对,快速纠正识别偏差与文字错误,保障公文、病历及合同内容准确性。
扫描件PDF在OCR识别过程中常出现文字模糊乱码、段落排版错乱、印章遮挡文字提取失败、表格结构错位及手写体识别率低等常见问题。本文围绕高校古籍数字化、制造质检工单录入、国企合同发票审核及医院病历归档等核心场景,系统解析WPS 365内置金山PDF OCR引擎的本地识别、智能版式还原与双层PDF生成能力,支持扫描件一键转可编辑、可搜索、可复制的电子文档,无需上传云端即可完成批量处理与业务系统对接,全面保障政企文档安全并显著降低人工校对成本。
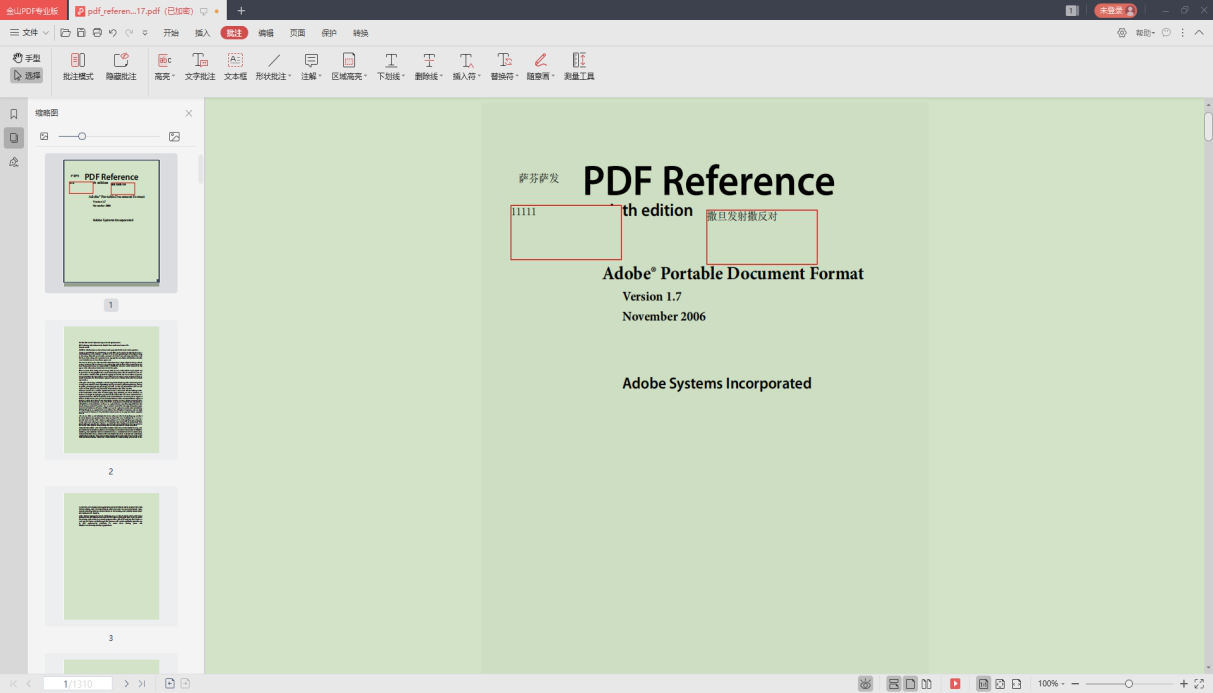
扫描件文字识别在纸质文档数字化过程中,常面临识别质量与版式还原两大类问题。一方面,扫描分辨率不足、页面倾斜或存在阴影干扰时,容易造成文字提取模糊、乱码甚至无法识别;另一方面,中英文混排、复杂表格、多栏排版及印章遮挡等情形,往往导致识别后段落错位、格式混乱,仍需大量人工校对。此外,手写体因字迹差异大、医学或古籍中的生僻字及特殊符号,也是传统OCR容易失效的高频场景。
在高校古籍与科研文献、制造企业质检工单、国企合同发票及医院病历等实际案例中,用户普遍遇到复杂公式与图表丢失、红色印章下文字提取失败、表格结构错乱等问题,使得扫描件虽已完成数字化,却依旧难以直接检索、引用或录入业务系统。同时,涉密文档的上传顾虑与批量处理效率瓶颈,也进一步加剧了档案“沉睡”现象。
针对上述难题,WPS 365内置的金山PDF OCR引擎提供本地识别与智能图像预处理能力,可在商业高级版(399元/人/年)及商业旗舰版(599元/人/年)中直接使用,无需上传云端即可将扫描件转换为可编辑、可搜索的双层PDF,有效保障数据安全。不过,手写体识别目前仍受个体字迹差异影响,准确率相对有限;若文档带有水印遮挡,也建议在完成识别后再添加水印,以避免干扰文字提取效果。
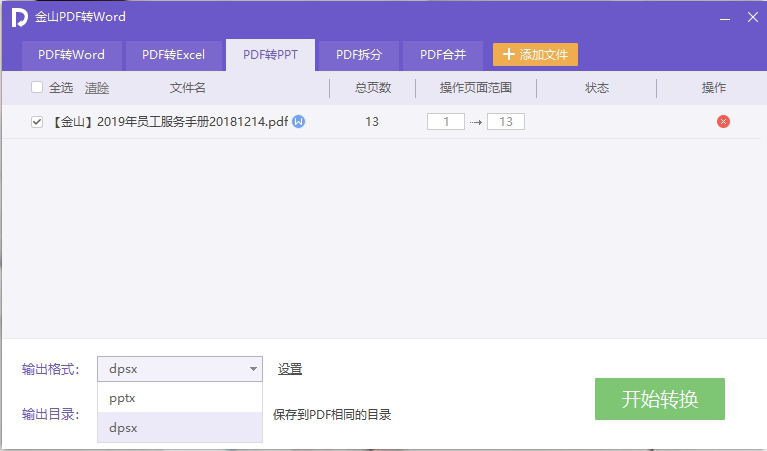
纸质文档经OCR识别后并非数字化终点,如何在保障安全的前提下让文字真正"活"起来,是政企机构面临的深层痛点。一方面,合同、发票、病历及军工档案等涉密扫描件某依某赖在线识别工具,数据上传至公有云即存在不可控的泄露风险,完全违背金融、医疗、政务等领域的数据安全合规要求;另一方面,识别结果若仅输出为单层图片或版式错乱的临时文档,缺乏符合长期保存规范的透明隐藏文字层,既无法实现全文检索,也难以作为具有法律效力的电子档案直接归档。
更棘手的是,传统流程中扫描、识别、编辑、录入业务系统各环节严重割裂。工程师需在多个软件间反复切换,质检表格无法精准导出至Excel并对接MES系统,病历数据难以结构化进入HIS,海量纸质工单与发票仍需大量人工二次录入,数字化成果沦为无法流转的"信息孤岛"。
针对上述障碍,采用本地OCR引擎与双层PDF生成能力,扫描件可在离线环境下完成从文字提取到标准归档、再到业务系统对接的闭环流转。这不仅满足数据不出本地的安全合规底线,更通过识别后直接编辑、批量导出与深度集成,彻底破解"识别后仍无用"的数字化困局。
不同行业的扫描件形态千差万别,对 OCR 的核心诉求早已超越单纯提取文字,而在于版式精准还原与业务系统无缝对接。高校古籍竖排文献、制造车间复杂质检表格、国企红色盖章合同、医院手写病历等场景,均要求识别结果完整保留原始排版逻辑,并能直接用于后续编辑、检索与数据流转。
在高校与科研领域,针对竖排文字、复杂公式及图文混排,金山 PDF 通过智能版式解析生成双层 PDF,在保持古籍图像原貌的同时嵌入可检索隐藏文字层,使数百万页馆藏资源一键活化,复杂版式识别准确率达 98% 以上,在线检索与引用效率提升数倍。面向高端制造与供应链场景,工程图纸参数提取、工单与质检报告表格一键导出 Excel 并接入 MES、ERP 系统,将原本数小时的人工录入压缩至分钟级,一套 WPS 365 即可替代传统 OCR、PDF 编辑与格式转换等多套工具,显著降低采购与管理成本。而在国企法务财务及医疗病案管理中,红色印章遮挡文字智能识别、公文多栏排版高度保真转换、手写病历与检验单结构化提取,确保扫描件修改后完全符合公文合规与电子病历长期保存规范,扫描公文审核周期可缩短一半以上,病案检索时间从数十分钟降至两分钟以内。
全程基于本地识别引擎离线运行,配合 WPS 365 深度集成,政企机构无需在多个软件间反复切换,更无需将涉密文档上传云端。在国产化自主可控的底座之上,纸质档案得以从“沉睡的图片备份”真正转化为可检索、可编辑、可流转的数字资产,全面支撑智慧校园、数字档案馆与无纸化合规办公建设。
要确保扫描件文字识别达到最佳效果,前期图像预处理与后期文档安全管理缺一不可。在识别前,建议将扫描分辨率设置为300dpi以上,并确保页面平整、光照均匀、无阴影干扰;若扫描件存在倾斜,应先使用金山PDF的页面纠偏功能校正文档角度,避免图像歪斜导致文字提取错误或产生乱码。对于带水印的文档,建议在OCR完成后再添加水印,以免水印遮挡文字或干扰识别算法。识别过程中,根据文档实际语言在OCR设置中选择对应语言包,可显著提升中英文混排及多语言场景的识别准确度;多页扫描件合并后重新识别也不会丢失原有图像信息,系统将自动生成新的隐藏文字层。
识别完成后,若出现段落排版错乱,可进入编辑模式,利用段落对齐与文本框工具重新划分文字区域,手动调整字体大小、行距和段间距,快速恢复文档的规范版式。对于需要长期归档或涉密流转的文件,建议将识别结果另存为双层PDF格式,上层保留原始扫描图像,下层嵌入可检索隐藏文字层,既符合国家电子档案长期保存规范,又支持全文检索与在线批注。此外,可通过金山PDF的文档加密功能为PDF分别设置打开密码与权限密码,严格限制非授权访问及编辑,确保识别后的敏感信息在本地环境下得到全方位防护,真正实现从高质量识别到安全资产管理的闭环。
馆藏30万册古籍及民国文献扫描件堆积,传统OCR无法识别竖排、手写与复杂图表,导致全文检索困难。采用金山PDF教育版批量OCR识别与双层PDF转换,实现复杂版式精准还原与在线阅览。
车间纸质工单与供应商图纸扫描后无法提取文字和表格数据,依赖多套工具处理效率低。通过WPS 365内置OCR直接编辑扫描件、导出质检表格至MES,打通生产数据流转。
历年积存扫描公文、盖章合同与发票为图片PDF,多栏排版和红章遮挡导致转换后版式失真。使用WPS PDF实现扫描件直接编辑与高保真转版,统一处理合同与财务票据。
扫描件OCR常面临图像质量与版式还原双重挑战:分辨率不足、页面倾斜、阴影或水印遮挡易导致文字模糊、乱码;中英文混排、复杂表格、多栏排版、印章遮盖及手写体、生僻字、公式图表则易引发结构错乱与识别失效。建议扫描时采用300dpi以上高清图像并预先纠偏,选择本地OCR引擎保障数据安全,识别时匹配对应语言包,识别后利用编辑工具校正版式并另存为双层PDF,以实现高质量识别与长期归档利用。

结合WPS PDF本地OCR识别,快速提取扫描合同关键字段,生成可搜索双层PDF,保障合同安全归档与高效审批,助力法务管理合规。




利用金山PDF OCR将纸质进货单、销售单精准转为电子数据,直接导入进销存系统,实现进销存自动录入与实时流转,告别手工录单。

基于WPS PDF发票识别能力,智能提取扫描发票与凭证信息,对接好会计自动生成凭证,缩短记账周期,提升财务数据准确率。
结合WPS PDF本地OCR识别,快速提取扫描合同关键字段,生成可搜索双层PDF,保障合同安全归档与高效审批,助力法务管理合规。
利用金山PDF OCR将纸质进货单、销售单精准转为电子数据,直接导入进销存系统,实现进销存自动录入与实时流转,告别手工录单。

项目文档扫描件经WPS PDF本地识别后,可一键生成双层可检索PDF,规范化归档项目资料,方便团队随时查阅,提升协作效率。

借助WPS PDF识别技术,将纸质业务单据快速转为结构化数据,无缝对接好业财,实现财务业务一体化,降低人工录入成本与差错率。




搭配金山PDF OCR,纸质销售单据智能识别并自动填充至好生意系统,打通批发零售数据链路,让生意管理更实时、更精准。
基于WPS PDF发票识别能力,智能提取扫描发票与凭证信息,对接好会计自动生成凭证,缩短记账周期,提升财务数据准确率。
离线OCR引擎不上传云端,严防涉密文档泄露,满足政务金融合规要求。
智能解析复杂排版,保留原文结构,段落格式高度还原,降低校对成本。
生成可检索隐藏文字层,保留原始图像,符合电子档案长期保存规范。
支持多页批量识别转换,分钟级完成海量文档数字化,释放人力资源。
质检报告、发票表格一键导出Excel,无缝对接MES/ERP等业务系统。
中英文及多语种混排深度优化,生僻字、公式精确提取,满足多元需求。
使用WPS 365内置OCR引擎,离线识别扫描件,生成可搜索双层PDF,兼顾版式还原与数据安全。
