

WPS PDF
OCR扫描件精准识别,结合形近字纠错引擎自动修正"己/已/巳"等字形错误,确保PDF文档转换与校对质量。
OCR扫描件精准识别,结合形近字纠错引擎自动修正"己/已/巳"等字形错误,确保PDF文档转换与校对质量。

结构化管理8000余组形近字特征库与行业术语规则,支持自定义混淆对分类存储,实现校对规则团队共享。

在财务报表与法律条文中自动识别"壹/弌""账/帐"等形近字错误,结合数值上下文校验,保障专业文档零差错。

远程校审会议中实时共享文档界面,协同讨论"定金/订金"等高危险形近字修正方案,录制复核过程确保决策可追溯。

支持多人实时协同编辑与批量替换,共享自定义形近字词库,确保古籍整理、法律审校等长周期项目团队用字规范统一。
WPS黑马校对形近字纠错完整流程涵盖文档扫描、OCR文字提取、8000余组形近字特征库比对、NLP语义分析及修正建议生成。系统精准识别"己已巳""人入八"等高频混淆字,支持古籍、法律、医学、金融等20+专业领域深度核查,10万字3分钟批量扫描,错误率降低90%以上,满足出版社与政务机关零差错审校需求。
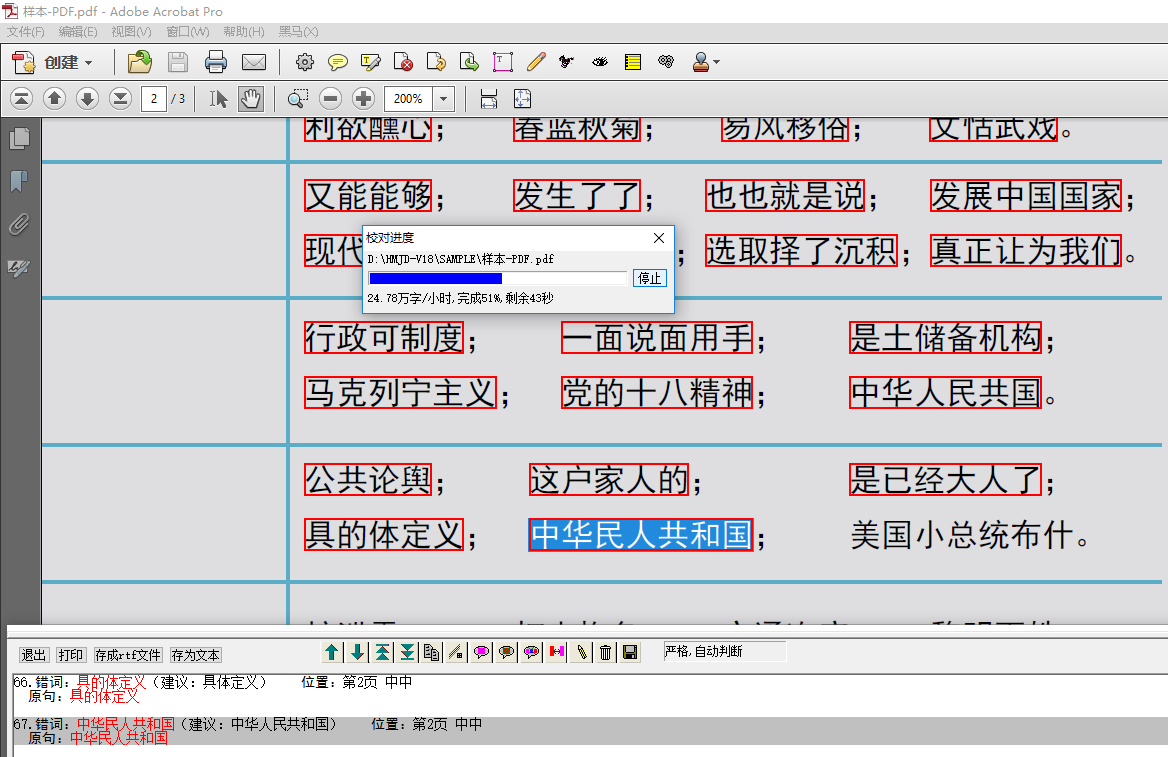
形近字纠错的完整流程始于文档扫描与文字提取,系统基于深度学习构建的形近字特征库——涵盖8000余组高频及生僻字形比对规则——对字符进行笔画结构向量比对与相似度计算,快速定位"己已巳""人入八"等疑似错误;继而通过NLP语义分析引擎结合上下文语境进行双重校验,判断用字合理性并生成修正建议,最终在界面中高亮标注可疑字词并展示候选替换方案,支持用户逐条确认或批量替换。
该流程的核心技术支撑包括Unicode全字符集结构分析与OCR识别后纠错能力,可处理简繁混合文本及古籍异体字对应关系;用户还可自定义专属形近字词库,添加行业特殊混淆对以贴合专业场景。对于法律条文中的"权利/权力"、医学术语中的"戌/戍/戊"、财经文本中的"壹/弌"等专业领域形近字,系统整合20+行业术语库进行深度核查,确保特定语境下的用字精准性。
需要注意的是,形近字智能纠错引擎作为WPS黑马校对的高级功能,在企业部署时需关注版本权限差异:WPS 365商业高级版(399元/人/年)与商业旗舰版(599元/人/年)支持文档安全与企业级AI能力,但部分深度功能可能需加价购买或联系销售开通;而素材库、项目管理等增值服务在各档套餐中均需额外付费。古籍出版、法律审校等典型用户可通过该流程将数字化错误率降低90%以上,但具体功能可用性以实际授权范围为准。
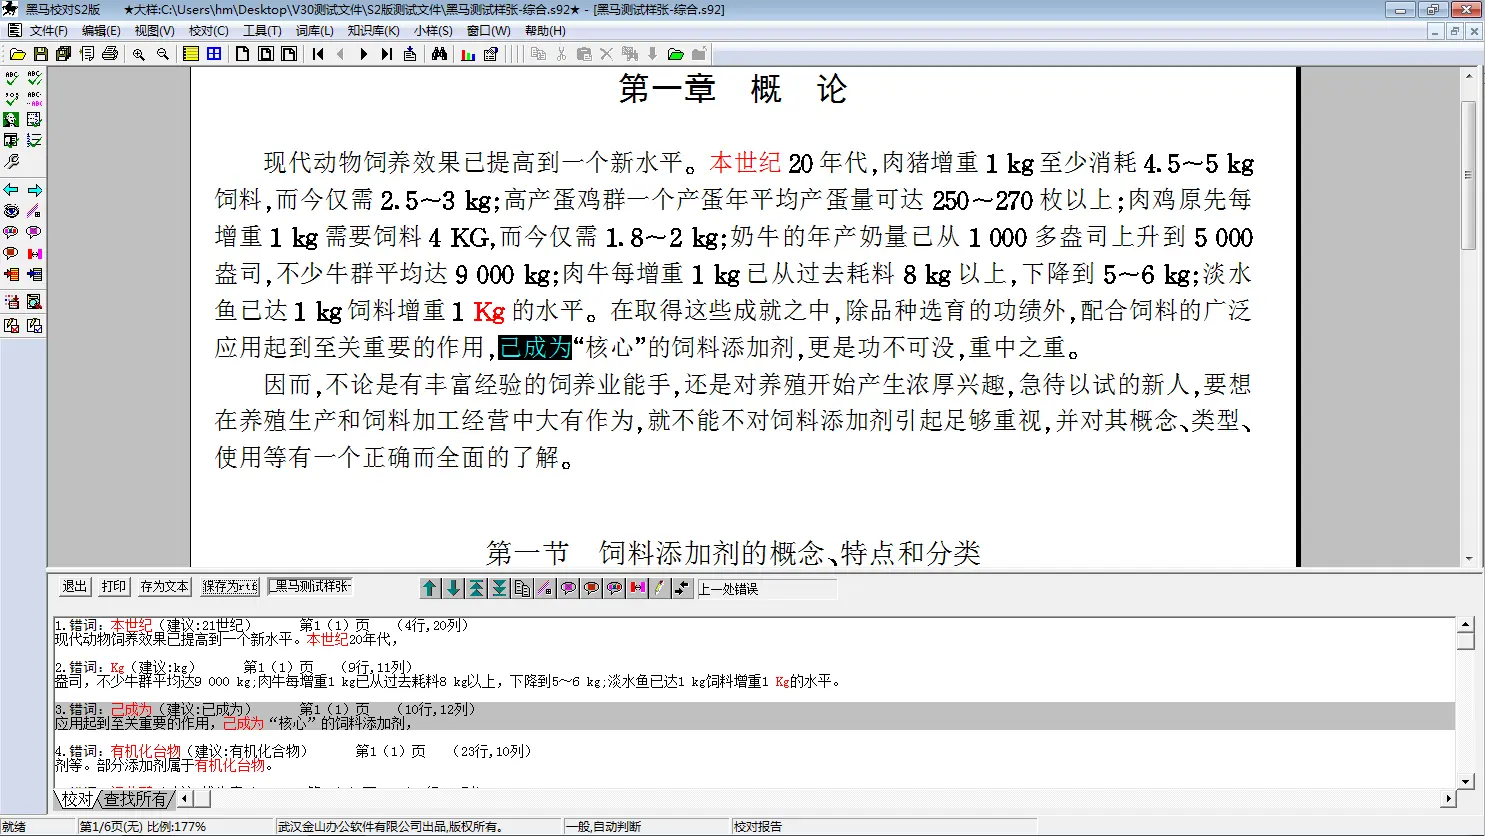
在基础形近字识别之上,完整流程还包含敏感形近字风险防控环节,专门针对利用字形变体规避内容审查的风险场景。系统对接国家敏感词规范与政治用语标准,建立形近字敏感词特征库与政治风险字形数据库,可智能识别"习/羽""平/苹"等规避审查的形近字伪装,结合政治语境理解能力进行实时风险提示与分级预警,确保政务系统与媒体单位的内容安全。
技术实现层面,流程依托深度学习形近字特征库与字形结构拓扑分析,对Unicode全字符集进行结构向量比对,相比传统词典匹配可识别生僻形近字、异体字及新型输入错误。针对大批量文档处理,系统支持10万字仅需3分钟的批量风险扫描,对法律条文中的"定金/订金"、医学术语中的"黄疸/黄旦"等高危险形近字错误自动标红锁定,并提供一键替换与人工复核双模式,在保障处理效率的同时实现高危错误的强制复核。
该流程还具备强大的跨领域适配能力,通过整合医学、法律、金融等20+行业专业术语库与形近字规范,可区分不同领域的同形字用法。针对OCR扫描件识别偏差导致的形近字替换问题,系统提供OCR后文档形近字校正能力;同时支持用户自定义专属形近字词库,添加行业特殊混淆对。部署方面,普通电脑即可运行,保密内网环境可采用软授权或加密锁替代,流程中断后系统可自动保存校对节点,支持从中断处恢复进度,确保古籍整理、法律审校等长周期项目的连续性。
针对医学、法律、金融等20余个专业领域,系统在通用字形比对基础上激活行业深度核查模式。医学场景下,除识别"苷/甙""疸/旦"等药品与病症形近字外,更通过解剖学术语库辨析"瘀/淤"等易混用字;法律出版中依据条文规范审查"刺/剌"等影响效力的字形差异,严格区分"账/帐"在财务与文书中的不同用法;财经领域则对"弌/壹""貮/贰"等异体大写金额字执行逻辑校验,结合数值上下文防范"干/千"量级混淆。
流程核心在于"AI初筛+专家复核"的协同机制:系统自动标红高危形近字错误(如古籍"己/已/巳"、政治用语"平/苹"),在侧边栏展示基于笔画相似度与语境匹配度的候选字列表,支持编辑人员逐条确认或批量替换。针对OCR扫描件与人工录入的特定错误,允许用户将"人/入/八"等专属混淆对添加至自定义词库,实现纠错规则的行业化定制。
质控层面,系统通过敏感形近字风险防控模块对接政治用语标准,对领导人姓名、机构名称的形近误用实施强制拦截;同时建立误报率与漏报率双指标评估体系,在10万字级文档批量处理中保持3分钟极速扫描与95%以上识别精度的平衡,确保从古籍数字化到金融财报编纂的全场景文字安全。
为确保形近字识别精度持续达标,系统建立了基于测试集与用户反馈的双循环评估体系,定期统计误报率与漏报率等核心指标。通过内置的8000余组形近字特征库基准测试,结合古籍出版、法律审校等真实场景的持续反馈,算法模型得以迭代优化,对"赢/羸/嬴"等生僻形近字及新型输入错误的识别率提升至95%以上。用户还可通过自定义词库功能添加"人/入/八"等专属混淆对,形成个性化纠错规则,系统同步采集这些自定义数据以扩充行业特征库,实现纠错能力的自我进化。
针对古籍数字化与繁简转换的特殊需求,流程支持Unicode全字符集结构分析,可精准处理简繁混合文本中的形近混淆,如"壹/弌""贰/貮"等异体字对应关系。对于OCR扫描件识别偏差导致的字形替换,系统通过笔画结构拓扑分析修复"己/已/巳"等错误,较传统词典匹配方式显著降低生僻字与异体字的漏报风险。这一能力特别适用于文史典籍整理,能有效解决版本比对中因字形极度相似导致的校勘难题,保障《地方志集成》等大部头典籍的出版质量。
在企业级部署层面,系统无缝集成WPS办公环境,无需专用硬件即可在普通电脑运行,满足出版社与政务机关的即时使用需求。针对保密内网环境,提供软授权或加密锁替代方案,确保党政机关公文处理的安全性。流程支持自动保存校对节点,当中断发生后可从中断处恢复进度,避免重复扫描。通过"一键替换与人工复核"双模式,高危形近字错误自动标红并强制复核,既保障了10万字级文档3分钟极速处理的效率,又满足了金融财报、医学教材等场景对零差错的严苛要求。
在《地方志集成》数字化中,OCR与人工录入导致大量“人入八”“未末”等形近字错误,传统逐字核对耗时费力。采用形近字智能辨析引擎,结合古籍专用字库与上下文语义分析,对扫描件进行批量后纠错,实现自动标红与一键修正。
《民法典释义》编审中,“定金/订金”“刺/剌”等形近字易引发法律歧义,人工审核难以全面覆盖,修订版次多易遗漏。系统通过法律形近字风险库与语义歧义检测,对多版本进行比对,高亮预警并强制复核高危混淆字。
《中华某草某》修订版涉及大量“戌戍戊”“苷甙”等药品与病症形近字,人工审校压力大且存在用药安全风险。系统激活医学深度核查模式,结合解剖学术语库与毒麻药品名称审查,对形近字进行安全拦截与智能修正。
形近字纠错完整流程始于文档扫描与OCR文字提取,系统基于8000余组形近字特征库进行笔画结构向量比对与相似度计算,快速定位疑似错误;继而通过NLP语义分析引擎结合上下文语境双重校验,判断用字合理性。流程支持20+行业术语库深度核查与自定义词库,可处理简繁混合及古籍异体字,最终高亮标注可疑字词并提供候选替换方案。采用“AI初筛+专家复核”双模式,支持断点续传与批量处理,10万字仅需3分钟,确保古籍、法律、医学等专业场景用字精准性。

好业财是专为小微企业打造的云端业务管理软件,覆盖进销存、资金、财务等环节,支持多端协同,帮助企业高效管生意、控成本。




好会计是智能财务软件,支持自动记账、报表生成与税务管理,适合代账公司与中小企业,提升做账效率,轻松应对财税合规。

好生意是进销存管理工具,实现采购、销售、库存一体化,支持移动开单与数据分析,帮助商贸企业精准掌握货流,减少库存积压。
好业财是专为小微企业打造的云端业务管理软件,覆盖进销存、资金、财务等环节,支持多端协同,帮助企业高效管生意、控成本。
好会计是智能财务软件,支持自动记账、报表生成与税务管理,适合代账公司与中小企业,提升做账效率,轻松应对财税合规。
好生意是进销存管理工具,实现采购、销售、库存一体化,支持移动开单与数据分析,帮助商贸企业精准掌握货流,减少库存积压。

WPS合同管理提供合同起草、审批、归档全流程线上化,结合智能条款比对与风险预警,让企业合同管理更规范、更安全。




WPS进销存是轻量级库存管理工具,支持出入库、盘点、库存预警,与WPS表格无缝集成,适合小微商户快速上手,降低库存差错。

WPS项目管理帮助团队规划任务、追踪进度,甘特图与看板视图清晰呈现项目状态,提升协作效率,确保项目按时交付。
自动识别“己已巳”等8000+组形近字混淆,结合语义分析,提供精准纠错建议。
修复扫描件导致的形近字偏差,如“人入八”,提升数字化文档的准确率。
识别政治敏感形近字伪装,如“平苹”,实时分级预警,保障内容安全。
支持医学、法律等20+行业术语库,严格区分“定金/订金”等专业用字。
添加行业专属混淆对,如“拨/拔”,实现个性化纠错,适配专业场景。
10万字3分钟完成扫描,中断自动保存进度,高危错误强制复核,确保零差错。
基于深度学习形近字特征库与NLP语义分析,精准识别8000余组形近混淆,覆盖医学、法律等20+行业,支持自定义词库,实现高效校对与风险防控。
