

WPS 多维表格
灵活配置档案字段,支持多级类目关联与结构化数据导出,轻松实现目录智能管理。
灵活配置档案字段,支持多级类目关联与结构化数据导出,轻松实现目录智能管理。

集成档案目录智能抽取AI能力,API/SDK灵活接入,满足私有化部署合规需求。

多人协同编目审核,实时同步档案目录数据,提升跨部门档案协作效率。

AI穿透印章手写遮挡,精准识别档号文号,自动纠错还原历史档案关键信息。

智能生成档案抽取代码与结构化脚本,加速档案系统对接与数据治理开发。
档案目录智能抽取解决历史扫描件OCR识别后字段错位、手写档号与印章覆盖难还原、多级类目重复难去重等常见问题。支持档号、责任者、文号、题名等字段自动抽取,适配跨页表格、表格线缺失、单元格合并等复杂版式,输出DA/T 18标准格式,直接对接档案管理系统,覆盖档案馆、工程档案、病案、信贷档案等场景。
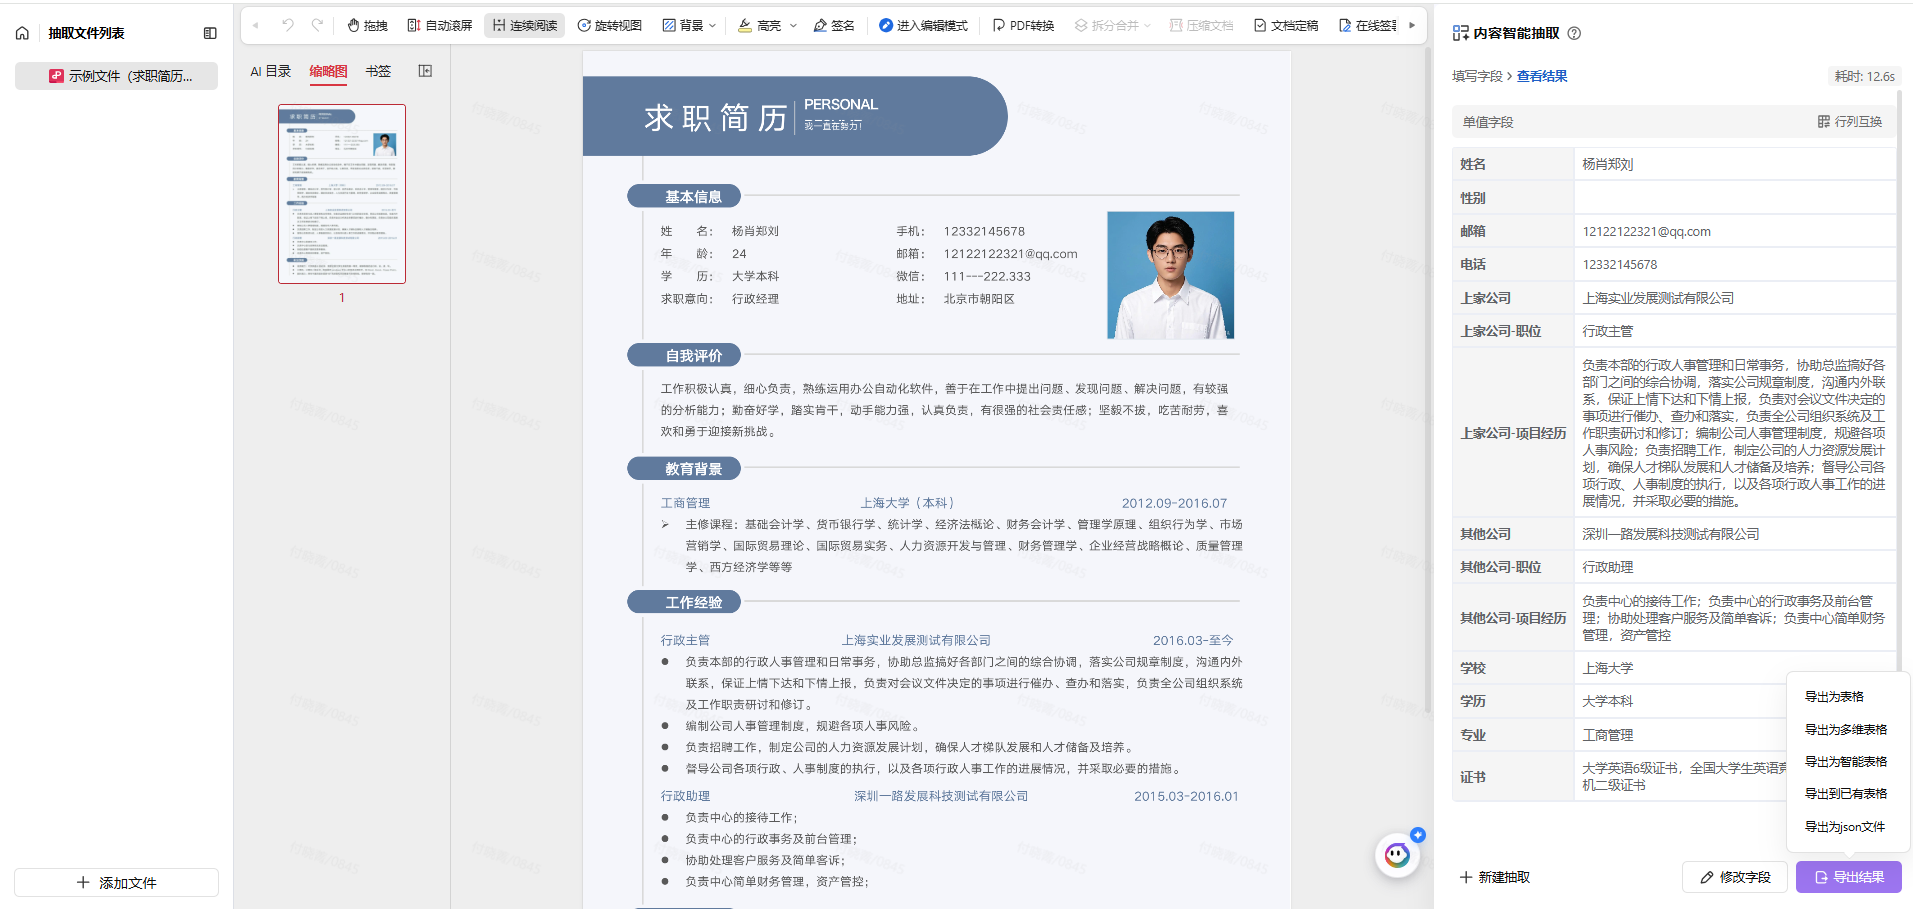
档案目录抽取是数字化转型的关键环节,但在实际工作中面临多重挑战。常见问题包括:历史档案目录多为扫描件或老旧电子表格,OCR识别后字段错位、粘连严重;手写档号、印章覆盖区域的关键信息难以准确还原;案卷目录、卷内目录等多级类目下,相同题名档案重复出现,导致人工编目口径难以统一。此外,不同档案馆、不同全宗的目录格式差异大,档号、责任者、文号、题名、日期等字段散落在各类版式中,跨页表格、表格线缺失、单元格合并等复杂情况进一步加剧了结构化难度。
针对上述痛点,档案目录智能抽取方案提供了系统化解法。该方案支持灵活配置档案目录字段,既涵盖档号、全宗号、年度、保管期限等标准字段,也允许自定义扩展,适配不同档案馆的格式差异。针对复杂版式,基于文档结构解析实现精准定位,避免通用OCR的行列错乱;组字段配置功能可将同一案卷下的多份卷内文件按件拆分为多行记录,保持案卷级与文件级目录的层级关联。抽取结果支持键值对JSON、Excel表格及DA/T 18标准XML等多种格式导出,可直接回流档案管理系统。
对于关注部署方式与接入门槛的用户,该服务提供标准API接口与SDK工具包,支持异步任务提交与结果回调;单次任务建议不超过50个文件,结果以结构化JSON数据返回,包含字段名称、置信度及坐标位置。同时支持私有化部署方案,满足数据不出域的合规要求。需要注意的是,此项功能属于WPS 365商业旗舰版(599元/人/年)中的AI能力范畴,其他版本用户如需使用需联系销售开通或评估升级路径。
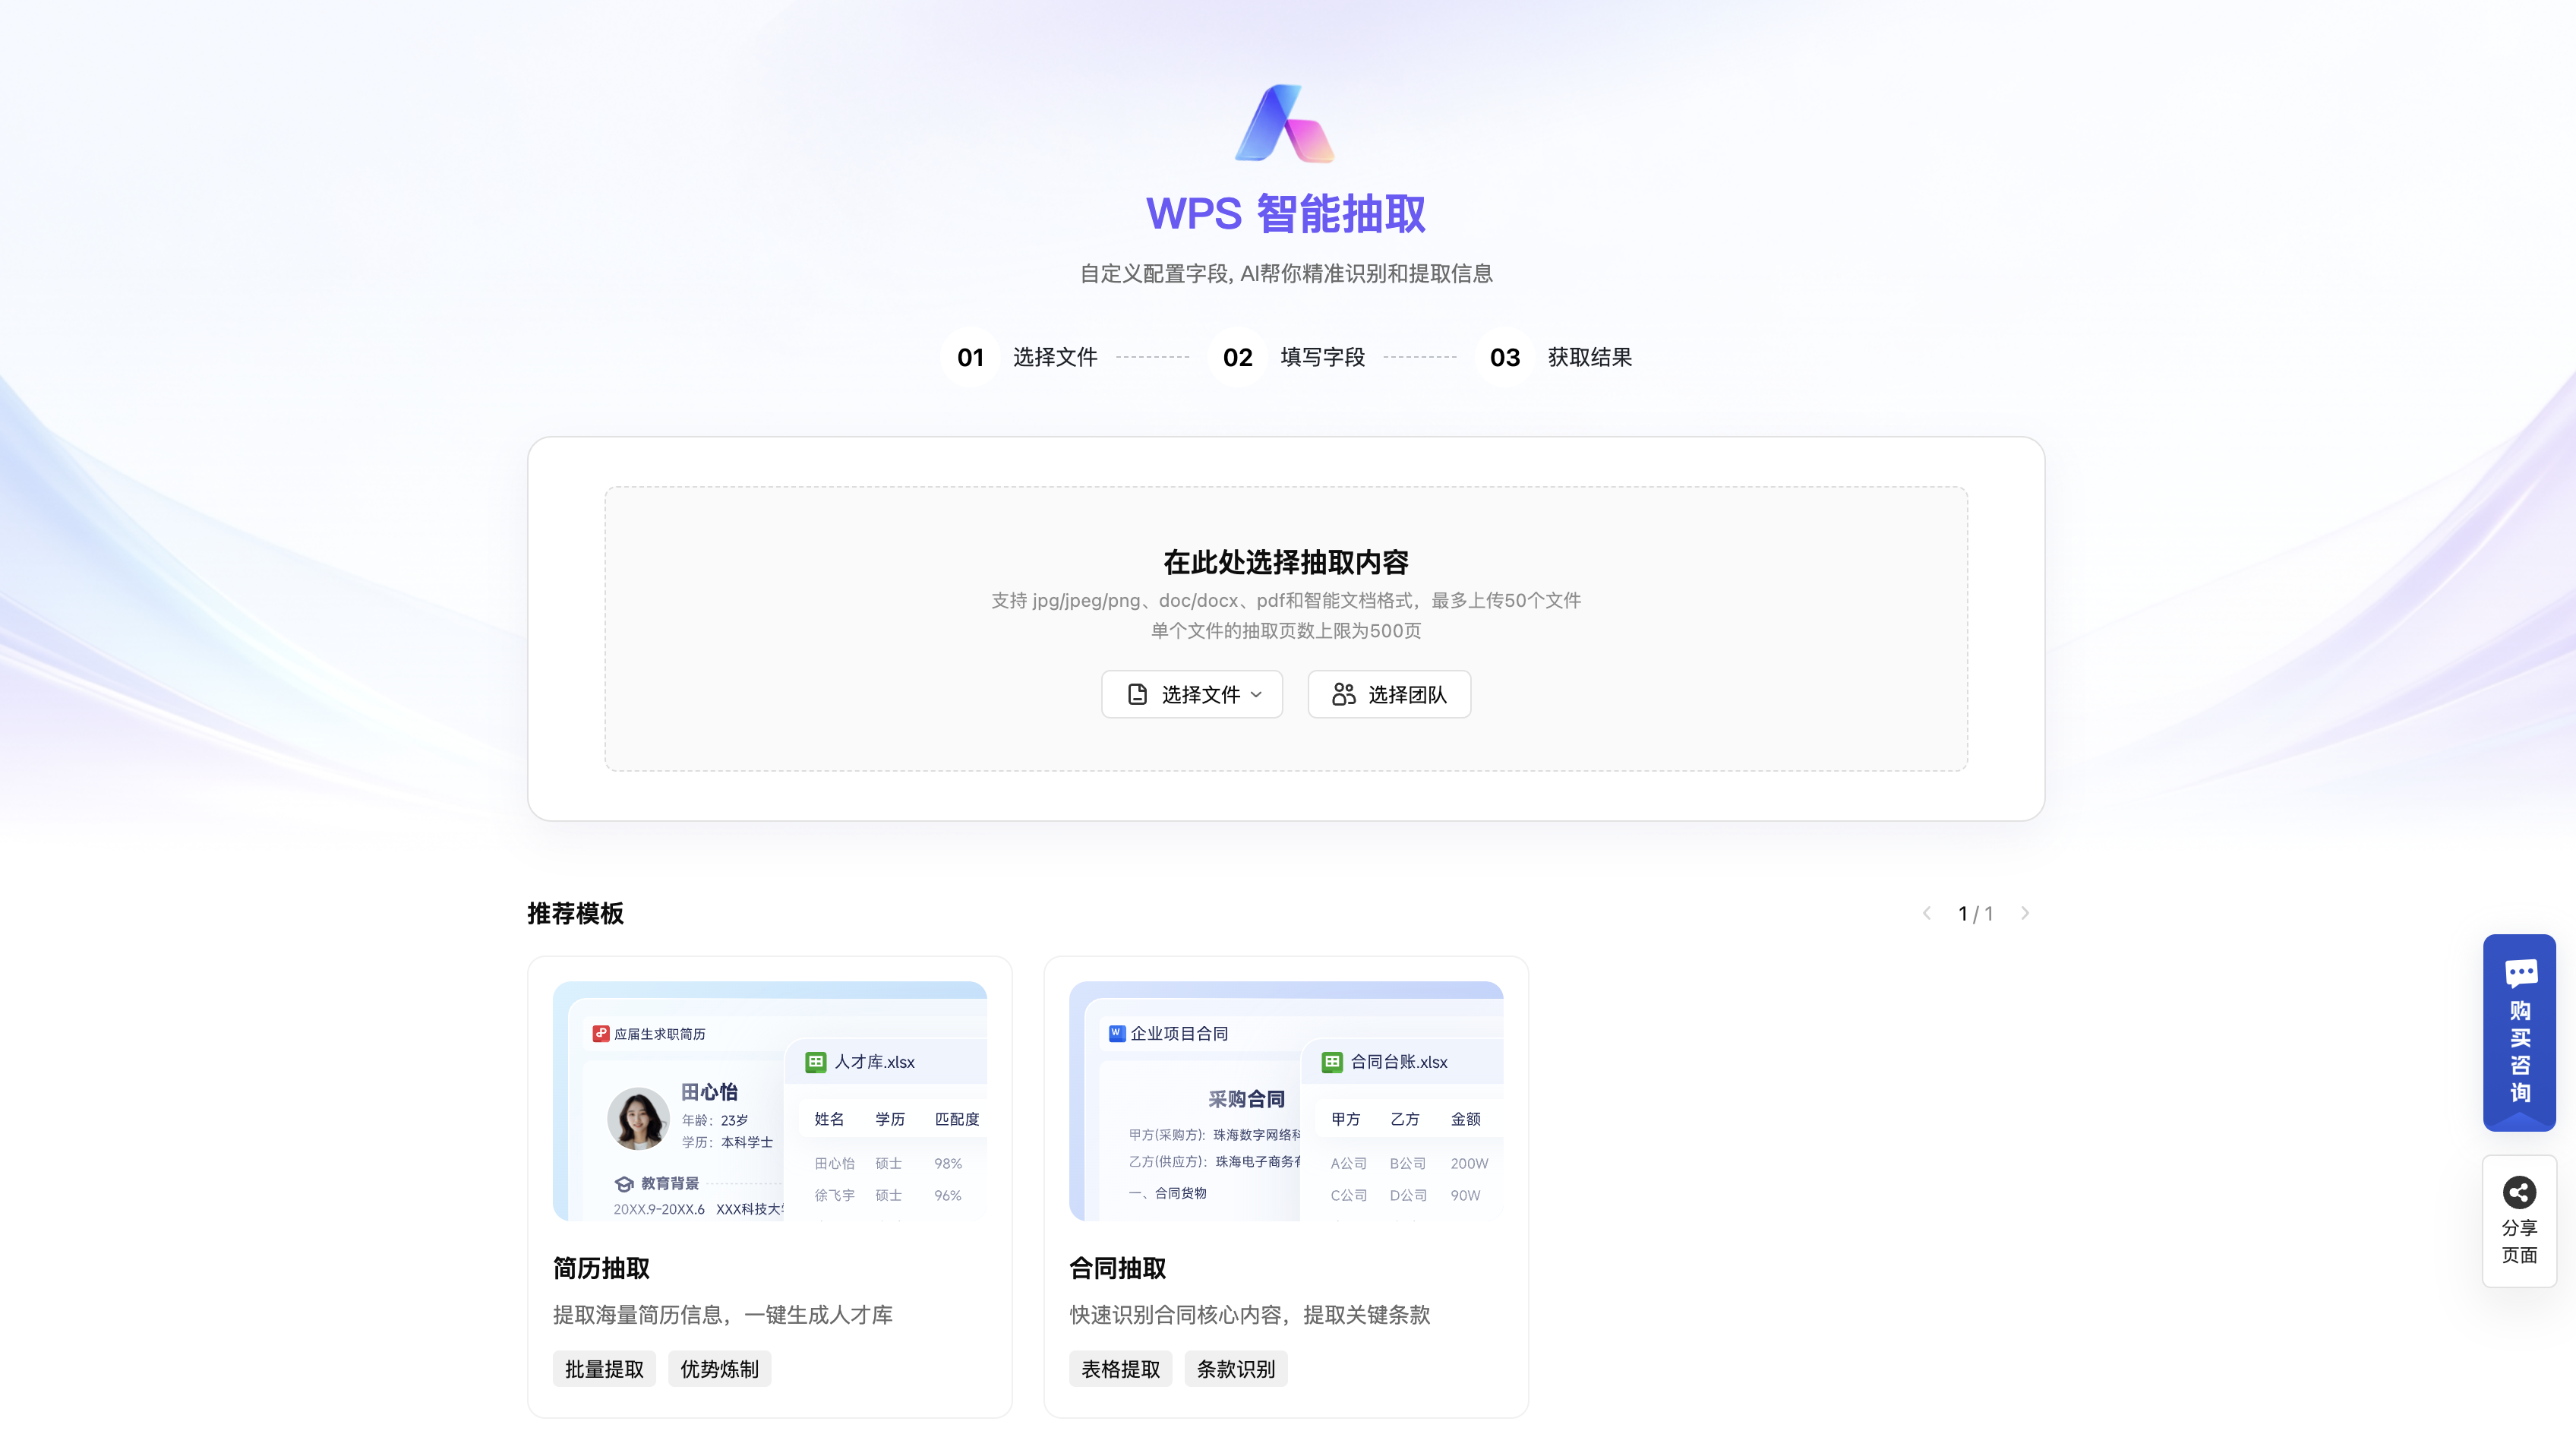
在档案馆场景中,档案数字化中心常面临扫描图像与目录条目分离、手写档号及印章覆盖区域难以识别的困境。以某市档案馆为例,其民国至建国初期档案扫描件中,档号与责任者信息多被手写涂改或印章遮挡,传统OCR抽取后字段错位率超过三成。通过启用档案目录智能抽取的文档结构解析与预置标准模板,系统穿透模糊区域完成关键要素定位,结合档号与责任者组合去重,最终批量写入档案管理系统目录库,支撑开放鉴定与民生档案跨全宗利用。
建筑工程领域同样面临图纸编号、单体栋号等信息嵌套于图签栏与复杂表格的挑战。某商业综合体项目在竣工图归档阶段,各参建单位提交的变更单与验收记录版本混杂,人工逐页核对耗时费力。借助智能抽取的组字段配置,系统按项目号、单项工程、卷册号等层级自动拆分卷内文件,形成统一项目级目录树,实现去重合并后直接对接城建档案馆进馆数据格式,一次性通过验收。
医疗机构病案管理科则对手写病历与打印件混排场景尤为敏感。某三甲医院近三年病历中,病案号与手术名称的书写不规范导致首页数据匹配困难。智能抽取通过模糊匹配与纠错机制,将临床诊断自动映射至ICD编码口径,抽取结果补充DRG分组号后直写病案首页库,使医保结算数据准备周期由两周压缩至三天,显著缓解编码员人工翻译压力。
金融机构信贷档案中心长期受困于抵质押合同、授信审批书等扫描件的关键信息识别难题。骑缝章横跨合同编号、授信金额等核心字段,手写批注层层叠加,传统OCR工具难以穿透遮挡区域,导致档案目录与业务系统台账频繁对账不平。更棘手的是,不良处置阶段需跨年度调阅大量合同,纸质目录检索效率低下,诉讼材料准备动辄超期,直接影响清收时效与资产回收率。
档案目录智能抽取方案针对金融场景进行了专项优化。文档智能解析模块通过多模态识别技术,对骑缝章、手写批注等遮挡区域进行穿透提取,合同编号、客户名称、授信金额、期限、担保方式等要素的识别准确率大幅提升。预置的银行业信贷档案管理模板严格遵循行业规范,输出字段口径与核心系统无缝对接。自定义字段功能支持补充风险分类、诉讼案号等扩展信息,按客户维度聚合形成结构化档案目录。
某股份制银行地方分行的实践验证了该方案的实效性。其对历史抵质押合同与授信审批书进行批量抽取时,系统成功穿透骑缝章遮挡区域,自动校验合同编号与金额的逻辑一致性,去重合并后写入信贷档案目录库。原本需要三个工作日的诉讼调阅响应,压缩至当日内完成。档案目录与风险分类台账的实时同步,使法务人员能够精准掌握每笔不良资产的档案完备情况,为清收决策提供及时的数据支撑。
高校与科研院所积累了大量学籍档案、科研档案及文献资料,其目录结构呈现出高度的专业性与复杂性。以科研档案为例,同一课题往往跨越多个自然年度,涉及项目编号、课题负责人、参与单位、经费科目、结题报告等多维度信息,且这些信息分散在立项书、任务合同书、年度进展报告、验收证书等不同类型文档中。传统数字化方式难以建立课题全生命周期的关联索引,导致科研成果追溯困难、知识产权管理松散,更无法支撑学科知识图谱的构建。此外,古籍特藏与历史文献的目录多为繁体竖排、朱丝栏格式,通用OCR在断句、断行及人名地名识别上错误率极高。
档案目录智能抽取方案针对学术机构的特殊需求,提供了可配置的多层级组字段能力与文献专用解析模型。系统支持以课题编号或学籍号为主键,将分散在不同文档中的项目信息、人员信息、经费信息自动聚合为完整的结构化记录,保持时间轴与逻辑层的双重关联。对于古籍特藏,通过训练竖排文本与篆刻印章的专项识别模型,结合行款版式的智能还原,实现卷次、函册、藏家印记等要素的精准抽取。自定义字段可扩展至学科分类、基金来源、知识产权状态等维度,抽取结果直接写入机构知识库与数字人文研究平台。
某高校档案馆对二十世纪以来的学籍卡片与科研合同进行数字化时,利用组字段配置将同一学者的学籍信息、导师关系、后续科研成果进行跨全宗关联,形成学者学术谱系数据库。同时,馆藏善本目录经智能抽取后,与四库全书总目、中国古籍善本书目等权威数据进行标引对接,支持版本学特征的自动化比对与专题研究,为数字人文领域的知识挖掘与可视化分析奠定了数据基础。
扫描件档号及印章覆盖信息难识别,多级类目重复题名口径不一。通过智能解析穿透模糊区域定位要素,按档号与责任者去重后批量写入目录库。
竣工图与变更单分散于各参建单位,图签栏信息嵌套难汇总。利用组字段配置自动拆分卷内文件,形成统一项目级目录树并去重导出。
手写病历与打印件混排,诊断表述与ICD编码口径不一致,结算数据滞后。通过模糊匹配与自动映射,抽取关键信息写入病案首页库。
档案目录抽取面临OCR识别错位、手写及印章遮挡、多级类目重复、版式差异大等核心难题。传统方式难以应对跨页表格、单元格合并等复杂版式,且人工编目口径难以统一。智能化方案通过文档结构解析精准定位,支持灵活字段配置与组字段拆分,实现档号、责任者等关键要素穿透提取与自动去重。建议优先采用预置模板提升效率,结合私有化部署满足数据安全合规要求,同时利用异步API与回调机制保障大规模批处理稳定性。

智能业财一体化工具,结合AI抽取能力,自动识别发票、合同等单据的关键字段,生成凭证与报表,助力财务高效处理。




智能财税软件,支持扫描件自动识别与抽取,一键生成记账凭证,精准匹配会计科目,大幅提升记账效率。

集成AI智能抽取的项目管理平台,自动提取合同与变更单中的项目编号、金额等要素,构建结构化文档目录,便于进度跟踪。
智能业财一体化工具,结合AI抽取能力,自动识别发票、合同等单据的关键字段,生成凭证与报表,助力财务高效处理。

智能进销存管理应用,通过AI抽取快速识别采购单、销售单,自动录入商品与金额,实现库存与财务数据无缝同步。
智能财税软件,支持扫描件自动识别与抽取,一键生成记账凭证,精准匹配会计科目,大幅提升记账效率。

WPS合同管理内嵌AI智能抽取,自动提取合同编号、金额、期限等核心字段,实现合同归档与全文检索,降低法律风险。



集成AI智能抽取的项目管理平台,自动提取合同与变更单中的项目编号、金额等要素,构建结构化文档目录,便于进度跟踪。

WPS进销存结合AI抽取技术,智能识别出入库单据,自动生成库存台账与报表,实现销售、采购、仓管一体化高效运营。
穿透手写档号与印章遮挡,案卷/卷内层级联动抽取,直接输出DA/T 18标准XML入库。
自动拆分项目号、卷册号等层级,图签栏与表格精准定位,一次通过城建档案馆验收。
手写病历与打印件混排下,病案号、手术名称自动匹配ICD编码,压缩医保结算准备周期。
骑缝章、手写批注穿透识别,合同编号与金额自动校验,诉讼调阅当日完成。
以课题编号为主键跨文档聚合,形成项目全周期索引与学者学术谱系,支撑知识图谱。
繁体竖排与朱丝栏格式智能还原,卷次、藏家印记精准抽取,对接数字人文研究平台。
支持灵活配置字段,穿透骑缝章与手写遮挡,精准抽取档号、责任者、题名等,自动拆分案卷组件内文件,输出标准XML/JSON/Excel,直连档案系统。
