
证书奖状文字核对怎么上手:WPS黑马校对证书批量审校操作指南与功能详解,支持PDF/图片/生僻字识别及编号查重
WPS黑马校对提供证书奖状文字核对完整解决方案,针对高校毕业证书、企业评优奖状、党政机关表彰文件等场景,支持PDF/图片/WPS格式批量导入,自动识别姓名、奖项、编号等关键字段,精准核对人名错别字、生僻字、编号重复及日期逻辑错误,对接学籍库与HR系统实现数据交叉验证,0.1mm级版式审查确保符合GB/T标准,10分钟即可上手,overnight完成万级证书审校,导出勘误报告实现全流程质量把控。
核心看点 Key Takeaways
- ✓毫秒级智能提取关键字段,自动标记错字、漏字及人名混淆,支持多场景专项审校
- ✓0.1mm级版式防伪审查,比对国标模板,精准校验印章、国徽与防伪底纹
- ✓沉淀机构专属词库与错误模式,实现主动防错与全流程合规留痕报告
01证书奖状文字核对功能快速上手指南
准备证书电子文档与自定义词库是上手的第一步。将PDF、图片或WPS格式的证书文件导入系统,同时加载包含获奖人姓名、奖项名称、颁发机构的特定词库,即可启动智能识别。系统基于千万级证书语料库训练,毫秒级提取姓名、单位、奖项、编号、日期等关键字段,自动标记错别字、多字漏字及格式不一致问题,支持逐条修改与批量处理。
针对高校毕业、企业评优、党政机关表彰等不同场景,可启用专项审校规则。教育类证书建议对接学籍库API或HR系统,实现人名、专业名称、职务层级的精准匹配;高规格表彰文书需开启政治性合规审查,实时比对荣誉称号规范词库与国家荣誉库,校验领导人姓名职务排序及敏感表述。通过设置日期正则表达式与编号规则,可自动检测逻辑矛盾与重号错号。
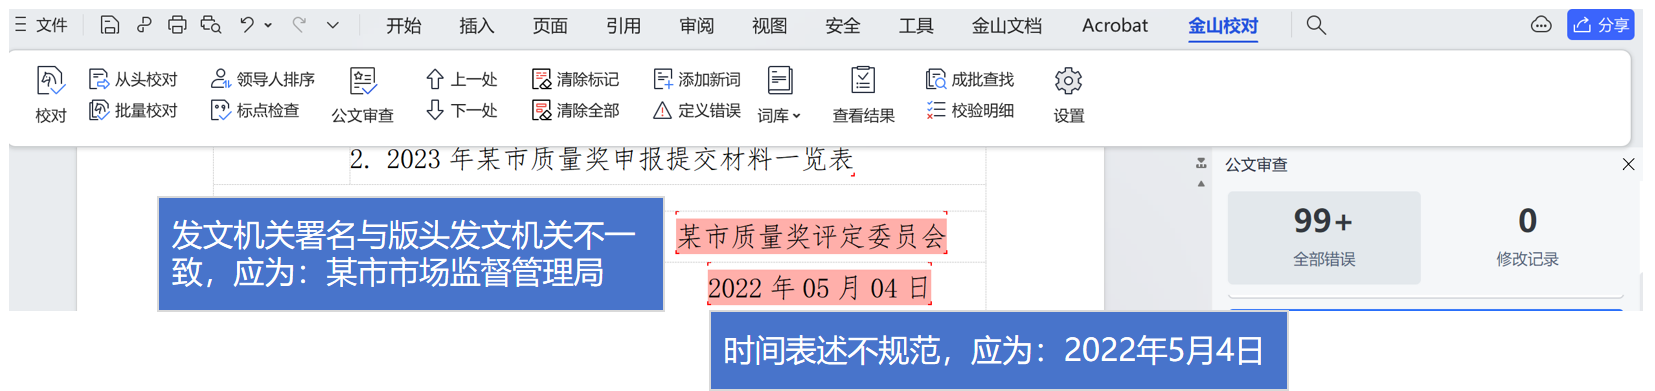
进阶操作涵盖版式与防伪审查。系统自动比对GB/T 32674-2016等国家标准模板,精准识别国徽、印章位置偏差及防伪底纹缺失,支持0.1mm级像素审查。对于国际赛事等多语言证书,启用中英文混合校对模式可确保术语一致性。完成校对后,可一键导出带批注的勘误报告或修订文档,实现从内容纠错到格式规范的全流程质量把控。
02三步上手实现批量证书智能审校
初次使用可遵循"导入-配置-审校"标准化流程快速启动。首先通过批量导入功能一次性上传PDF、图片或某办公软件格式的证书文件夹,系统自动完成OCR文字提取与版面分析;随后在审校规则库中选择对应行业模板——高等院校启用学籍库API实时比对模式,党政机关开启政治性合规审查与敏感信息脱敏,企业用户对接HR花名册,赛事组织方加载多语言平行文本库——系统将自动匹配千万级证书语料库与官方数据源进行交叉核验。
针对毕业季、表彰大会等高峰期场景,启用 overnight 批量处理模式可完成万级证书审校。系统特别强化生僻字与多音字识别能力,自动高亮提示"谌""郜"等易错姓氏,并通过编号正则表达式自动查重,确保年份+地区+类别+序号规则无冲突。对于国际赛事或涉外荣誉,开启中英混合校对可精准拦截"Chinglish"翻译偏差,同时自动校验奖项等级表述规范性,避免金奖/特等奖/一等奖混用导致的领奖纠纷。
完成审校后,除导出带批注的勘误表外,系统支持生成符合档案管理要求的合规性评估报告,记录领导人姓名排序、国徽位置偏差等政治性格式问题的修改痕迹,满足政府机关"凡提四必"的留痕要求,实现从内容纠错到归档管理的全流程闭环。
03智能审校机制与人工复核的差异价值
核心在于从"事后纠错"转向"事前拦截"。传统人工校对依赖逐字通读,面对毕业季万级证书或表彰大会批量文件时,易受疲劳、经验差异影响,难以持续保持高精度。系统基于千万级证书语料库训练的行业专用语义理解模型,毫秒级完成关键字段提取,对"张冠李戴"式人名错误、同音不同字(如"谌"误为"湛")、奖项等级表述混淆(金奖/特等奖混用)等人工易漏风险实现100%自动标记。针对党政机关表彰文书,系统实时对接国家荣誉库与社会组织信用平台,自动校验颁奖主体资质与荣誉称号规范性,拦截"山寨奖项"与超范围颁奖,将政治性差错风险降至零容忍。
在防伪与合规层面,系统突破人工肉眼局限,可识别0.1mm级版式偏差,自动比对GB/T 32674-2016等国标模板,精准检测国徽偏移、印章缺失、防伪底纹完整性。相比通用OCR工具,其深度理解证书场景语义,能有效区分字段逻辑关系,自动审查日期时序矛盾与编号唯一性。通过对接学籍库、HR系统、社会组织监督平台等多源权威数据,实现从内容准确性到颁发主体合规性的全链路质量把控,确保每份证书在文字、格式、资质三重维度上的法律效力与权威性。
04证书全生命周期质量闭环与知识沉淀机制
建立机构专属证书审校知识库是实现零差错目标的长效机制。系统支持将历年校对中标记的生僻字易错模式(如"郜""谌"等姓氏)、部门历史变更名称、特定奖项表述习惯自动沉淀为自定义词库,形成可复用的质量资产。通过分析往届毕业季、表彰大会的错误分布规律,智能预判高风险字段并前置预警,实现从"被动纠错"向"主动防错"的范式转变,使系统越用越精准。
在档案管理合规维度,平台完整记录每份证书的审校轨迹、修改痕迹与版本变更,生成符合《电子文件归档与管理规范》的全流程留痕报告,支持按年度、批次、颁发机构进行质量追溯。当面临证书补发或历史版本比对需求时,可秒级调取原始底稿与防伪要素记录,确保新旧证书信息一致且符合GB/T标准格式要求。
针对突发制证场景,系统启用应急审校绿色通道,在保持精准度的前提下压缩处理时效,同时自动触发高风险二次复核机制。通过持续积累的违规案例库与政策更新同步(如实时对接社会组织监督平台黑名单、最新荣誉称号规范),系统可主动推送合规性预警,帮助颁奖单位建立动态化的证书质量风控体系,彻底杜绝同类差错重复发生。
05多行业证书审校实践案例
某985高校研究生院
毕业季集中印制8000份硕博证书,人工核对人名、专业英文译某易某出错,编号唯一性难保证。系统对接学籍库API,实时比对姓名、专业与学位字段,开启生僻字识别与中英文混排审查,批量校验模板与防伪二维码。
某省公务员局表彰办
印制500份“人民满意的公务员”表彰证书,要求政治性零差错,但人名档案匹配、荣誉称号表述规范校验难度大。系统启用政治性合规审查,实时比对国家荣誉库,自动校验领导人姓名职务排序,并进行敏感信息脱敏。
某世界500强集团行政部
年度表彰涉及12000名员工,人工核对生僻字、历史部门名称错误率高,品牌VI标准易偏差。系统对接HR花名册,批量匹配员工信息,高亮提示生僻字、多音字,自动审查企业VI格式与英文职位术语一致性。
如何使用黑马校对核对证书上的文字内容?⌄
证书奖状文字校对需要提前准备哪些材料?⌄
黑马校对能否自动识别证书中的姓名和奖项?⌄
证书印章文字模糊不清时如何利用黑马校对?⌄
06证书奖状文字核对快速上手指南
上手证书奖状文字核对需遵循"导入-配置-审校"标准化流程。首先准备PDF/图片电子文档,加载含获奖人姓名、奖项名称的自定义词库;其次根据场景选择行业模板,对接学籍库、HR系统或国家荣誉库等权威数据源;最后启用批量处理与专项审校规则,利用千万级语料库自动标记错别字、生僻字及格式偏差,支持一键导出勘误报告。建议建立机构专属知识库沉淀易错模式,实现从被动纠错到主动防错的质量管控闭环。










