

WPS 365
集成词条编辑与校对能力,支持百万级词条批量质控与跨部门术语统一,实现知识管理全流程自动化,确保企业文档权威准确。
集成词条编辑与校对能力,支持百万级词条批量质控与跨部门术语统一,实现知识管理全流程自动化,确保企业文档权威准确。

深度融合AI技术,智能识别词条事实错误与术语冲突,支持学科公式解析与敏感信息检测,大幅提升百科、学术及商务内容审核效率。

专为海量商品参数与知识条目设计,自动校验数值逻辑与单位规范,支持千万级数据批量质控,确保技术文档与产品手册零差错。

内置政治术语与品牌口径词库,实时检测邮件内容敏感词与不规范表述,保障政府公文及商务沟通的专业性与合规性。

依托30年技术积累,支持百科、学术及企业知识库的事实性错误核查与术语标准化,日处理百万级词条,准确率高达99.9%。
针对百科平台、电商企业及知识库管理中海量词条内容人工审核成本高、术语不规范等痛点,WPS黑马校对提供词条内容事实校对、参数标准化及术语统一功能。依托8000万专业词库,自动识别事实错误、单位换算问题及术语混用,支持LaTeX公式与EPUB/PDF格式,日均处理百万级词条,校对效率较人工提升90%以上,API可嵌入CMS系统,适用于百科、电商、在线教育及企业知识管理场景。
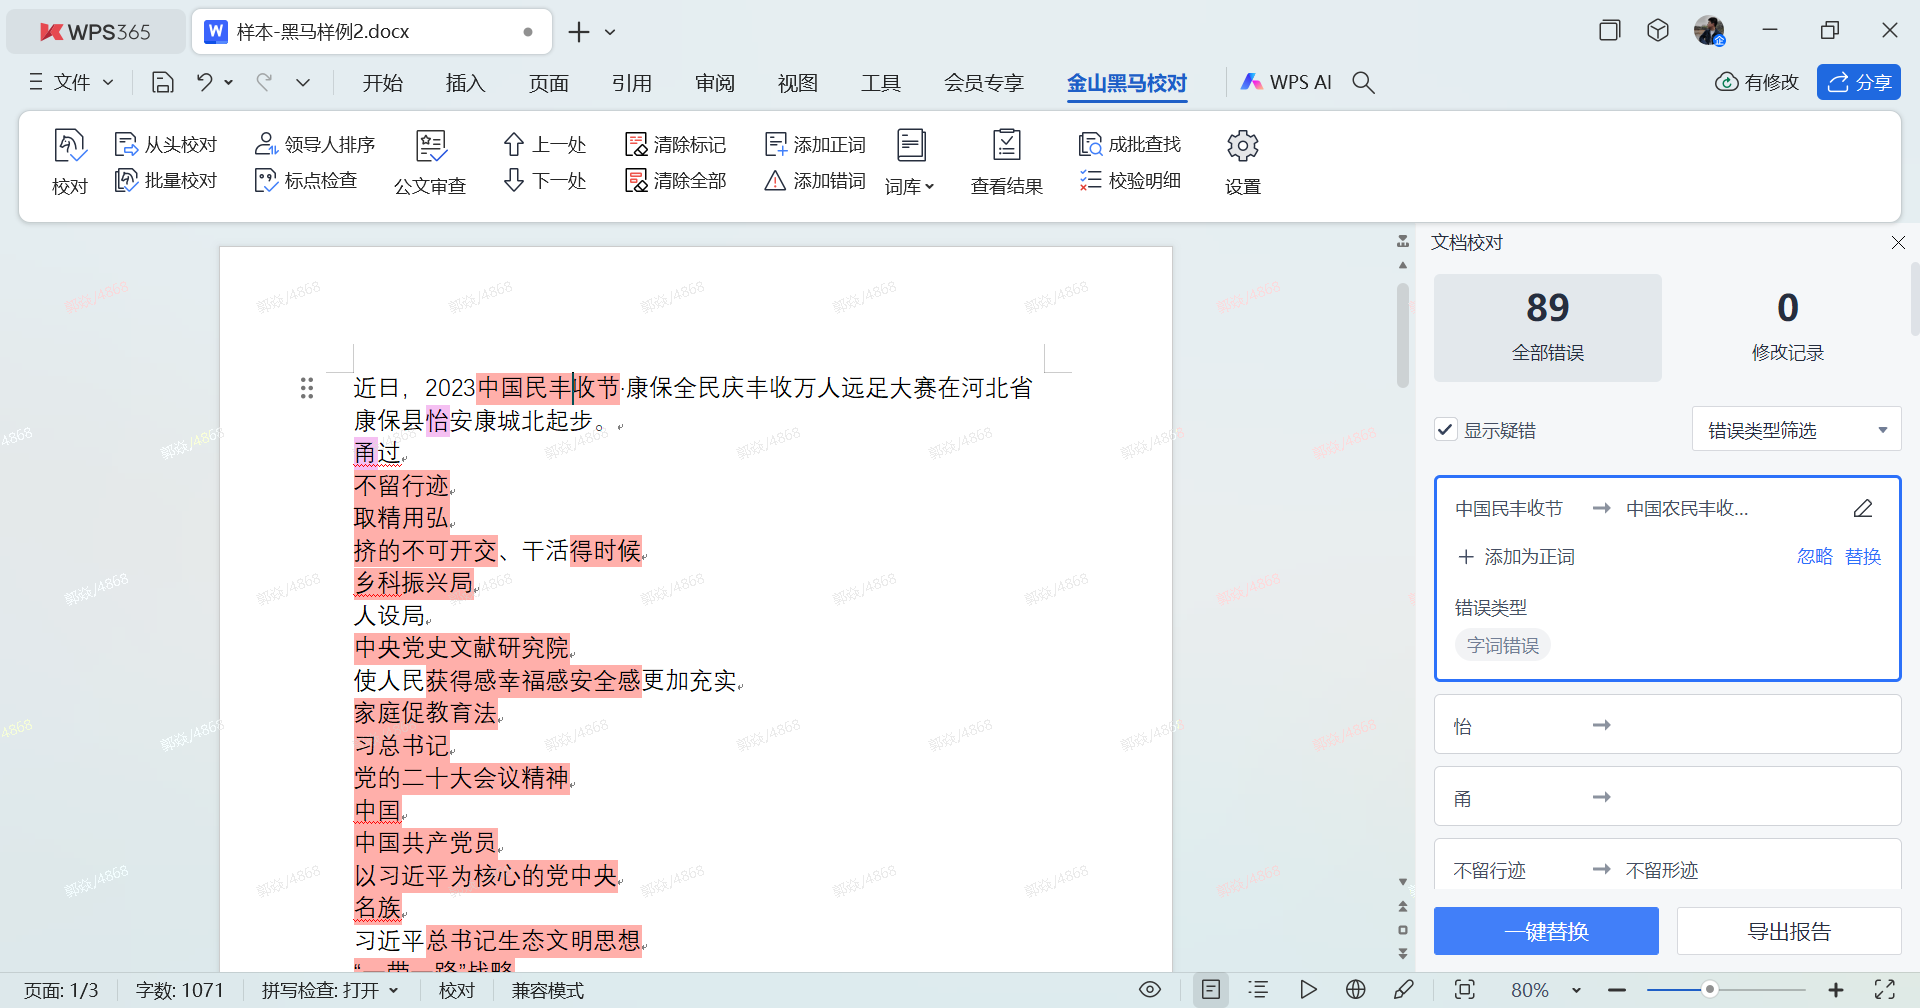
词条内容校对主要应用于百科平台、电商零售、企业知识管理及在线教育等多元场景,解决海量条目中的事实性错误、术语规范及参数标准化问题。在百科与知识图谱领域,系统依托30年技术积累的专业词库,自动核查事实表述、引用时效性及学术术语准确性,有效识别UGC内容中的知识谬误与逻辑矛盾,日均可处理百万级词条;在电商平台,则重点校验商品参数的单位换算错误、数值逻辑冲突及与国标/行标的符合性,避免因规格混乱导致的退货风险。
针对大型企业内部知识管理,该功能通过自定义术语库强制统一跨部门间的专有名词与品牌表述,消除"小程序"与"轻应用"等新旧词汇混用现象,确保技术文档与合规公告的语言规范。在线教育场景下,系统深度适配LaTeX数学公式混排与学科专用符号,支持千万级题库的批量质控,将校对周期从数月缩短至一周。通过RESTful API嵌入CMS或题库管理系统,可实现词条编辑流程的自动化,较人工审核效率提升90%以上。
需注意的是,企业专属词库深度定制、敏感信息检测及私有化部署等高级功能,通常需要联系销售开通或单独议价,而基础校对服务一般以公有云SaaS形式提供,支持按需弹性扩容。试用版虽支持自定义词库体验,但可能存在词条数量限制,完整功能需购买正式版本。
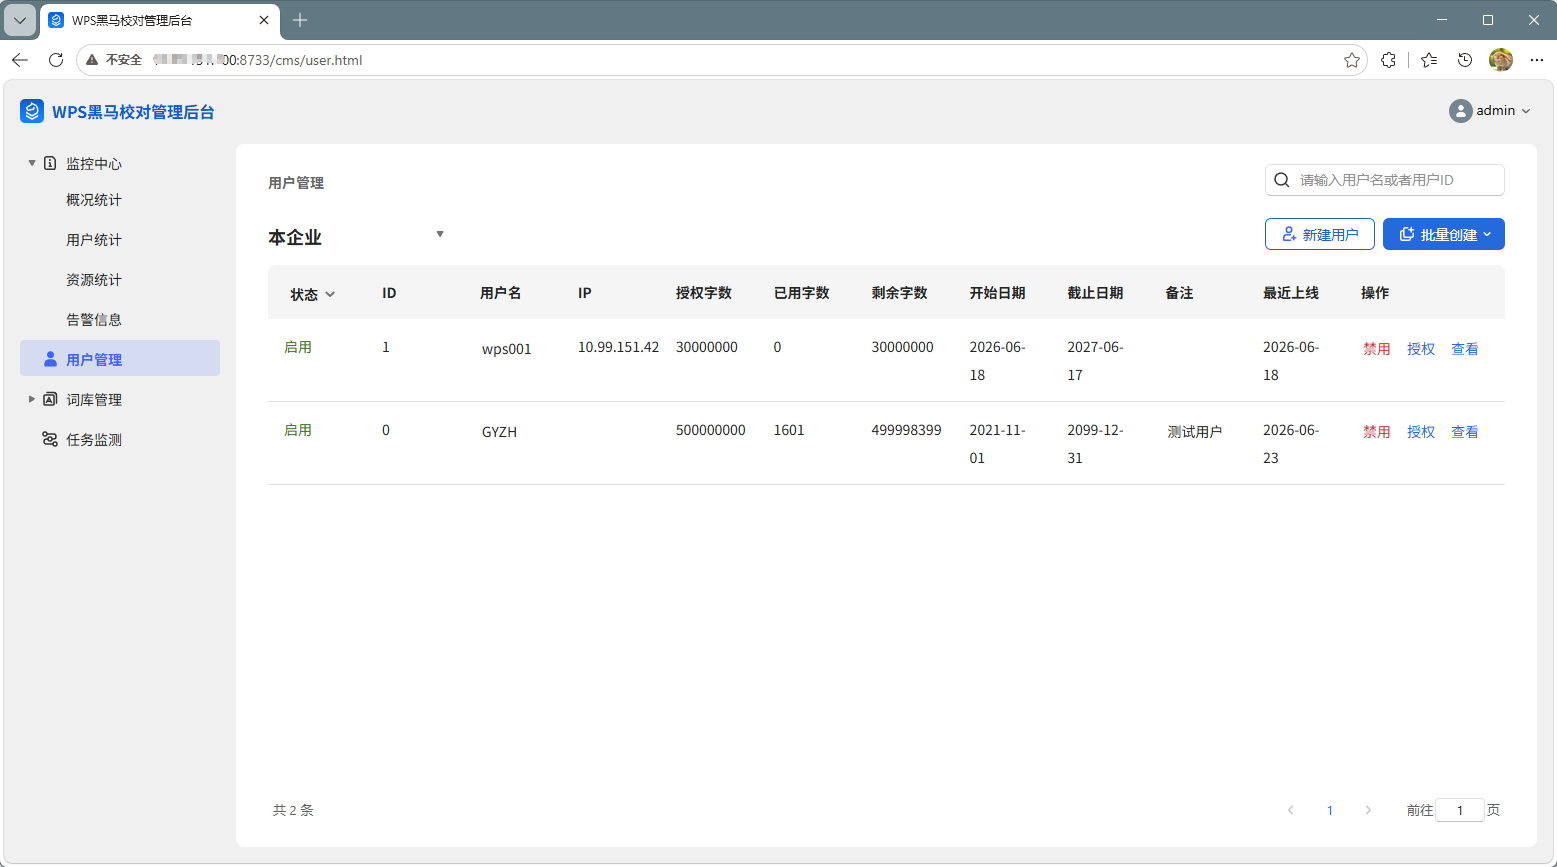
在政府机关公文写作与新闻传媒内容生产中,政治性差错、术语规范及品牌口径一致性是核心质控要点。黑马校对通过自定义词库功能,支持导入行业术语、规范用语及政治敏感词库,在公文场景中自动匹配并提示不规范表述,确保红头文件、政策公告的用词严谨性与政治正确性。针对新闻稿件,系统可定制包含常用人名、地名及政治术语的专用词库,实时核查并提示潜在差错,有效提升新闻发布的权威性与准确性。
对于金融、法律、医疗等高度专业化领域,系统支持深度定制行业专属词库,通过RESTful API接口嵌入OA、CMS等业务系统,实现合同法律用语合规性审查、专业术语精准校对及商业机密智能检测。私有化部署方案确保敏感公文与核心技术资料的数据隔离,满足等保三级要求。通过热加载技术与云端同步,企业可实时更新术语标准,强制统一跨部门表述规范,消除"小程序"与"轻应用"等品牌术语混用现象,维护对外专业形象,规避法律风险与品牌危机。
在数字出版与纸质书数字化加工场景中,针对OCR识别过程中产生的高错误率、标点符号半角全角混乱及元数据与正文不一致等问题,黑马校对提供某格某式兼容引擎,支持对EPUB/PDF等流式文档进行直接校对,无需格式转换即可智能纠正OCR识别偏差,自动规范标点符号统一性。系统可校验ISBN与CIP数据格式,检查繁简转换准确性,并实时过滤网络敏感词与违禁内容,确保网络文学合规出海。凭借万册级电子书批量预处理能力,日处理量可达2000册以上,将OCR图书校对效率较人工提升20倍,识别错误率从5%降至0.2%,助力出版机构在3年内完成馆藏资源数字化转型。
针对制造业与B2B采购平台的产品参数管理痛点,系统内置工业标准参数库与计量规范,智能识别技术参数单位混用(如cm与mm混用)、数值逻辑错误(重量与体积矛盾)及与国标/行标不符等风险,自动统一多SKU参数表述规范。通过全量自动化核验能力,实现千万级商品词条的批量质控,精准识别属性缺失与重复,有效规避因参数错误引发的售后风险与客诉纠纷,保障技术文档与产品手册的工业级准确性,服务制造业巨头构建标准化商品中台。
针对科研院所、高校及专业学术平台在构建知识图谱与学术数据库过程中面临的挑战,词条内容事实校对功能依托8000万专业词库与30年技术积累,提供深度适配学术场景的智能质控方案。系统不仅自动核查跨学科词条中的事实性表述错误、过时理论引用及数据时效性,更能精准识别专业术语的规范性使用,确保数学公式、化学式及学科符号的严谨性,避免知识误导。通过支持LaTeX混排解析与多来源内容交叉校验,有效发现不同文献整合时的逻辑矛盾,满足学术论文与百科条目的高权威标准。
考虑到科研机构对数据安全与术语自主性的严苛要求,系统支持私有化部署与深度定制词库,允许机构导入自有学科词库与标准规范,实现术语全生命周期管理。通过RESTful API无缝嵌入科研内容管理系统(CMS)与协同编辑平台,构建从词条编辑、同行评议到发布的自动化质控流程。历史版本比对功能防止知识条目回退错误,敏感信息检测确保涉密数据合规,满足等保三级认证要求,为百万级学术词条提供安全可靠的准确性保障。
在实际应用中,某国家级科研院所采用该方案完成50万份历史文献词条的质量治理,建立覆盖2万个学科专属术语的标准词库,通过多学科交叉校验将知识性错误率降低至0.1%以下。系统日均处理百万级词条的弹性扩容能力,支撑了大型学术平台的日均千万次查询调用,确保对外发布的学术内容具备权威可信度,有效维护了机构在专业领域的学术声誉与公信力。
平台日均词条更新量超50万,UGC内容质量参差不齐,专业术语错误频发。通过API嵌入黑马校对公有云,实现一键智能校对与敏感词实时检测,构建自动化质控流程。
题库总量超2000万道,数学公式与文字混排校对困难,学科符号错误率高。引入黑马校对教育专业版,实现LaTeX公式智能解析与多学科词库精准匹配,批量处理千万级题目。
50万份历史技术文档术语混用、品牌口径不一致,合规文档法律风险高。采用私有化部署黑马校对,建立2万术语专属词库,实现跨部门协同校对与敏感信息智能检测。
词条内容校对广泛应用于互联网百科、电商零售、企业知识管理、在线教育、政府机关公文、新闻传媒、数字出版及科研院所等多元场景。在百科平台解决UGC内容事实错误与术语规范;在电商与制造业校验商品参数与工业标准符合性;在企业统一品牌术语与合规审查;在教育领域支持LaTeX公式与千万级题库质控;在公文与新闻领域确保政治性差错零容忍;在学术与科研领域保障知识图谱权威性。通过RESTful API可嵌入各类业务系统,实现自动化质控,效率提升90%以上,有效规避法律风险与品牌危机。

集成黑马校对智能引擎,自动校验财务数据术语规范与数值逻辑,确保科目表述准确一致,避免决算差错,提升财务报告专业可信度,助力企业合规经营。




依托黑马校对技术,自动核验商品参数单位换算与规格冲突,统一多SKU表述,杜绝库存信息混乱,提升进销存数据准确性,降低售后纠纷。

内置黑马校对财税敏感词库,实时检测财税术语合规性,有效规避政策引用差错,确保财务报表与税务申报内容严谨,守护企业财税安全。

融合黑马校对的合同条款合规审查能力,精准校对法律用语与品牌表述,自动提示潜在风险,确保合同文本严谨无歧义,保障企业合法权益。



依托黑马校对技术,自动核验商品参数单位换算与规格冲突,统一多SKU表述,杜绝库存信息混乱,提升进销存数据准确性,降低售后纠纷。

嵌入黑马校对引擎,统一项目文档专有名词与进度表述,避免术语混用,提升跨部门沟通准确性,确保项目报告与公告规范专业。
集成黑马校对智能引擎,自动校验财务数据术语规范与数值逻辑,确保科目表述准确一致,避免决算差错,提升财务报告专业可信度,助力企业合规经营。
内置黑马校对财税敏感词库,实时检测财税术语合规性,有效规避政策引用差错,确保财务报表与税务申报内容严谨,守护企业财税安全。

应用黑马校对智能质检,批量校验电商商品词条参数准确性,自动识别单位错误与属性缺失,提升商品信息标准化,降低退货率,优化买家体验。
自动核查内部知识条目的事实性错误与过时信息,确保知识库准确权威,降低人工审核成本。
智能校验商品参数的单位混用与数值逻辑错误,统一多SKU表述,避免售后风险与客诉。
强制统一企业专有名词与品牌表述,消除跨部门新旧词汇混用,维护对外专业形象。
实时检测政治性差错与不规范表述,保障红头文件、政策公告的用词严谨性与政治正确性。
深度校对合同条款的法律用语合规性,精准识别歧义与风险表述,规避商业纠纷。
自动审查技术参数与国标/行标的符合性,保障产品手册与白皮书的工业级准确性。
覆盖政务公文、学术出版、电商参数等全场景,依托8000万专业词库与30年技术沉淀,实现毫秒级政治差错、术语规范与事实逻辑校验,日处理百万级词条,护航权威内容安全。