

AI 文档翻译
支持多语种精准互译,结合上下文语义理解,避免专业术语错译,确保跨语言文档的准确性与规范性,助力国际学术交流与出版。
支持多语种精准互译,结合上下文语义理解,避免专业术语错译,确保跨语言文档的准确性与规范性,助力国际学术交流与出版。

支持多人实时协同编辑,内置高频错字智能审查,确保团队文档用词规范统一,提升审校效率,适用于出版、政务等多领域协作场景。

智能识别表格中的术语错写与计量单位错误,支持数据规范校验,结合高频错字清单,确保数据文档的文字与内容双重准确性。

基于10亿字语料库,精准识别形近音近义近错字,支持自定义词库与批量修正,深度适配出版、政务、新闻等多领域三审三校流程。

AI辅助文档创作,实时集成高频错字检测与政治性审查,自动标记不规范用语,构建从创作到校对的全流程内容质量保障体系。
WPS黑马校对高频错字清单基于10亿字新闻出版语料库构建,严格参照《现代汉语词典》等国家标准,建立2万余个高频错字别字权威词库。自动检测形近字误用、音近字混淆、义近字错写及习惯性错写,实时高亮定位并提供正确用词建议,支持一键批量修正与自定义词库。深度适配教育出版三审三校、政府公文处理、新闻媒体采编、科技期刊审校等场景,较人工校对效率提升百倍,显著降低文字差错率,保障内容专业性与规范性。
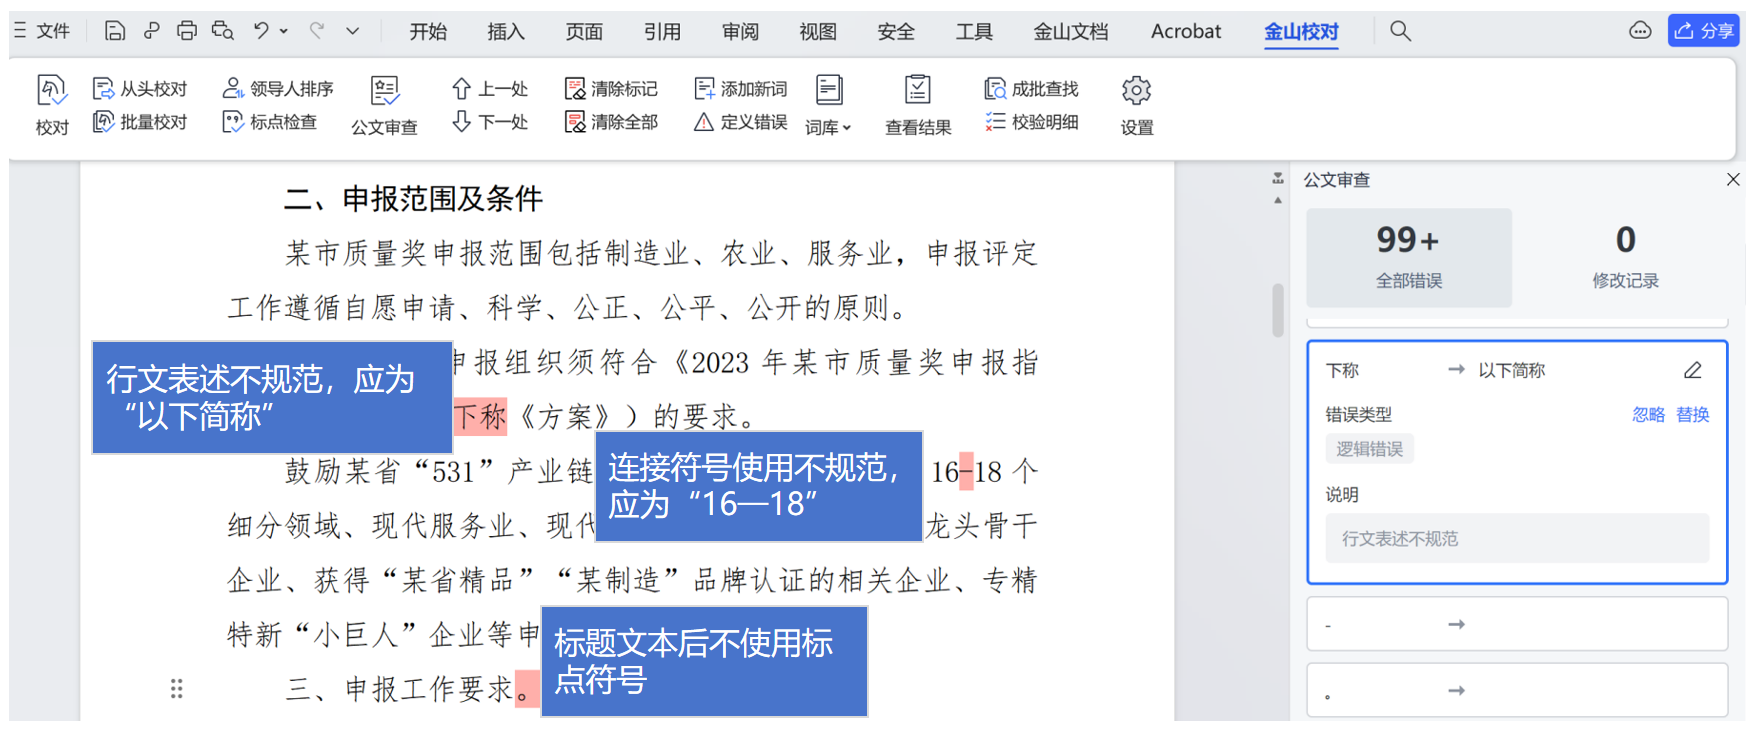
黑马校对的高频错字清单功能基于10亿字新闻出版语料库构建,严格参照《现代汉语词典》《通用规范汉字表》等国家标准,建立包含2万余个高频错字别字的权威词库。该功能可自动检测并标记文稿中的形近字误用、音近字混淆、义近字错写及习惯性错写,如同音别字"做/作"、形近错字"赢/羸/嬴"等,实时高亮定位错误位置并提供正确用词建议,支持一键批量修正与忽略操作,同时允许用户自定义添词以适配单位特色用语习惯。
相较于普通拼写检查仅识别明显错误,该功能基于语义分析智能识别上下文错字,覆盖图书出版、政府公文、新闻采编等多领域场景。以教育出版为例,该功能可深度适配三审三校流程,建立标准化错字防范体系;在政务领域,能有效辅助公文规范性审查;针对新闻媒体,则支持日更海量稿件的快速校对需求,显著提升内容专业可信度与编校效率。
此外,系统还整合异形词与不规范用语校对、专业术语与领域专用词校对等扩展能力,严格对标国家语言文字规范标准,识别生造词与非规范网络用语,并针对科技、医学、法律等专业领域的术语错写、计量单位符号错误进行深度排查,确保各类正式文稿的严肃性与规范性。
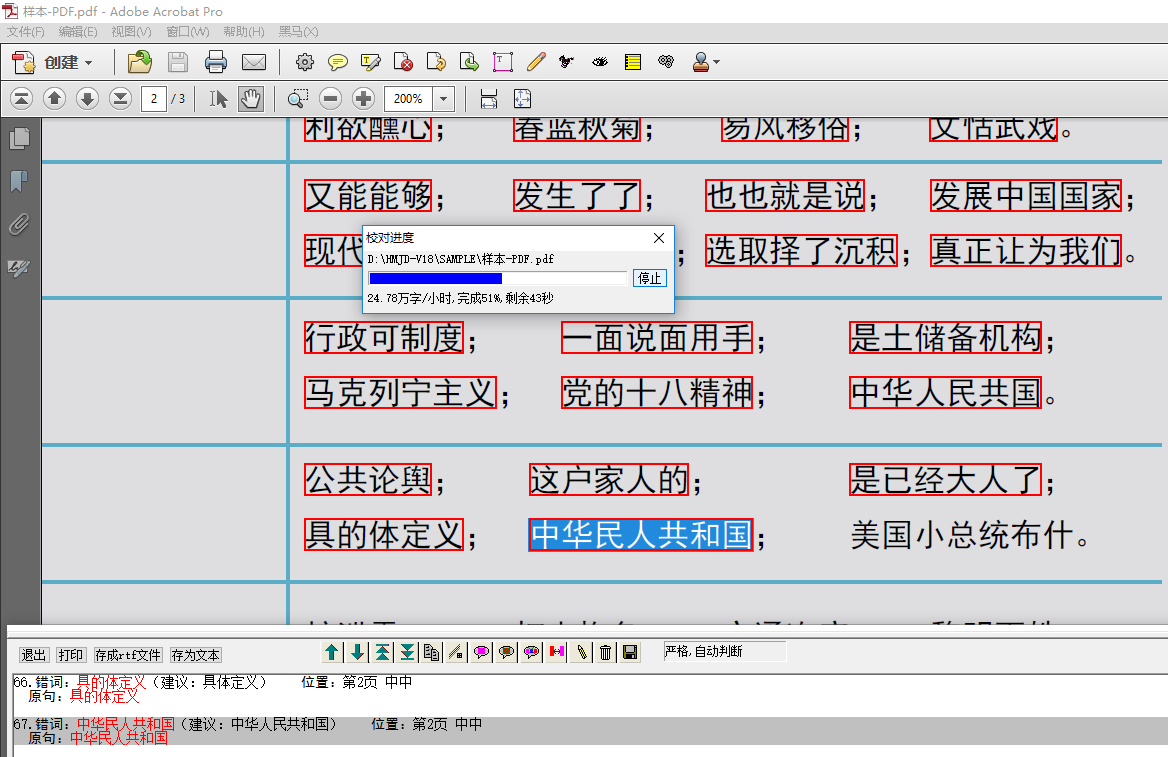
在教育出版领域,高频错字清单深度嵌入三审三校流程,针对教材教辅季节性集中出版的压力,建立标准化错字防范体系。某大型教育出版社年出教材500余种,引入该功能后建立专属错字库,三审三校错字检出率提升80%,2024年续费3年20亿字服务,全面保障千万学生用书零差错。政府机关应用中,该功能结合政治性合规审查,年处理公文超10万份,完全替代传统人工二审环节,显著提升政务文件处理效率与权威性。
新闻媒体行业借助实时高频错字清单与极速校对能力,实现日更海量稿件的高效零差错出版。某大型某团某下辖5份日报,部署后日处理稿件超2000篇,标题错字实现零失误,编辑校对效率提升70%。科技期刊领域则通过学术术语库与高频错字双引擎,满足SCI期刊国际化出版需求,某某院某主管SCI期刊年发文2000篇,引入后编校周期缩短50%,文字差错率降至万分之一以下,有效维护学术声誉。
系统支持公有云、局域网及单机等多种部署模式,既满足出版社弹性订阅需求,又适配政府机关涉密环境,通过内网服务器授权方案彻底免除U盘依赖,确保数据安全与校对效率的双重保障。
黑马校对的高频错字清单不仅提供标准化的权威词库,更支持用户根据行业特性与单位用语习惯构建专属自定义词库。用户可自主添加行业术语、产品型号、机构名称等特色词汇,系统在智能分析时会优先匹配这些词条,有效避免专业术语被误判为错别字,同时允许标记单位高频易错词,形成个性化的错字防范屏障。这种"标准+自定义"的双轨模式,既确保符合国家语言文字规范,又兼顾了不同领域的特殊表达需求,显著降低了专业文档的误报率,提升了校对精准度与工作效率。
该功能与异形词规范检查、专业术语校对、政治性敏感词审查等模块深度协同,构建起覆盖文字规范、专业表达、内容安全的立体化智能审校体系。在科技出版领域,系统能精准区分"碳"与"炭"等化学术语差异;在政务场景中,可同步排查领导姓名职务排序错误与文字差错;针对新媒体运营,则能有效拦截"绝绝子"等非规范网络用语混入正式文稿,全方位保障文本的严肃性与规范性。
系统提供公有云订阅、局域网服务器、单机加密锁等多种部署方案,灵活适配不同单位的安全等级与网络环境。涉密单位可采用内网服务器授权彻底免除U盘依赖,确保数据物理隔离;出版机构可选择云端弹性订阅应对季节性业务高峰;个人用户则可通过单机版实现离线高效校对。配合持续更新的语言规范库与7×24小时技术支持,为用户提供长期稳定的零差错内容保障能力。
黑马校对高频错字清单采用"规则库+语料库+深度学习"混合技术架构,突破传统拼写检查仅依赖字面匹配的局限,基于上下文语义分析精准识别隐性错字。系统通过NLP模型深度理解文本逻辑,有效区分"的/地/得"等语法易混词,识别"碳/炭"等专业语境下的术语正误,并能根据行业特性动态调整识别策略,误报率较传统方式降低60%以上。
相比人工逐字校对,该功能效率提升百倍且不受疲劳度影响,可实现7×24小时无间断质量监控。编辑人员无需通读全文,通过实时高亮定位与一键批量修正功能,仅需聚焦系某标某记的疑点进行复核,形成"机器初筛+人工确认"的高效协同模式。某省级报社应用后,单篇稿件平均审校时间从15分钟缩短至3分钟,夜班编辑工作强度显著降低,同时实现标题错字零失误。
系统具备持续进化能力,基于10亿字动态语料库每月自动更新词库,及时纳入新兴网络用语规范及最新国家标准修订内容,如《通用规范汉字表》调整词条。配合7×24小时技术支持团队与定制化培训服务,确保用户始终掌握最优校对策略,构建从即时纠错到长期质量管理的完整内容保障生态,为高时效出版场景提供稳定可靠的技术支撑。
教材教辅出版量大、出书季节集中,人工审校难以全覆盖高频错字、形近字混淆等问题。引入高频错字清单功能,深度嵌入三审三校流程,建立标准化错字防范体系与专属错字库,实现全流程智能纠错。
政务公文高频错字、同音字混用多发,人工审核无法全面覆盖海量文件且效率低。以高频错字清单结合政治性审查,打造智能校对体系,自动化排查错字与格式,替代人工逐字核查。
日报出版时效强、稿件量巨大,标题与正文错字严重损害媒体公信力。部署高频错字实时清单与极速校对,无缝嵌入采编三审三校流程,构建全链条错字防控,实现海量稿件高效处理。
黑马校对高频错字清单基于10亿字语料库及国家标准构建2万余条权威词库,运用"规则库+深度学习"混合技术,通过上下文语义分析精准识别形近字、音近字、义近字及习惯性错写(如"的/地/得""碳/炭"),误报率降低60%以上。支持实时高亮定位、一键批量修正与忽略,并允许自定义添词适配专业用语。深度嵌入三审三校流程,覆盖出版、政务、新闻等多领域,实现7×24小时智能质量监控,显著提升编校效率与文本规范性。

集成WPS黑马校对高频错字清单,基于10亿字语料库与国标规范,智能检测业财文档中的易混字与习惯错写,确保专业表达准确,提升业财数据严肃性。




内置黑马校对引擎,自动识别进销存报表、合同中的形近字与音近别字,提供一键修正建议,显著降低人工复核成本,保障业务单据零差错。

融合黑马校对高频错字检测,对项目计划、验收报告进行语义级校对,有效防范术语误用与不规范用语,提升项目文档的专业规范度与交付质量。
集成WPS黑马校对高频错字清单,基于10亿字语料库与国标规范,智能检测业财文档中的易混字与习惯错写,确保专业表达准确,提升业财数据严肃性。

搭载黑马校对能力,深度校对会计凭证、财务报表中的错别字与非规范用语,辅助财务人员快速发现隐性错误,保障会计信息专业可信。
内置黑马校对引擎,自动识别进销存报表、合同中的形近字与音近别字,提供一键修正建议,显著降低人工复核成本,保障业务单据零差错。

内置黑马校对高频错字检测,精准识别合同文本中的易混字与习惯性错写,防范因错别字引发的法律风险,确保每一份合同的严谨性与权威性。



融合黑马校对高频错字检测,对项目计划、验收报告进行语义级校对,有效防范术语误用与不规范用语,提升项目文档的专业规范度与交付质量。

搭配黑马校对引擎,自动校对采购单、销售合同中的错别字与不规范用语,提升进销存单据准确性,从细节处降低业务错误,增强经营数据可信度。
深度适配三审三校流程,建立错字防范体系,错字检出率提升80%,保障零差错。
结合政治性审查,自动纠正高频别字,年处理10万份公文,替代人工二审。
实时校对日更2000篇稿件,标题错字零失误,编辑效率提升70%以上。
专业术语深度校对,满足SCI出版需求,编校周期缩短50%,差错率低于万分之一。
智能拦截“绝绝子”等非规范用语,维护品牌内容严肃性与专业调性。
嵌入命题审校与教材编写环节,杜绝错别字,守护千万学生用书零差错。
基于10亿字权威语料库与语义分析技术,精准识别2万余高频错字,支持自定义词库,实时高亮建议,一键修正,让出版、政务、媒体文稿零差错更高效。