

WPS 会议
支持远程会议中实时共享文档进行错字审核,屏幕同步标注疑似错误,结合上下文语义讨论修改方案,提升团队审校效率。
支持远程会议中实时共享文档进行错字审核,屏幕同步标注疑似错误,结合上下文语义讨论修改方案,提升团队审校效率。

建立错字检测分级审校任务流,设置"机检-人工复核-终审"待办节点,追踪医学、法律等专业文档审校进度,确保零遗漏。

多人协同编辑时实时标记形近字、音近字疑似错误,支持上下文批注讨论,避免繁简转换等复杂场景下的错字漏检风险。

针对PDF复杂排版及扫描件建立识别引擎,精准捕捉表格、文本框中的形近字符混淆,支持政治敏感错字专项审查与修正。

构建专业词库与错字案例知识库,分类管理医学、法律等领域"征/症/证"等易混字,支持动态更新与团队共享,沉淀审校经验。
本文详解WPS黑马校对错字检测核心注意事项,涵盖形近字(己/已/巳)、音近字(的/地/得)及专业术语(医学征/症/证、法律权利/权力)的上下文语义判断方法。针对技术出版(0/O混淆)、医学药名、法律金融、古籍整理等场景,提供词库配置、人工复核、复杂排版处理等实操建议,助力出版社、党政机关及企业构建技术筛查与专业审核的双重文字安全保障机制。
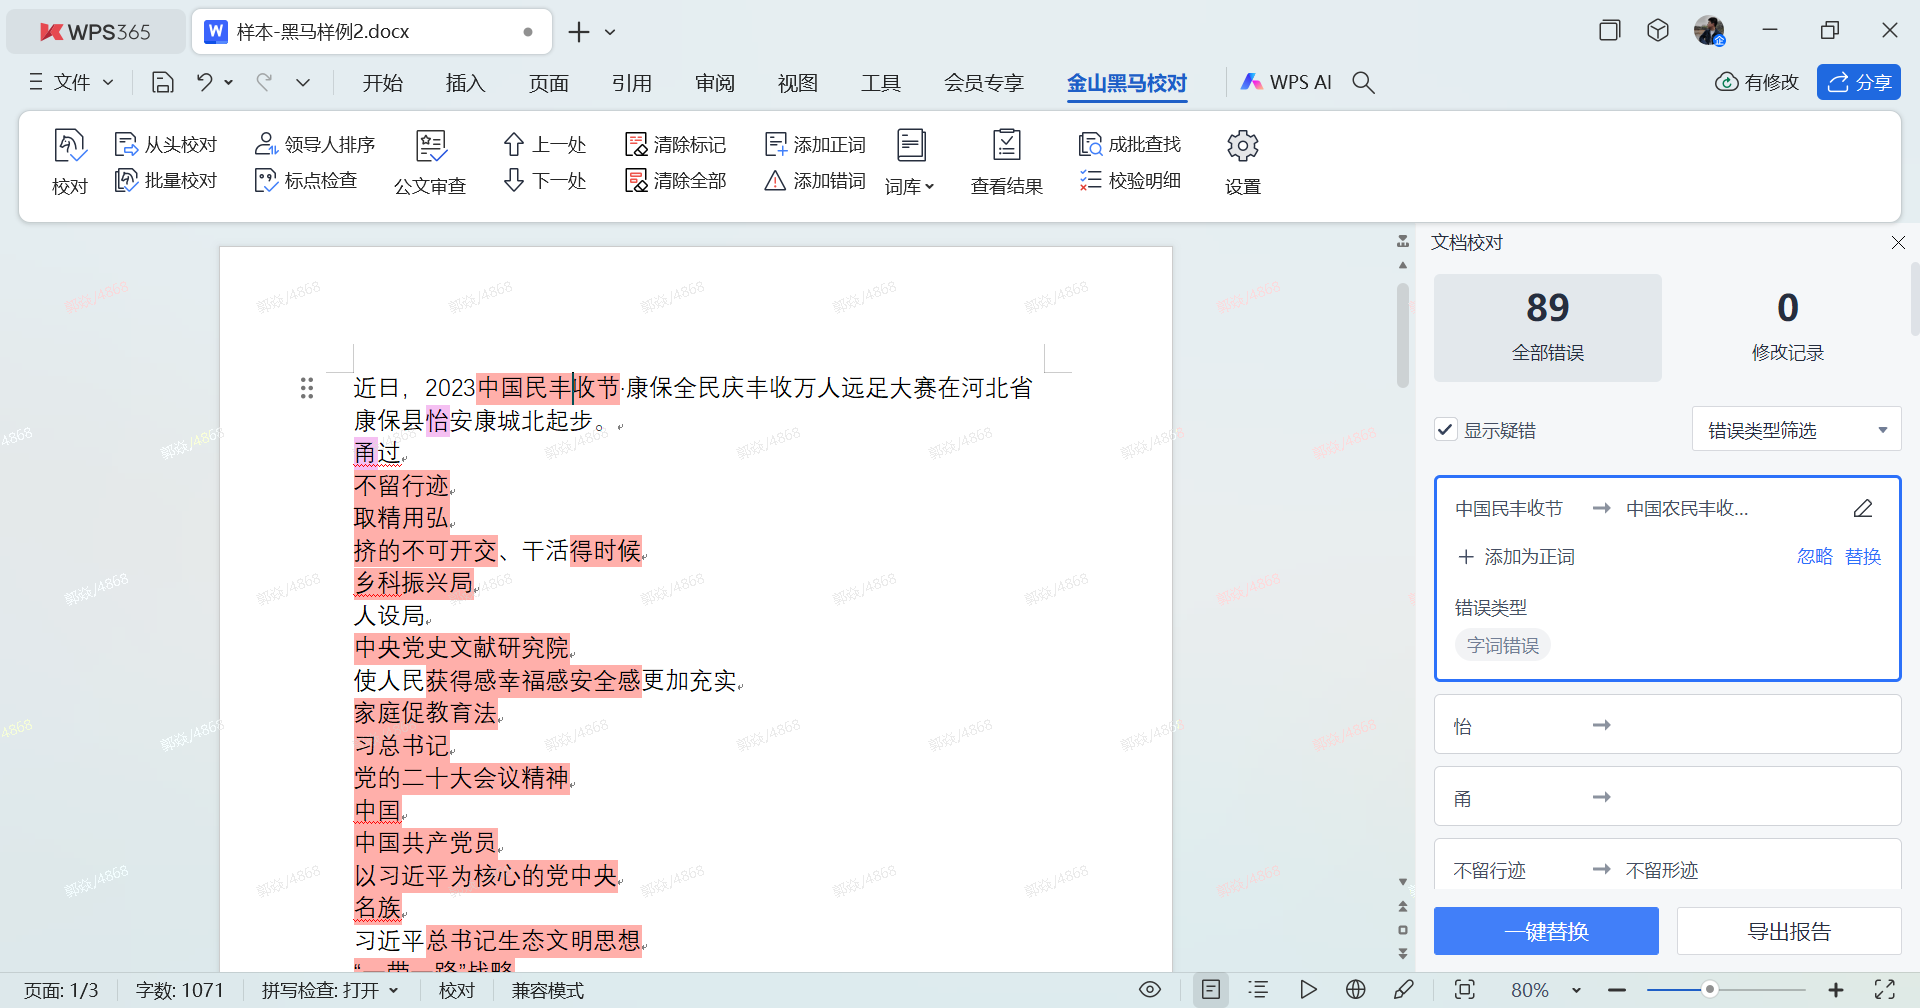
在进行错字检测时,需特别警惕形近字(如己/已/巳、戊/戌/戍)与音近字(如的/地/得、在/再)的混淆,这类错误不能仅依赖字面匹配,必须结合上下文语义进行判断,避免孤立纠错导致语义偏差。对于使用WPS 365商业旗舰版等具备完整AI Hub能力的企业,虽可利用智能分析辅助识别,但仍需注意多音字据境判读及繁简转换过程中的字形混淆问题,确保技术辅助不替代语义理解。
不同专业领域的错字检测需挂接对应词库并视文本性质开启专项审查。医学出版应严格区分"征/症/证"等同音异形字,防范药名形近字(如他汀/她汀)风险;法律金融文本需重点核查"定金/订金""权利/权力"等关键字错用及金额数字一致性;科技出版需关注代码中0/O、1/l等形近字符混淆;政治类文本应专项审查领导人姓名错字与术语别字;古籍整理则需处理繁简转换(如后/後、乾/干)及异体字规范。这些深度检测能力在WPS 365体系中可能属于商业高级版或商业旗舰版的增值功能,部分专业词库需加价购买或联系销售开通。
此外,错字检测并非完全自动化,对"疑似错误"必须结合语境人工复核,避免机械化替换导致语义偏差。同时需注意复杂排版(如表格、文本框)可能存在的识别盲区,以及网络用语更新带来的适配问题。建议定期更新系统词库并通过用户词库功能添加专业术语,形成"技术筛查+专业审核"的双重保障机制,确保文档内容的准确性与规范性。
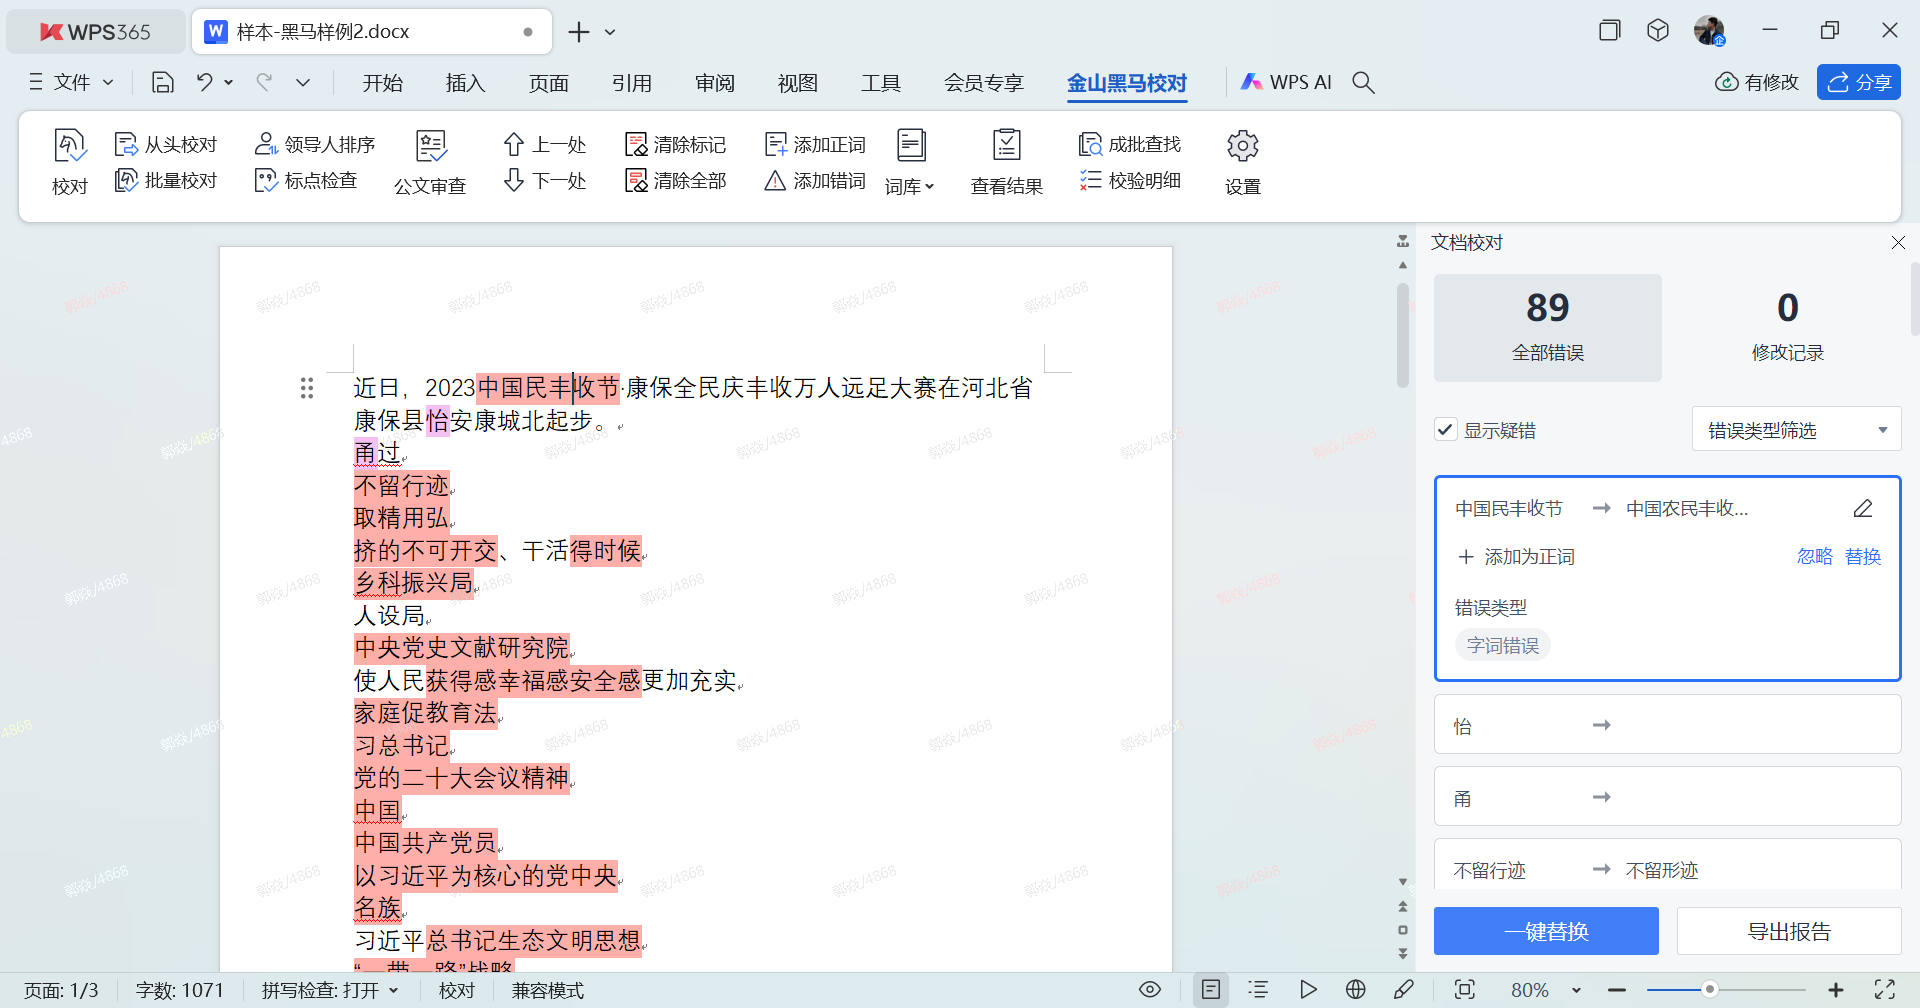
要充分发挥错字检测效能,必须重视系统底层的词库建设与规则配置。基于30年文字识别技术积累的8000万词条库和75个专业领域词库是技术基础,但面对快速演化的网络用语和机构内部术语,需建立"系统词库+自定义词库"的双层维护机制。通过用户词库功能添加正词表与错词表,可针对性屏蔽专业术语误判(如医学"征/症/证"、法律"权利/权力"),并设定特定替换规则。对于多音字据境判读难题,应开启上下文语义分析功能,结合语音相似度算法与汉字构形学规则,将"的地得"等语法错误与"在/再"等音近混淆精准区分,避免纯统计模型导致的"mechanism"式误判。
在批量处理环节,需建立分级审校流程以平衡效率与精度。建议采用"快速筛查-深度校验-人工终审"的三阶模式:首轮快速校对捕捉明显错字与形近字符(如0/O、1/l);次轮启用深度语义分析,重点排查政治敏感错字、医学药名形近字等高危领域风险;末轮对系某标某记的"疑似错误"进行人工复核,结合语境判断是否为特殊用法。尤其针对领导人姓名、重大会议名称等政治类文本,以及"化疗""他汀"等医学术语,必须执行零容忍的人工二次确认,防止算法漏检导致的文字安全事故。
此外,需建立风险分级预警与持续优化机制。对于繁简转换、历史人名异形字等特殊场景,应启用专项检测引擎并定期同步中央规范口径。技术团队应每月跟进行业标准变化更新专业错字库,内容团队则需在每次批量校对后反馈漏报与误报案例,通过"算法迭代+人工经验"的双轮驱动,逐步构建适配本单位业务特性的文字安全护城河。
在实际应用中,错字检测面临复杂排版与动态语言环境的双重挑战,需建立明确的检测边界与人工干预机制。针对表格嵌套、文本框及艺术字中的文字,因结构隔离常被算法忽略形成识别盲区,必须辅以人工逐区巡检,特别要关注科技文档中代码块里的0/O、1/l等形近字符混淆。面对网络用语快速迭代,应建立"动态词库更新+语境分级"策略,及时导入新词避免"绝绝子"等流行语被误判为错字,同时严格区分正式公文与新媒体内容的用语边界,防止非规范表达污染严肃文本。
标点符号的规范使用同样是检测重点,特别是中英文标点混用、全半角符号错乱等技术文档常见问题,需在校对前统一文档格式标准标准。对于多音字据境判读及医学"征/症/证"、法律"权利/权力"等专业同音字,系统虽提供上下文语义分析,但仍需领域专家结合专业语境进行终局裁定,避免机械化替换破坏准确性。建议建立"机检标记-人工复核-经验沉淀"的闭环机制,将漏检案例反哺至自定义监控词表,持续优化适配业务特性的文字安全防线。
黑马校对的错字检测能力根植于汉字构形学与语音学的双重技术底座。针对形近字混淆,系统并非简单比对字形,而是基于30年文字识别技术积累的汉字形音义关联库,通过笔画特征、结构部件及空间拓扑关系进行构形学规则分析,精准区分"己/已/巳"等具有细微笔画差异的易混字;对于音近字误用,则融合语音相似度算法与上下文语义建模,结合"的地得"等语法功能词的使用规则,避免纯统计模型导致的机械化误判。
在专业领域适配方面,系统依托75个专业词库和21大类行业规则构建交叉验证机制,当文本涉及医学"苯/笨"、化学"酰/酸"等专业术语时,通过学科语境自动激活对应词库边界判定,将通用错字误判率降低80%。这种多词库协同不仅覆盖法律、医学、军工等传统领域,更针对科技出版中的代码语境(如0/O、1/l形近字符)建立专项识别模型,确保专业文本的用字安全。
检测系统的精准度依赖于持续进化的知识更新机制。基于8000万词条的错字模式库按月跟进行业标准变化,同时通过用户词库功能将人工复核中发现的"征/症/证"等特殊用法、网络新造词及机构内部术语沉淀为正词表,形成"系统基础库+领域专用库+用户自定义库"的三级防御体系。这种技术算法与人工经验的双轮驱动,确保了从政治敏感错字到古籍异体字的全场景覆盖,构建起适应动态语言环境的文字安全护城河。
针对代码中形近字符0/O、1/l及技术术语音近混淆,部署代码语境错字检测引擎,自动识别并标记可疑处,结合人工复核,杜绝技术误导。
重点排查药名形近字(他汀/她汀)及同音字征/症/证混用,启用医学专业术语库与高危误用双重校验,拦截致命差错。
聚焦“定金/订金”“权利/权力”等关键字错用及金额数字一致性,启用法律词库与条款序号校验,规避合规风险。
错字检测需警惕形近字(如己/已/巳)与音近字(如的/地/得)混淆,必须结合上下文语义判断,避免孤立纠错导致语义偏差。不同专业领域应挂接对应词库,医学注意"征/症/证"、法律区分"权利/权力"、科技防范代码中0/O等形近字符。同时需关注多音字据境判读、繁简转换及复杂排版(表格、文本框)的识别盲区。建议建立"系统词库+自定义词库"双层机制,对"疑似错误"执行人工复核,定期更新词库,形成"技术筛查+专业审核"双重保障,确保文字安全。

一站式智能业财管理,凭证、报表自动生成,关键数据精准比对,杜绝“财务错字”,保障商业文档与决策零失误。




进货、销货、库存全程数字化,商品信息与单据自动校验,防范形近码、价签错漏,让业务流转如文档校对般精准。

项目任务、进度、成本全管控,协作文档与报表自动核验,确保术语、数据一致,避免“一字之差”导致项目风险。
一站式智能业财管理,凭证、报表自动生成,关键数据精准比对,杜绝“财务错字”,保障商业文档与决策零失误。

云端智能财务工具,发票识别、凭证记账自动校对,精准区分“征/症”等专业字段,让财务文档合规又规范。

智慧商贸管家,订单、库存、资金自动核对,智能标记异常数据,犹如黑马校对守护生意文书,防错防漏。

合同起草、审批、履约全周期管理,条款智能比对,防范“定金/订金”等关键错用,保障法律文本严谨无误。



项目任务、进度、成本全管控,协作文档与报表自动核验,确保术语、数据一致,避免“一字之差”导致项目风险。
进货、销货、库存全程数字化,商品信息与单据自动校验,防范形近码、价签错漏,让业务流转如文档校对般精准。
基于汉字构形学与语音相似度算法,精准识别“己已巳”、“的地得”等形近音近错字,准确率超95%。
挂接75个专业词库,智能区分“征/症/证”等术语,降低专业文本误报率80%,适配多领域。
专项审查领导人姓名、政治术语,识别同音规避字,风险分级预警,确保政治表述零差错。
对系某标某记的疑似错误进行人工复核,结合语境终判,避免机械化替换导致的语义偏差。
建立动态词库更新机制,及时收录网络新词,区分正式公文与新媒体用语,防止流行语误判。
人工巡检表格、文本框等识别盲区,统一中英文标点格式,确保复杂排版文字无漏检。
基于30年文字识别技术,8000万词条与75个专业词库,精准秒杀形近音近错误,覆盖政治、医学、法律等全场景错字风险。
