

WPS 智能表单
适配语音录入场景,自动纠正如"的得地"等音近字错误,确保问卷、登记表信息准确规范,减少人工校验成本。
适配语音录入场景,自动纠正如"的得地"等音近字错误,确保问卷、登记表信息准确规范,减少人工校验成本。

深度集成音近字纠错引擎,智能识别会议录音转写中的同音字错误,精准区分法律、医学专业术语,保障企业文档严谨性。

支持实时语音输入边说边校对,即时修正"在/再""做/作"等高频易混词,结合上下文语义分析确保创作流畅专业。

批量处理语音转写数据,自动识别并修正"权利/权力"等同音术语错误,适配财务、统计等专业领域的高质量数据录入。

智能审查扫描件及转写文档中的音近字错误,支持构建医疗、法律专用词库,确保归档资料术语准确、表述严谨。
WPS黑马校对音近字纠错功能基于上下文语义分析技术,精准识别拼音输入、语音转写及会议录音中的同音字错误,智能区分的/得/地、权利/权力、症/征/证等专业易混词。深度适配法律出版、医学文献、口述历史整理与对外汉语教材编纂场景,支持API/SDK集成与自定义词库,编辑校对效率提升60%以上,法律术语准确率达99.9%,有效保障专业文本的严谨性与权威性。
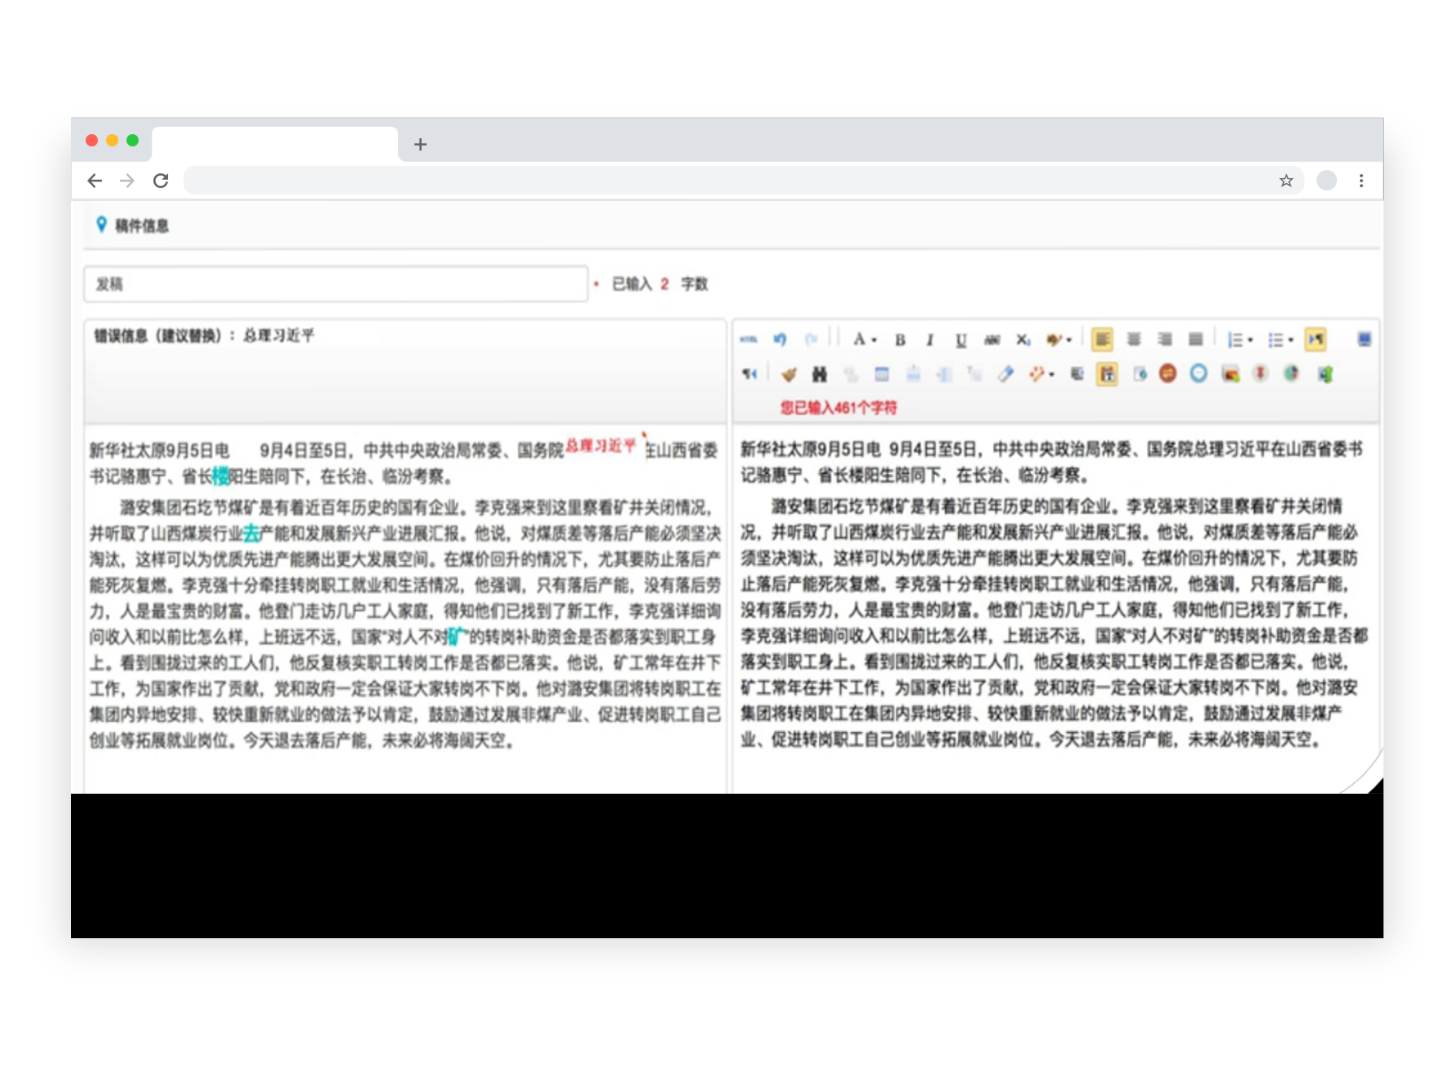
音近字纠错功能主要是针对拼音输入、语音转写及快速录入过程中产生的同音字、近音字错误进行智能识别与自动修正。该技术并非基于简单的词典匹配,而是通过上下文语义分析,精准区分的/得/地、在/再、做/作等高频易混词,以及"权利"与"权力"、"体征"与"体症"等专业领域同音术语,有效解决了传统校对中因音近字泛滥导致的专业性受损问题。
在实际应用中,该功能深度适配语音办公场景,能够批量处理会议录音转写稿、口述历史记录及法律文书,自动修复"按部就班"误作"按步就班"等成语错误,并针对医疗、法律、金融等行业构建专用词库,实现拉丁音译词、专业简称的智能统一。相较于通用文本校对工具,其结合语境理解的能力可大幅降低专业文档中的音近字误报率,显著减少人工听校工作量。
对于内容创作团队、新闻出版机构及企业文档管理部门而言,音近字纠错不仅提升了语音输入场景下的文字规范化效率,更通过智能区分易混同音词,保障了法律文本的严谨性、医学文献的准确性及对外汉语教材的规范性,成为专业文稿质量管控的重要技术支撑。
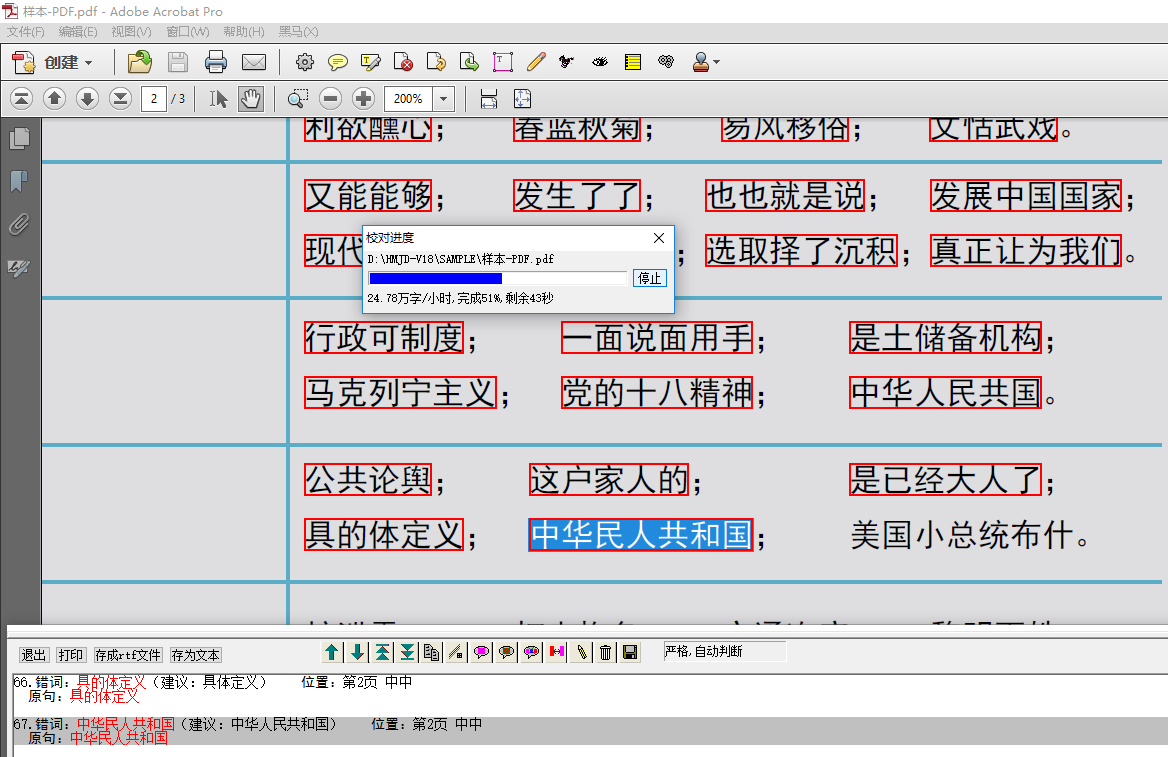
音近字纠错功能在专业出版与文档处理领域展现出显著的跨行业适配能力,针对不同领域的术语特性构建专用识别模型。在法律出版场景中,系统精准区分"权利"与"权力"、"制定"与"制订"等高频易混法律术语,有效识别庭审记录语音转写中的同音字错误,确保法律文本的严谨性与权威性;在医学出版领域,通过深度理解"症、征、证"的语义差异,准确校正"适应症"与"适应证"、"并发症"与"合并症"等专业表述,从根本上规避医疗知识传播风险。相较于通用校对工具简单的词典匹配模式,该功能结合行业语境进行智能判断,大幅降低专业术语误报率。
针对口述历史、访谈录整理及对外汉语教材编纂等特殊场景,该功能同样发挥关键作用。在处理抗战老兵口述录音转写稿时,系统批量纠正"的得地"、"在再"等口语化音近错误,实现口语向书面语的高效转换;在对外汉语出版中,精准识别"他/她/它"、"做/作"等易混词,避免非母语学习者受错误内容误导。无论是音像出版社的访谈整理,还是国际中文教育教材审校,均能通过自定义专业词库实现个性化校对需求。
实际应用数据表明,该功能可显著提升专业文档处理效率,法律出版机构编辑校对效率提升60%以上,医学教材出版周期缩短30%,口述史料整理时间减少70%,同时将法律术语准确率提升至99.9%。通过深度适配语音输入、录音转写等现代办公场景,音近字纠错不仅解决了传统人工逐字检查耗时费力的痛点,更通过智能语境分析为专业文档质量管控提供了可靠的技术保障。
与WPS等通用办公软件的校对功能相比,黑马校对并非仅提供基础的拼写检查,而是专注于中文语境下的深度专业校对,尤其在政治性差错、领导人姓名及重要表述的审查上具备不可替代的严谨性。系统支持标准API与SDK开发接口,可无缝集成至新闻采编系统、OA办公平台及内容管理系统,实现自动化文本质量管控,大幅降低开发成本与人工校对压力。针对保密单位的特殊需求,除传统加密锁外,亦提供软件授权码、网络授权等无硬件部署方案,确保涉密环境下的合规使用。
在个性化配置方面,用户可自主导入行业术语、禁用词及黑白名单,构建专属词库,满足法律、医学、教育等不同领域的精细化校对需求。面对成本顾虑,系统提供单机版买断、网络版年租及模块化订阅等灵活付费模式,并支持免费试用,用户可先行验证其在减少差错与提升效率方面的实际价值。凭借高达95%以上的中文校对准确率,结合对拼音输入音近字、语音转写错误的精准识别能力,黑马校对不仅显著降低了专业文档的错误率,更通过便捷的操作体验与灵活的授权机制,成为新闻出版、政府公文及企业文档管理领域质量保障的高性价比选择。
音近字纠错功能采用深度学习与自然语言处理技术,实现从"事后检查"到"实时干预"的跨越。在语音输入或实时转写场景中,系统能够边说边校对,即时标注"的得地"、"在再"等高频错误,无需等待文本生成后再批量处理。这种流式处理能力依托于上下文语义分析引擎,可在用户输入过程中动态预判词义,精准区分同音异义词的语境用法,将纠错动作无缝嵌入创作流程,避免打断写作思路,特别适用于直播字幕生成、会议实时转写等时效性极强的场景。
针对组织内部的特殊用语和行业新词,系统支持构建自适应学习机制。用户不仅可导入自定义词库与黑白名单,更可通过"纠错反馈"训练系统识别特定领域的音近字模式,如企业专属术语、项目代号或方言发音习惯。随着使用频次增加,系统持续优化专业术语的权重配置,降低特定行业用语的误报率,形成"越用越准"的个性化校对模型。这种人机协同机制既保留了机器处理速度优势,又融入了人工专业判断,确保法律合同中的"权利权力"、医学文献中的"症征证"等关键术语在长期使用中实现零差错识别。
在与现代办公生态的融合中,该功能可无缝对接语音输入软件、AI转写引擎及内容管理系统,构建"语音采集-实时纠错-人工终审"的质量管控闭环。对于保密单位,系统提供离线部署方案与无硬件授权模式,确保敏感文档的音近字审查在本地安全完成;而对于分布式团队,云端协同校对支持多人实时批注与术语库共享,有效消除跨地域协作中的音近字歧义,全面提升专业文档的规范化水平与生产效率。
庭审记录语音转写后“权利/权力”等法律术语同音字错误频发,人工审核耗时且易遗漏。引入黑马校对音近字纠错,深度适配法律词库,精准识别并校正易混术语。
医学教材中“症/征/证”等音近术语混淆,传统校对难以全面排查,存在误导风险。采用医学专用音近字纠错引擎,智能区分“适应症/适应证”等关键表述。
抗战老兵口述录音转写稿中“的得地”“在再”等口语化音近错误极多,手动校对低效。运用音近字纠错批量处理,实现口语到书面语高效转换。
音近字纠错功能主要针对拼音输入及语音转写过程中产生的同音字、近音字错误进行智能识别与自动修正。该技术基于深度学习与上下文语义分析,而非简单词典匹配,可精准区分的/得/地、权利/权力、症/征/证等高频易混词及专业术语,有效解决传统校对中因音近字泛滥导致的专业性受损问题。功能深度适配语音办公场景,支持会议录音转写、口述历史、法律文书等批量处理,实现实时流式纠错与自适应学习,显著提升法律、医学、出版等领域文档处理效率与准确性,大幅降低人工听校工作量。

集成WPS黑马校对,智能识别合同中的“权利/权力”等法律音近词错误,确保条款表述严谨,大幅降低人工审校成本,提升合同管理效率与合规性。




融合黑马校对音近字纠错,在进销存业务单据与报表中精准修正同音字错误,保障数据准确,避免因文字差错引发的业务误解与财务风险。

结合黑马校对专业引擎,自动校对项目文档中的术语一致性、音近词错误,尤其适用于工程、科研等专业场景,提升交付质量与团队协作效率。
WPS合同管理深度集成黑马校对,针对法律文书高频音近词实时纠错,从源头保障合同文本的严谨性,助力企业合规与风险防控。

在进销存全流程中嵌入黑马校对,自动修正商品名称、单据备注中的音近字错误,减少人工核对工作量,确保业务流转准确高效。
项目管理文档自动启用黑马校对,精准区分易混术语与惯用音近词,保证项目计划、报告等文档的专业性,减少沟通歧义。

好业财结合黑马校对,自动审校财务分析、合同等文档中的音近字错误,提升业财一体化场景下的文本准确性,降低人工校对负担。




在好会计的凭证、报表及财务报告环节,黑马校对智能纠错音近字,避免因错别字导致的账务偏差,保障会计信息质量。
好生意集成黑马校对后,在进销存单据、营销文案中实时修正同音错字,提升业务文档规范性,让生意管理更省心。
批量修复转写稿中的/得/地、在/再等高频错误,减少人工听校工作量90%以上。
精准区分权利与权力、制定与制订,保障法律文本严谨性,术语准确率99.9%。
智能识别体征与体症、适应证与适应症,规避医疗知识传播风险。
快速转换口语化表达,纠正成语音近错用,口述整理时间缩短70%。
边说边校对,动态区分同音异义词,适用于直播与会议实时转写场景。
支持导入专属术语与黑白名单,构建个性化校对模型,越用越精准。
基于语境语义分析的音近字智能纠错,专为法律、医学、出版等行业打造,支持实时干预与专属词库,让文档质量零缺陷。
