

AIPPT
一键生成专业PPT,智能排版配色,让公文汇报演示更规范高效。
一键生成专业PPT,智能排版配色,让公文汇报演示更规范高效。

集成黑马校对与AI写作,实现公文异体字智能检测与全流程协作。

智能提取合同、档案关键信息,自动化处理海量异体字文档。

公文审核任务实时追踪,确保三审三校流程闭环管理不留遗漏。

代码级文档处理支持,助力编务系统API对接与定制化开发。
针对公文中'馀'与'余'、'後'与'后'、'發'与'发'等异体字混用难题,WPS黑马校对提供智能检测方案。对照《通用规范汉字表》,区分历史人名、引文场景与正文规范,支持批量检测与自定义白名单,分钟级完成全量排查,已服务高校出版社、省级政府等机构。
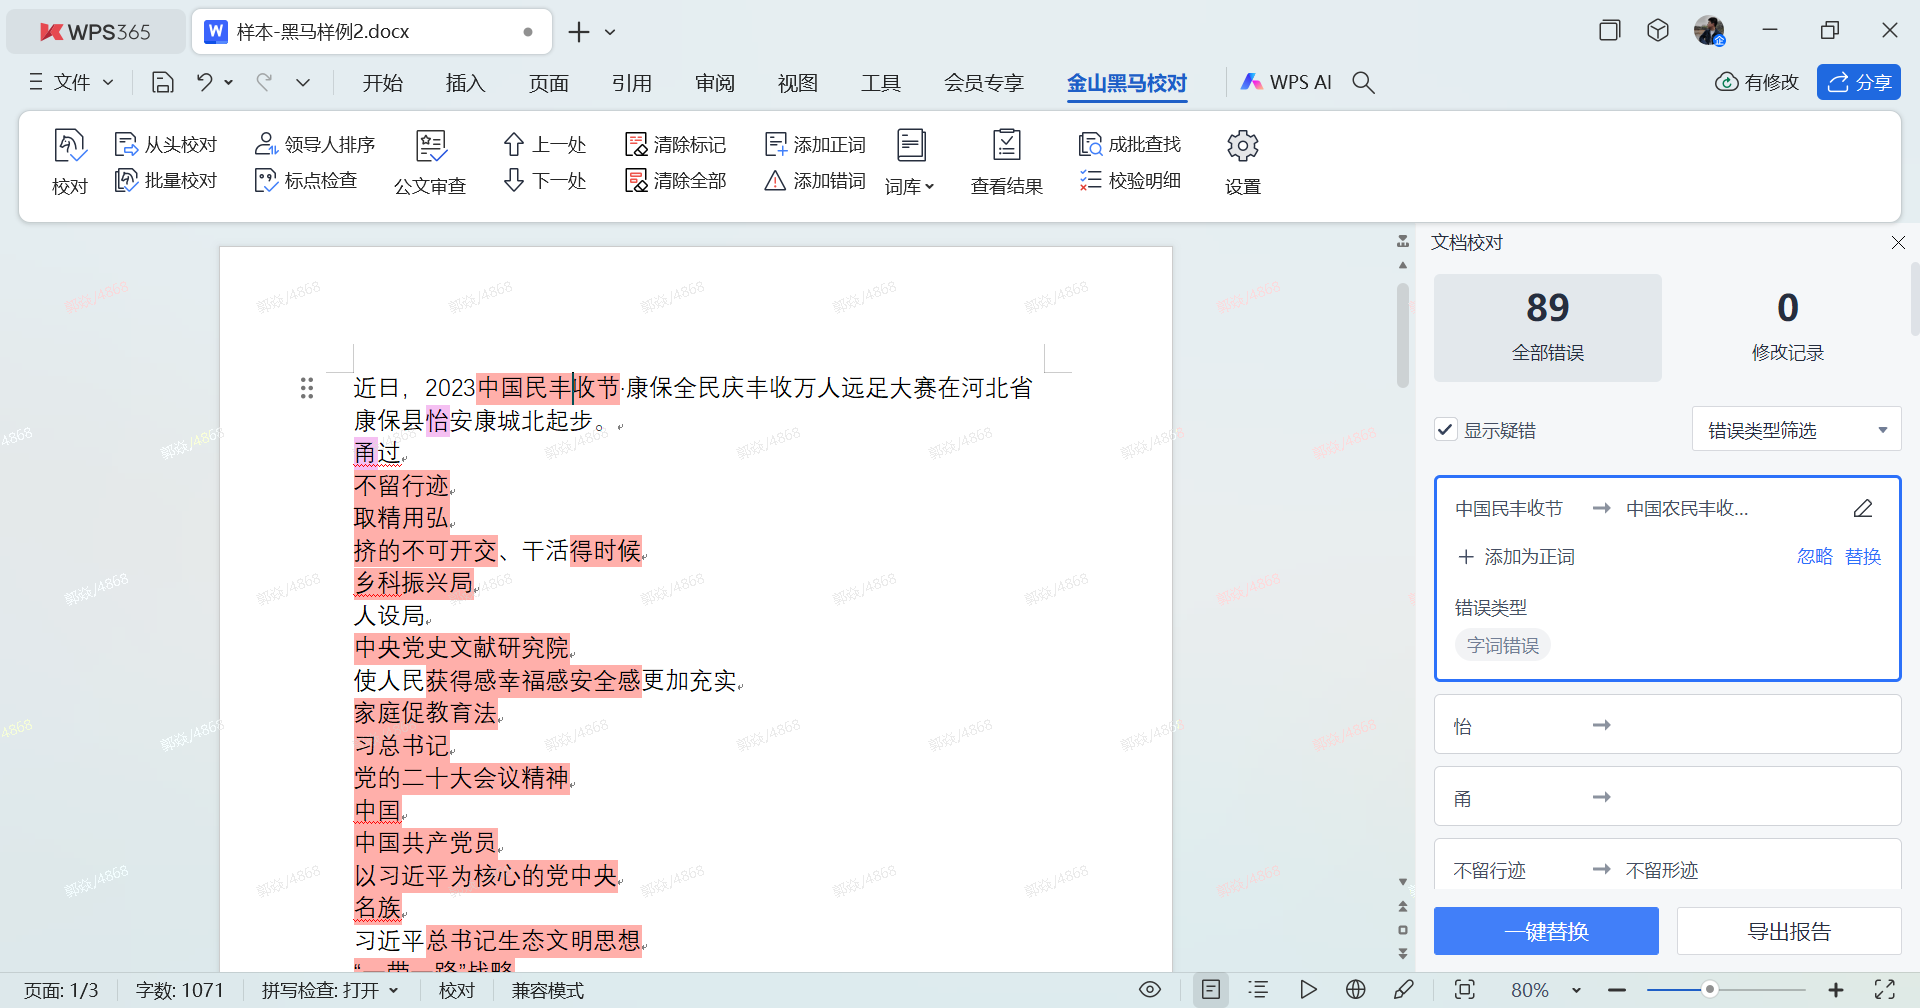
公文异体字检查中,'馀'与'余'、'後'与'后'、'發'与'发'等混用问题尤为突出,古籍引用与历史文献转录场景下的异体字识别更是人工核查的难点。此外,'覆'与'复'、'乾'与'干'等易混异形体在大量文稿中快速排查困难,标准不统一易导致公文印制错误,甚至引发权威性质疑。针对这些痛点,WPS内置的公文异体字智能检测功能可对照国家语言文字规范,智能区分历史人名、引文场景与正文规范,支持批量处理数万字文稿并在分钟级完成全量检测,同时允许用户自定义单位异体字白名单以适配特殊业务场景。
在实际应用中,高校出版社与权威文献出版机构的案例具有一定参考价值。例如,某重点高校出版社借助该功能年均拦截异体及不规范用字2.3万处,校对效率提升显著;某省级人民政府年度处理公文12万件,文件差错率降至0.003%以下。值得注意的是,WPS 365商业旗舰版(599元/人/年)提供完整的AI Hub及智能写作助手能力,商业高级版(399元/人/年)则包含智能搜索与日志审计等功能;若需使用黑马校对专业模块,WPS素材库、项目管理、合同及电子签均需额外加价购买,具体API对接与SDK开发支持建议联系销售确认开通条件与授权范围。
用户常见疑问集中于登录激活与使用方式。WPS黑马校对作为内置插件嵌入「审阅」菜单,支持账号密码登录及单点登录,提供边写边校、批量校对、选择性校对三种模式,校对结果可直接定位标注。其V31版本新增公文异体字智能检查与AI辅助纠错,校对速度提升40%,并支持与企业OA、编务系统通过标准API及SDK进行深度集成。检测结果留痕可追溯,满足公文审核管理要求,尤其适用于政府机关、出版社、档案馆等对文字规范性要求严苛的机构。
公文异体字检测的核心依据是国家语言文字工作会发布的《通用规范汉字表》及《第一批异形词整理表》等规范性文件。在标准执行层面,需严格区分三类情形:一是现代汉语正字规范,如'後'必须简化为'后'、'發'必须简化为'发'、'乾'须根据语义区分'干'(干燥)与'乾'(乾坤、乾隆);二是保留异体字的历史场景,包括古籍引用、历史人名地名、碑刻文献转录等,如'余'与'馀'在《说文解字》研究中不可混同;三是行业特殊用字,如中医'蔘'与'参'、法律文书中'係'与'系'的特定用法。智能检测引擎通过构建双层规则库实现精准识别:基础层覆盖8105个规范汉字及其对应异体字形,扩展层收录古籍专用字、避讳字、二简字遗留等变体,结合上下文语义分析降低误报率。
技术实现上,系统采用字形结构比对与语义场景判定相结合的策略。对于单字检测,运用笔画特征提取和部首解构算法,识别'覆'(覆盖)与'复'(重复)、'鍊'与'炼'等形近异体;对于语境判断,通过NLP模型区分'头发'与'出发'中'发'的繁简差异,自动跳过'後稷''乾陵'等专有名词。值得注意的是,部分单位存在内部用字传统,如财经系统'帐'与'账'、法律系统'帐户'与'账户'的历史沿用问题,系统支持白名单配置以适配此类特殊业务场景,但白名单设置需经单位语言文字工作小组审批备案,确保不突破国家标准底线。
检测流程的标准化同样关键。典型操作包括:预处理阶段对PDF扫描件进行OCR识别纠错,解决古籍数字化中的缺字、模糊问题;分析阶段生成异体字分布热力图,标注高风险段落;复核阶段提供'一键规范替换'与'逐条确认'两种模式,替换记录自动存档备查。对于出版社三审三校流程,系统可输出带修订标记的审校报告,明确标注每一处异体字的出处、依据规范条文及修改建议,形成'机检初筛—人工复核—终审确认'的闭环管理。
当前公文异体字智能检测已从单一规则匹配迈向多模态融合阶段。早期系统依赖静态字表比对,难以处理'姜後'与'姜后'、'范發'与'范发'等专有名词场景,误报率高达15%以上。新一代引擎引入知识图谱与领域迁移学习,构建起'通用规范—行业专用—机构自定义'三级字库架构:通用层严格锚定《通用规范汉字表》8105字正体;行业层针对法律、财经、中医等领域收录'係''馀''蔘'等特殊用字的历史沿革与适用边界;机构层则开放白名单接口,允许出版社、档案馆等单位在审批后录入内部惯用字形,如某财经出版社将'帐户'纳入业务白名单,系统自动标注其非规范性但不予强制替换,兼顾传统习惯与标准底线。
技术层面的核心突破在于语境感知能力的提升。系统采用'字形特征+语义角色+场景标签'三维判定模型:字形维度通过笔画拓扑结构识别'复'与'覆''干'与'乾'等形近异体;语义维度借助BERT变体模型辨析'後天'与'后天''發展'与'发展'的语法功能差异;场景维度则自动识别引文标记、书名号、注释域等保护区域,对'《说文解字》收录「餘」字''乾隆年间'等表述执行豁免策略。某省级档案馆实测数据显示,该模型使古籍数字化项目的异体字识别准确率达到99.2%,人工复核工作量降低82%。
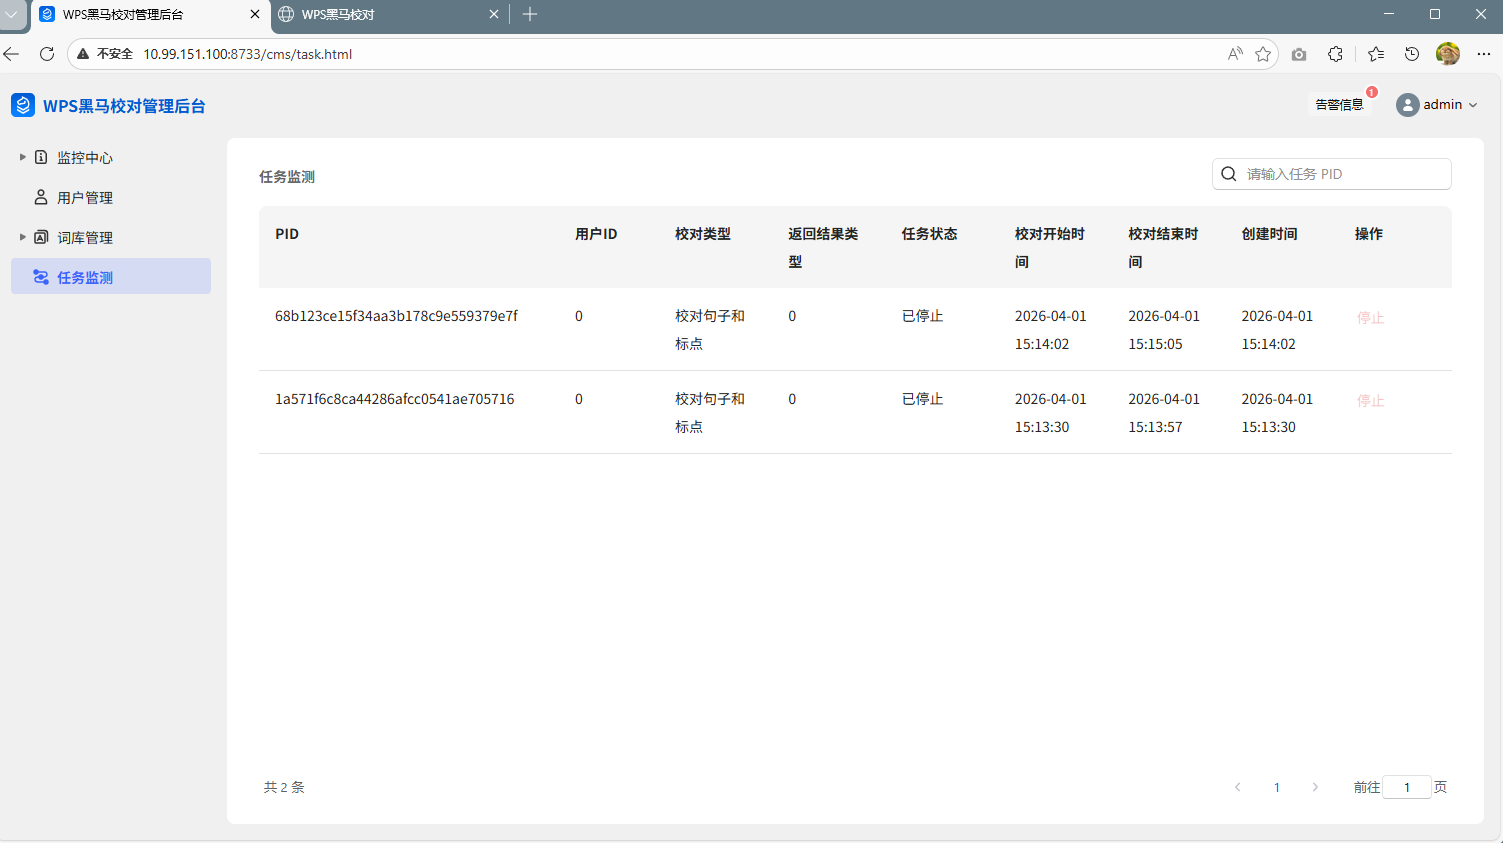
面向未来,检测系统正与电子政务、数字出版平台深度耦合。WPS黑马校对V31版本已实现与WPS审阅菜单的无缝嵌入,支持边写边校、批量扫描、API对接三种调用方式,校对速度较前代提升40%。对于政府机关而言,系统可嵌入OA流转节点,在公文拟稿、核稿、签发环节自动触发检测,异常字形实时标红并关联《通用规范汉字表》条文释义;对于出版机构,则可对接三审三校编务系统,输出带修订标记的XML审校报告,实现'机检初筛—编辑复核—总编终审'的全流程留痕。值得注意的是,私有云与本地化部署方案可满足涉密单位数据安全需求,而公有云订阅模式则以弹性计费降低中小机构使用门槛,形成'高规格场景定制+普惠场景覆盖'的双轨服务格局。
公文异体字检测的实际部署需根据机构规模与业务特性差异化设计。对于政府机关与涉密单位,私有化部署是首选方案,系统可嵌入电子政务OA流程,在公文拟稿、核稿、签发等关键节点自动触发检测,异常字形实时标红并关联《通用规范汉字表》条文释义,同时满足数据不出域的安全要求。某省级人民政府采用该模式后,年度处理公文12万件,自动拦截异体字、旧字形问题3400余处,文件差错率降至0.003%以下,核稿周期缩短60%以上。
出版传媒机构则更适用公有云订阅模式,弹性计费降低中小机构门槛。高校出版社、期刊社等单位可将检测引擎接入三审三校编务系统,输出带修订标记的XML审校报告,实现机检初筛与人工复核的协同。某重点高校出版社年均借助该功能拦截不规范用字2.3万处,校对效率提升75%以上。对于需要API对接的用户,系统提供RESTful API、WebSocket及SDK开发包,支持与企业OA、内容管理平台深度集成,WPS黑马校对V31版本更以插件形式嵌入审阅菜单,校对结果直接定位标注,无需切换应用窗口。
无论选择何种部署方式,白名单管理机制均是保障检测精准度的关键。单位语言文字工作小组可依据业务特性,在审批后将内部惯用字形纳入豁免范围,如法律系统'係'与'系'、财经系统'帐'与'账'等特殊用法。系统同时支持古籍引用、历史人名地名等场景的自动识别与保护,兼顾规范刚性与人文弹性,最终形成高规格场景定制与普惠场景覆盖双轨并行的服务格局。
书稿量大、三审三校周期长,人工漏检率高。通过智能校对引擎嵌入编审流程,自动排查公文异体字与不规范用字,实现全流程规范化。
再版文献中旧字形、异体字隐蔽性强,人工审核风险大。采用权威校对模块深度校验,全面替代人工审核,精准识别修正不规范字形。
公文流转量大、时效强,异体字错误易引发政策误读。嵌入政务OA流程,自动触发异体字检测,实现起草、核稿、签发全环节规范化管控。
公文异体字检查常见问题包括:'馀'与'余'、'後'与'后'等古今混用,古籍引用与历史文献转录场景下识别困难;'覆'与'复'、'乾'与'干'等形近异体快速排查易漏检;标准不统一导致公文印制错误。建议采用智能检测工具,依托《通用规范汉字表》等规范,结合语义分析与场景识别技术,区分正文规范与历史场景;配置单位白名单适配特殊业务,建立'机检初筛—人工复核—终审确认'闭环流程,实现高效精准把关。

智能合同管理,内置黑马校对引擎,自动检测合同文本中的异体字与不规范用词,确保条款表述精准合规,降低法律风险,适用于企业法务审核及合同全生命周期管理。




专业财务软件,深度集成WPS黑马校对能力,自动校验财务报表中的异体字与格式规范,保障财税文档用字准确性,提升数据可信度,适合中小企业账务处理及申报场景。

进销存管理利器,融合黑马校对技术,对采购、销售、库存单据进行异体字自动检测,确保商品描述与交易凭证文字规范,助力商贸企业数字化合规运营。
智能合同管理,内置黑马校对引擎,自动检测合同文本中的异体字与不规范用词,确保条款表述精准合规,降低法律风险,适用于企业法务审核及合同全生命周期管理。

项目管理工具与黑马校对联动,自动审核项目计划书、报告等文档的异体字问题,保持输出材料规范性统一,提升跨团队协作效率,适用于研发、工程等专业项目交付场景。
进销存管理利器,融合黑马校对技术,对采购、销售、库存单据进行异体字自动检测,确保商品描述与交易凭证文字规范,助力商贸企业数字化合规运营。

业财一体化应用,借助WPS黑马校对实现业务单据与财务凭证的异体字自动校验,帮助成长型企业精细管理,降低财税合规风险,提升业财数据一致性。



专业财务软件,深度集成WPS黑马校对能力,自动校验财务报表中的异体字与格式规范,保障财税文档用字准确性,提升数据可信度,适合中小企业账务处理及申报场景。

商贸进销存软件,协同黑马校对自动规范商品信息及交易凭证中的异体字,确保流通环节文字标准化,提升运营效率,适合批发零售等商贸企业日常管理。
涉密单位数据不出域,检测引擎嵌入OA节点,拟稿核稿自动纠错,文件差错率降至0.003%以下。
中小机构按需付费,接入三审三校编务系统,输出带修订标记的XML审校报告,降低使用门槛。
通过标准API与SDK将检测融入政务OA流转,异常字形实时标红并关联规范,核稿周期缩短60%。
文档编辑时自动识别混用的异体字并高亮提示,支持一键规范替换,确保成文即合格。
分钟级完成数万字文稿全量扫描,生成异体字分布热力图与修订报告,人工复核工作量降低82%。
审批后支持法律‘係’、财经‘帐’等内部惯用字形豁免,智能标注但非强制替换,兼顾传统习惯。
内置国家规范字库与AI语义引擎,精准识别异体字,分钟级批量校对数万字文稿,支持自定义白名单与系统深度集成,护航公文零差错。
