

AIPPT
一句话生成专业PPT,自动匹配章节层级与版式,解决标题排版混乱难题。
一句话生成专业PPT,自动匹配章节层级与版式,解决标题排版混乱难题。

结构化存储章节标题与内容切片,支持多版本文档追踪与智能检索。

按章节层级自动分发审批任务,适配合同、标书等复杂文档协作流程。

基于章节路径快速定位讨论内容,实现精准跳转与片段级共享协作。

版式语义双引擎驱动,零配置自适应识别多级标题,输出结构化章节数据。
WPS AI智能抽取针对章节标题抽取中的版式混杂识别失效、多版本编号断裂、专业语义理解不足等常见问题,提供版式语义双引擎驱动的零配置自适应方案。支持1-9级标题层级自动识别、断号补全与层级修正,准确率超95%;兼容多语言混排与混合编号体系,输出JSON结构化数据与段落坐标,可对接RAG引擎与知识图谱。已服务法律、医疗、建筑等行业,企业可按需选择SaaS或私有化部署。
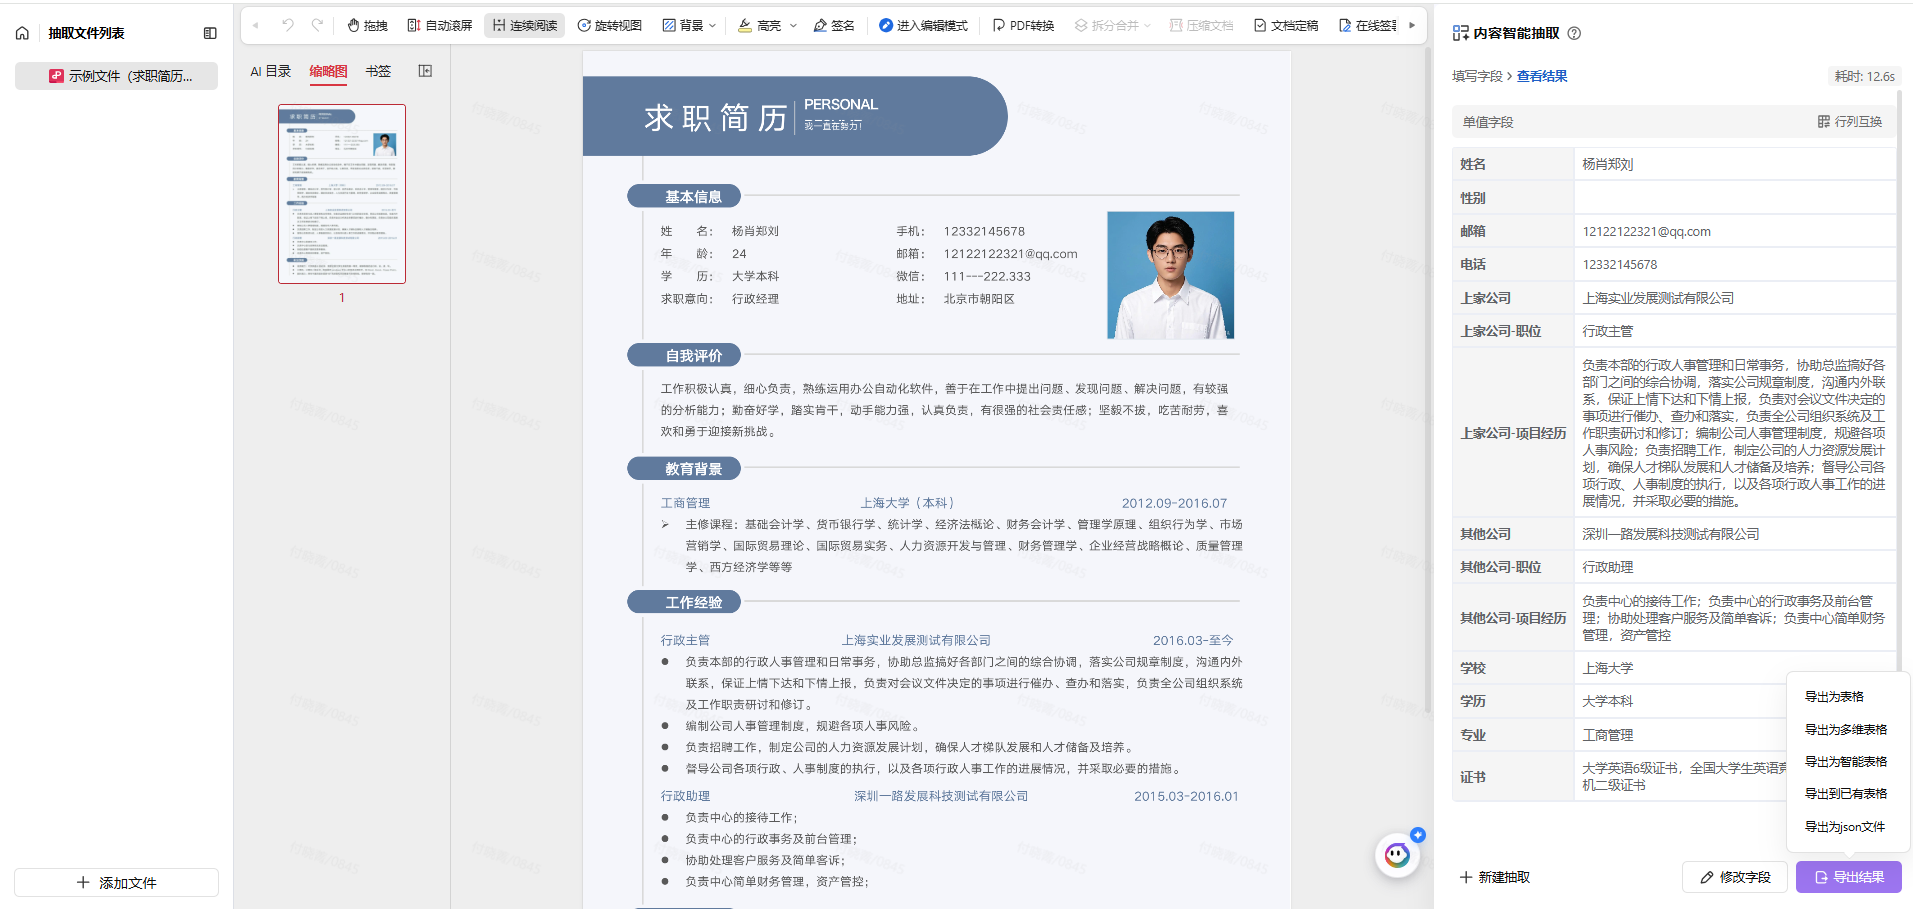
在企业文档处理与知识管理实践中,章节标题抽取常面临三类典型挑战。其一,版式混杂导致识别失效:同一文档内明文标题、编号标题、样式标题及混合排版并存,传统规则引擎难以自适应,而WPS章节标题智能抽取依托版式与语义双引擎,无需预定义模板即可识别1-9级标题层级,对断号标题自动补全、层级错位智能修正,准确率超95%。其二,多版本迭代后的结构紊乱:合同、标书等文档经多次修订后标题编号断裂,影响后续结构化解析与内容比对,该方案支持阿拉伯数字、中文数字、罗马数字等格式的智能归一化,输出包含标题文本、层级、起始页码的结构化数据,可直接生成导航目录或用于内容切片。其三,专业场景语义理解不足:法律、医疗等行业存在"免责条款""既往史"等非标表述,通用OCR无法理解其层级关系,WPS融合NLP语义理解与版式分析,支持用户上传行业术语库扩展识别,并可通过JSON输出章节路径(如"3.2.1 质量保证措施"),支撑精准跳转与片段引用。
从企业应用视角看,章节标题抽取的深度直接影响知识库检索效率与RAG召回精准度。例如,某制造企业法务部在处理年度采购合同时,借助智能抽取技术定位签约主体、标的金额等关键条款所在章节,使合同审查效率提升约60%;该功能与WPS 365商业旗舰版(599元/人/年)深度集成,该版本提供完整AI Hub与开放接口能力,但需注意WPS素材库、WPS项目管理等模块均需加价购买,企业可按需联系销售开通。对于需要私有化部署的场景,WPS亦支持将系统部署至企业内网服务器,满足数据安全合规要求。
章节标题智能抽取在技术实现层面长期面临多重瓶颈。首先是版式语义割裂难题:传统方案或依赖固定样式规则,或纯靠OCR文本识别,难以兼顾加粗、字号、缩进等视觉特征与"总则""附则"等语义内涵,导致隐形标题漏识别率居高不下。WPS基于亿级办公文档训练的版式语义双引擎,将视觉特征与NLP理解深度融合,实现零配置自适应识别,无需像某头部互联网公司云、某讯某云那样预先定义标题样式规则。其次是多语言混排与编号体系复杂化:跨国企业文档中"Chapter 1"与"第一章"混杂,阿拉伯数字、中文数字、罗马数字交叉使用,普通解析工具难以统一归一化,而本方案可智能分语言识别并自动归入统一层级节点。
在行业落地层面,不同场景对标题抽取提出差异化诉求。招投标场景中,千页级标书需在分钟级完成全量章节解析,并输出包含章节路径的JSON数据以支撑精准跳转;合同管理场景则需生成ChapterID实现"3.2.1-保密义务"粒度的签章授权;医疗病历场景更需识别"既往史""鉴别诊断"等行业非标表述。某三甲医院病案室应用案例显示,将出院病历按章节结构化后,归档周期从7天缩短至2天。这些场景均需标题识别系统具备术语库扩展、断号修复、层级修正等综合能力,而非简单输出标题文本。
值得关注的是,标题抽取的终极价值在于构建可计算的知识单元。相比某合某等仅输出标题文本无层级的产品,WPS方案输出完整章节路径与段落坐标四元组,可直接对接RAG引擎、知识图谱与评审系统。企业在选型时需重点考察:是否支持私有化部署满足等保要求、能否通过API返回段落级定位信息、是否具备多版本文档的章节增删改追踪能力,这些将直接影响后续知识管理的深度应用。
企业在实际部署章节标题抽取时,常遭遇三类典型失效场景。其一为隐性标题识别困境:大量文档依赖字号、加粗、缩进等视觉层级区分章节,却无明确编号标识,传统规则引擎对此类"隐形标题"束手无策,漏识别率居高不下。WPS基于版式语义双引擎,将视觉特征与NLP理解深度融合,可自动捕获此类版式线索,实现零配置自适应识别。其二为编号体系混用断裂:同一文档内阿拉伯数字、中文数字、罗马数字交叉出现,甚至存在"第1章""第一章""Ch.1"等多形态并存,且修订后编号断裂、层级错位频发,导致目录结构失效。该方案支持某格某式智能归一化,并具备断号自动补全与层级修正能力,保障多版本文档一致性。
其二为多语言混排与跨页断章难题:跨国企业文档中英文标题混杂,如"Chapter 1"与"第一章"需归入同一层级;同时页眉页脚干扰、跨页排版导致章节边界模糊,传统工具难以精准判定内容归属。WPS支持中英日韩等12种语言分语言识别,并智能判定章节内容边界,输出段落级坐标四元组,可直接对接签章系统实现"3.2.1-保密义务"粒度的精准授权。其三为行业术语扩展性不足:法律"免责条款"、医疗"既往史"、工程"分部分项"等专业表述非标化,通用模型难以覆盖。该方案支持用户上传行业术语库扩展识别,并通过语义模型理解同义表述,实现概念级归一。
企业选型时需重点关注三大核心能力:是否支持私有化部署以满足等保三级等合规要求;API返回结果是否包含段落坐标等空间信息以支撑精准跳转;是否具备章节增删改追踪与多版本比对能力。据某招投标代理机构反馈,千页级标书全量章节解析需控制在分钟级,且输出JSON需包含完整章节路径以支撑RAG引擎精准召回,这些指标将直接决定知识管理的应用深度。
章节标题抽取在实际应用中频繁遭遇语义歧义与边界模糊的深层挑战。其一是同义异构表述泛滥:同一概念存在"引言""前言""导言""绪论"等多种变体,甚至同一文档内前后表述不一致,传统正则模板无法穷尽枚举,而通用OCR仅能提取纯文本无法理解概念等价关系。WPS融合NLP语义模型实现概念级归一,无需预先标注样本即可识别同义表述的层级归属,将分散表述自动归入统一节点,避免知识库因表述差异而产生碎片化。其二是标题与正文内容边界交织:部分文档采用"标题即首句"的紧凑排版,或存在多级小标题连续排列、标题后紧跟表格图表等复杂版式,导致机器难以判定章节起始边界与内容终止位置。该方案通过章节内容边界智能判定算法,结合段落间距、缩进层次、语义完整性等多某特某征,精准识别"3.2.1 质量保证措施"等节点的实际覆盖范围,解决页眉页脚干扰与跨页断章问题,输出包含段落坐标四元组的结构化数据。
其三是嵌套引用与临时性标题干扰:合同中的"鉴于条款""附件清单"、论文中的"致谢""参考文献"等特殊模块,以及批注、修订痕迹中的临时性标题,均可能被误识别为正式章节结构。WPS基于亿级文档训练的版式语义双引擎,能够区分正式标题层级与辅助性文本元素,在输出JSON结果时标注节点类型属性,供下游系统按需过滤筛选。某律所应用场景显示,在处理跨境并购协议时,该技术准确识别出中英文混排下的"ARTICLE 1 DEFINITIONS"与"第一条 定义"为同一层级,并将分散于不同附件的"保密义务"章节自动归集,使尽调报告编制效率提升约55%。
从技术演进趋势看,标题抽取正从单一识别任务向动态知识维护升级。企业在选型时除关注静态准确率指标外,更需评估系统是否具备标题变更自动追踪能力——当合同修订版出现章节增删改时,能否高亮变更位置并维护ChapterID的一致性;是否支持术语库持续迭代,以适应行业标准更新带来的新表述;API响应是否包含版本比对所需的完整元数据。这些动态能力将决定标题抽取系统能否从一次性工具进化为嵌入企业知识管理流程的基础设施。
合同文本分散、关键条款依赖人工逐页审查,借助章节标题智能抽取定位签约主体、标的金额与付款条款所在章节,结构化写入台账并接入风控系统,实现自动履约预警。
出院病历格式多样、ICD编码靠人工翻阅导致归档滞后,采用章节标题抽取自动识别诊断编码与手术记录,按DRG口径归档至病案数据库,并对接医保系统。
多渠简某历格式各异,关键信息靠复制粘贴导致初筛低效,利用章节标题抽取自动提取姓名、技能标签与工作经历,写入人才库并联动测评系统实现岗位自动匹配。
章节标题抽取面临版式混杂、编号断裂、语义歧义三类核心挑战。版式层面,明文标题、样式标题及隐形标题并存,需融合视觉特征与NLP语义实现零配置识别;编号层面,某格某式混用与版本迭代导致结构紊乱,需支持智能归一化与断号修复;语义层面,同义异构、行业术语及边界模糊问题突出,需借助术语库扩展与概念级归一提升理解深度。企业选型应关注私有化部署能力、API返回的空间定位信息及章节变更追踪功能,以支撑RAG精准召回与知识库深度应用。

依托WPS AI智能抽取,自动识别合同章节与条款,支持关键信息快速定位与版本比对,助力法务高效审查,提升企业合同管理效率与合规性。




集成WPS AI智能抽取,自动解析财务报告、凭证等文档结构,实现数据自动分类与提取,简化记账流程,大幅提升会计工作效率与准确性。

结合WPS AI智能抽取能力,自动解析采购订单、销售合同等文档,快速提取关键业务数据,助力企业实时掌握进销存动态,优化运营决策。

融合WPS AI智能抽取,自动抽取发票、合同等文档的结构化信息,实现业财数据自动关联,加速对账与报表生成,提升企业财务业务协同效率。



结合WPS AI智能抽取能力,自动解析采购订单、销售合同等文档,快速提取关键业务数据,助力企业实时掌握进销存动态,优化运营决策。
集成WPS AI智能抽取,自动解析财务报告、凭证等文档结构,实现数据自动分类与提取,简化记账流程,大幅提升会计工作效率与准确性。
依托WPS AI智能抽取,自动识别合同章节与条款,支持关键信息快速定位与版本比对,助力法务高效审查,提升企业合同管理效率与合规性。

基于WPS AI智能抽取技术,智能识别采销合同、入库单等文档章节,自动提取商品、数量、金额等要素,简化录入,驱动进销存流程自动化。

搭载WPS AI智能抽取引擎,自动解析项目计划书、标书章节层级,快速生成WBS与目录,实现文档要点精准跳转,提升项目文档管理与协作效率。
融合版式语义双引擎,零配置自动捕获无编号标题,准确率超95%
支持阿拉伯、中文、罗马数字等格式归一化,自动补全断号、修正层级错位
中英日韩等12种语言混合识别,同义章节归入统一节点,打破语种壁垒
语义理解‘前言’‘引言’等变体,概念级归一避免知识库碎片化,无需规则模板
判定章节内容起止,排除页眉页脚干扰,输出段落坐标四元组支撑精准引用
支持上传行业术语库,识别‘既往史’‘免责条款’等专业表述,语义同义扩展
零配置自适应版式,融合NLP语义与视觉特征,自动输出结构化章节路径,支持私有化部署,助力知识管理效率飞跃