

WPS 协作
支持红头文件在线协同编辑与批量处理,团队成员实时同步,提升公文流转效率。
支持红头文件在线协同编辑与批量处理,团队成员实时同步,提升公文流转效率。

智能识别红头字号版式结构,自动解析文号、日期等关键字段,生成结构化数据。

精准定位PDF扫描件中的红头区域,解决版式混杂、印章遮挡等OCR识别难题。

一键生成红头文件标准模板,自动适配不同层级机关的版式规范要求。

批量异步抽取50份500页红头字号,输出JSON结构化结果,附置信度与坐标。
红头字号抽取常见格式不统一、文号嵌套混乱、日期混淆等问题。WPS AI智能抽取基于GB/T 9704标准,通过版面布局定位与语义理解,支持PDF/图片/扫描件批量处理,单次50份500页,输出JSON结构化数据,适用于政务档案、央企合规、金融监管、科研管理等场景,实现发文字号精准识别与溯源。
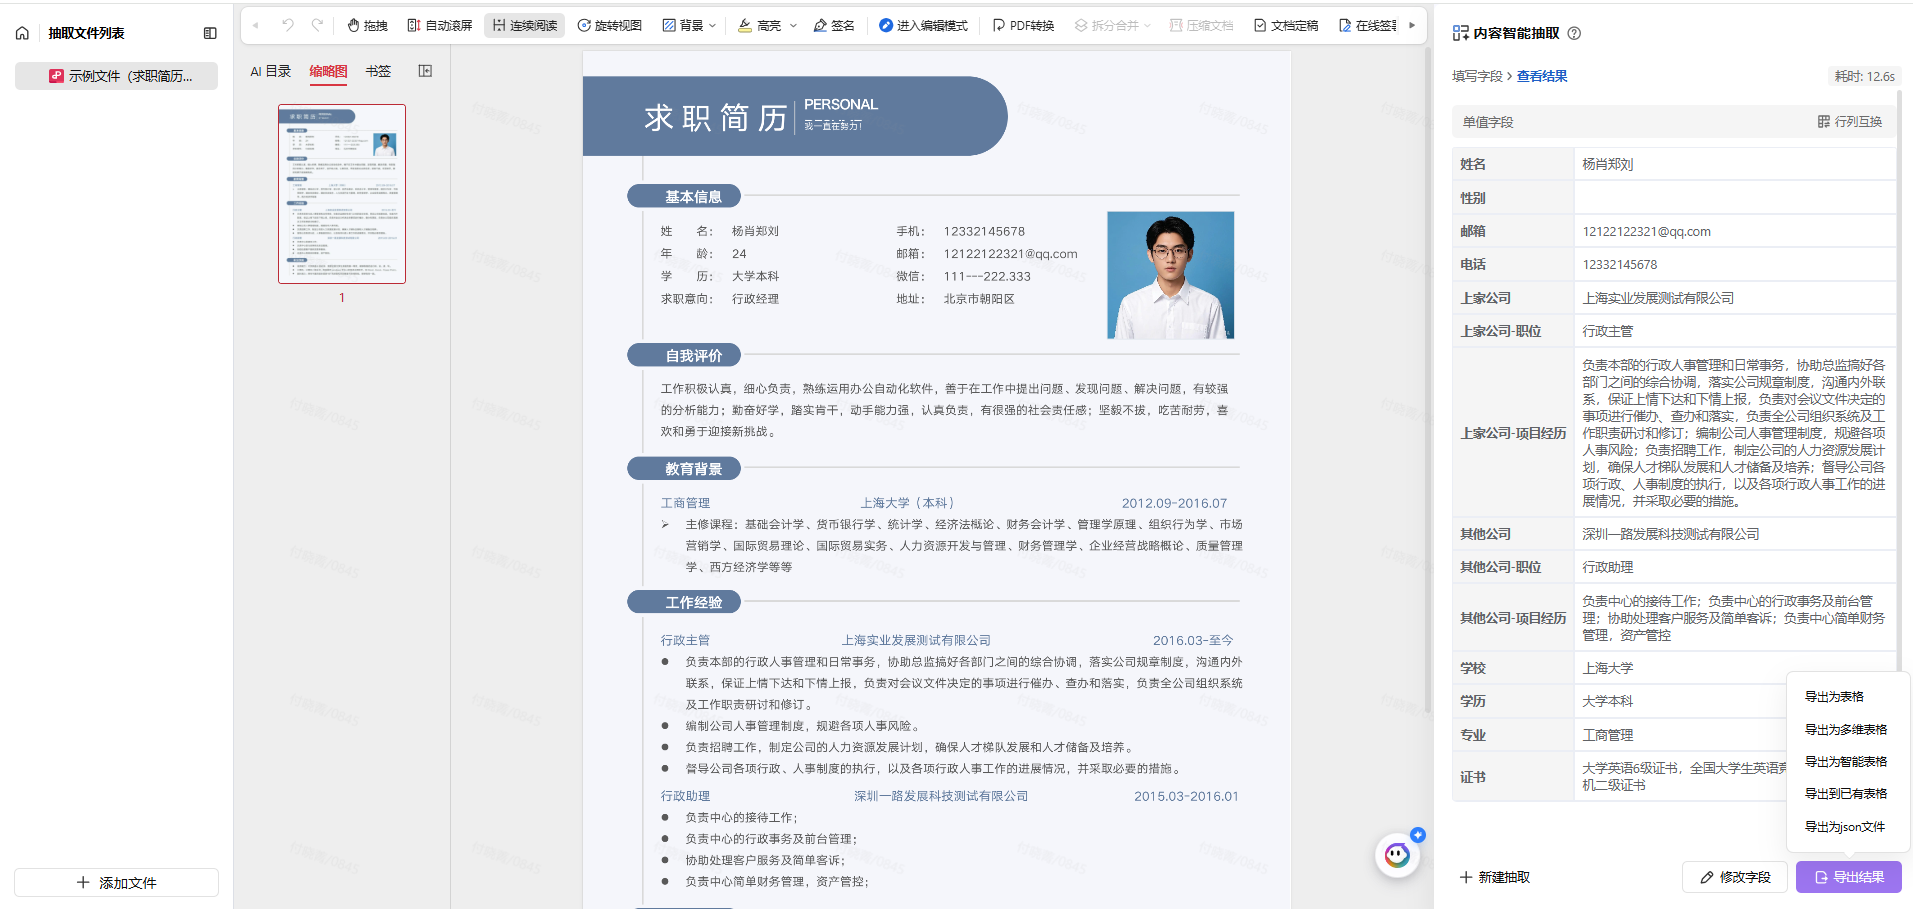
红头字号抽取在实际应用中常面临文件格式混杂与版式差异带来的识别难题。由于红头文件载体涵盖扫描件、PDF、图片等多种形态,且红头样式多样,传统OCR往往难以精准定位字号区域,尤其是发文机关标志与字号字段颜色、字体相近时,极易发生误识别。文档智能解析功能通过按版面布局定位红头区域,可有效区分发文机关标志与字号字段,避免正文干扰,单次支持最多50份、500页的批量异步处理,并将结果以JSON结构化数据返回,包含字段名称、置信度及坐标信息,便于后续系统集成。
在政务与企业场景中,字号格式不统一、文号嵌套混乱、生效日期与印发日期混淆等问题尤为突出。例如政府档案管理场景下,文件生效日期与印发机关的误识别会直接影响档案检索与效力认定;央企合规场景中,二级单位转发集团文件时字号嵌套混乱,易导致制度溯源困难。针对此类痛点,建议结合公文要素智能校验功能,基于标准建立字段映射规则,区分印发日期与成文日期,并自动归集主送抄送机关,输出符合档案管理规范的结构化数据。
需要注意的是,文档智能解析功能的具体接入方式与额度可能因企业所选WPS 365套餐而有所不同。该功能主要面向商业高级版及商业旗舰版用户,其中商业高级版(399元/人/年)提供文档安全与企业管控、智能搜索等能力,商业旗舰版(599元/人/年)则进一步开放完整AI Hub及开放接口能力,适合有大规模文档解析与系统集成需求的企业。若涉及超批量处理或本地化部署需求,建议联系商务扩容或咨询私有化部署方案。
红头字号抽取在实际业务中常遭遇版式适配与字段混淆的双重挑战。一方面,红头文件的发文机关标志与字号字段在颜色、字体上高度相近,传统OCR难以精准切分,极易将机关标志误识为字号或将正文内容混入提取结果;另一方面,文件生效日期与印发日期、主送机关与抄送机关的边界模糊,导致归档时效力认定困难。针对此类痛点,需依托版面布局解析技术,按红头区域的空间位置关系锁定字号字段,而非依赖单一字符特征匹配,从而有效隔绝正文干扰,提升识别精度。
在文号嵌套与多源混排场景中,问题更为复杂。央企集团转发文件时,原文号与转发文号交织,若无血缘关系解析能力,制度溯源将陷入断裂;金融机构处理监管来文时,外部原始字号与内部流转编号混排,合规响应极易遗漏关键要求。对此,建议建立字段映射规则与双向索引机制,自动区分外部机关代字与内部编号,并基于GB/T 9704等标准输出结构化记录,确保文号链条完整可溯。
为适配高并发与大批量处理需求,字号抽取服务采用异步解耦架构,单次任务可承载50份、500页文件的批量提交,返回JSON格式结果并附带置信度与坐标信息,便于复核校验与系统对接。用户还可依据业务场景灵活配置抽取字段,包括基础字段、组字段及多层级嵌套字段,满足政务归档、合规审计、科研管理等多元化需求。对于数据敏感型机构,私有化部署方案可保障数据不出域,兼顾效率与安全。
红头字号抽取的核心瓶颈在于版式复杂性与语义关联性的双重叠加。从技术层面看,红头文件并非标准化版式,不同层级机关、不同时期的文件在字号位置、字体大小、颜色深浅上存在显著差异,部分历史文件还存在红头褪色、扫描畸变、印章遮挡等质量问题,导致传统基于模板匹配的OCR方案失效。更棘手的是,字号字段本身具有强语义特征——如"某政发〔2023〕15号"中的机关代字、年份、顺序号需拆分后才能被业务系统识别,而相邻的密级标识、紧急程度等字段又极易与字号混淆,形成干扰。
智能化解析的关键突破在于从"字符识别"转向"版式理解"。文档智能解析通过深度学习版面分析模型,先识别红头区域的视觉锚点(如红色分割线、五角星、机关标志),再依据GB/T 9704标准规定的空间拓扑关系定位字号字段,实现像素级精准切分。同时引入多模态融合策略,结合颜色通道分离、字体特征编码与上下文语义推断,有效区分发文机关标志与字号字段,即使面对彩色扫描件中红头与黑字交织的复杂场景,仍能保持高准确率。
在实际部署中,异步处理架构与结果溯源机制进一步保障了可用性。单次50份、500页的批量处理能力适配了档案馆、集团企业的大并发需求,JSON结构化输出中的坐标信息与置信度评分,使业务人员可快速定位原文位置进行人工复核。对于涉密场景,私有化部署方案确保数据不出域,兼顾了政务与金融行业的安全合规要求。
红头字号抽取面临的深层挑战在于语义层面的多义性与关联复杂性。同一文件体系中,字号字段往往与其他关键信息存在紧密的逻辑耦合,如联合发文场景下多个机关代字的效力排序、转发文件中原文号与转发文号的层级嵌套、科研项目中期变更字号与立项字号的从属关联等。这些语义关系无法通过单纯的字符识别获知,而传统OCR仅能输出扁平化文本,难以构建字段间的结构化关联,导致业务系统无法直接调用。
更复杂的是,红头文件中存在大量隐性管理要素与字号字段交织分布。例如密级标识、紧急程度、传达范围等信息常与字号同处版头区域,颜色与字号高度相似;印发日期与成文日期在部分文件中采用相同字体排版,仅靠位置微调区分。若缺乏对公文语义的深度理解,极易将这些字段与字号混为一谈,或遗漏关键限定条件。文档智能解析通过构建GB/T 9704标准知识图谱,将版面空间位置与公文语义规则相结合,自动判别字段属性并建立关联索引,实现从"识别文字"到"理解文档"的跨越。
针对批量处理场景,智能抽取服务提供可配置的多层级嵌套字段能力,支持用户按业务需求定义字号拆解规则、关联字段映射及输出模板。单次50份、500页的异步任务处理能力,配合JSON结构化结果中的置信度评分与坐标溯源信息,使大规模档案数字化与制度合规审查得以高效落地。对于数据敏感型机构,私有化部署方案确保解析过程完全在本地完成,满足政务、金融等行业对数据主权与合规安全的严格要求。
针对积存三十年红头档案字号格式混杂、生效日期与印发日期易混淆等难题,利用红头文件智能解析自动提取发文字号与机关标志,并基于 GB/T 9704 标准区分成文日期,生成规范目录数据库。
二级单位转发文件时原文号与转发文号关联断裂,制度溯源困难。通过文号血缘关系解析自动建立转发字号与原始字号的关联图谱,补全印发层级等隐性管理要素,消除版本管理黑洞。
监管来文与内部字号混排,外部原始文号溯源效率低下,密级标识识别不准。采用内外文号双轨识别建立双向索引,联动抽取密级与公开属性,自动化隔离涉密内容,确保合规响应准确可溯。
红头字号抽取常见问题涵盖技术识别、字段配置与部署接入三类。技术层面,发文机关标志与字号字段因颜色字体相近易混淆,生效日期与印发日期、主送抄送机关边界模糊,需依托版面布局解析与GB/T 9704标准语义规则精准区分;字段配置方面,支持用户自定义基础字段、组字段及多层级嵌套字段,可灵活适配文号血缘关联、联合发文排序等复杂场景。部署层面,单次任务支持50份、500页异步批量处理,返回JSON结构化数据含置信度与坐标信息;敏感机构可选私有化部署保障数据不出域。建议结合公文要素智能校验功能建立字段映射规则,并依据业务规模选择API、SDK或本地化接入方案。

集成AI智能抽取能力,自动识别合同甲乙方、金额、期限等关键字段,支持批量处理与JSON结构化输出,提升合同审查与归档效率。




利用文档智能解析自动提取项目文件字号、日期、责任人等要素,支持多份批量处理,辅助进度追踪与合规校验。

通过AI抽取技术自动识别采购单、销售单商品、数量与金额,支持批量上传与结构化录入,实现库存快速同步与追溯。

集成文档智能解析,精准识别发票、凭证关键字段,支持批量处理与合规归档,助力业财一体化与数字化转型。




支持凭证、报表等财务文档智能抽取与自动分类,按版面精准识别,减少人工录入错误,提升记账报税效率。

通过AI智能抽取自动提取进货单、销售单商品明细与金额,支持批量解析与结构化输出,实现生意数据快速录入分析。
集成AI智能抽取能力,自动识别合同甲乙方、金额、期限等关键字段,支持批量处理与JSON结构化输出,提升合同审查与归档效率。
通过AI抽取技术自动识别采购单、销售单商品、数量与金额,支持批量上传与结构化录入,实现库存快速同步与追溯。
利用文档智能解析自动提取项目文件字号、日期、责任人等要素,支持多份批量处理,辅助进度追踪与合规校验。
基于版面解析精准定位红头字号字段,自动区分发文机关标志,输出结构化字号与日期,符合档案管理规范。
快速抽取合同红头字号,比对发文机关与生效日期,防止篡改与效力争议,提升合规审查效率。
嵌入OA系统,批量解析上传的红头文件,自动提取字号、主送等要素并回写表单,减少人工录入错误。
应对扫描畸变、红头褪色等质量问题,按版式理解定位字号,支持批量50份/500页抽取与溯源复核。
区分监管来文原始字号与内部流转编号,建立双向索引,防止合规响应遗漏关键要求,保障审查完整。
解析转发文件文号嵌套关系,构建原文号与转发文号血缘链,自动归集层级关联,提升制度管理能力。
融合版面理解与语义关联,精准区分机关标志、字号及日期,批量50份异步处理,输出JSON结构化结果,适配政务档案与合规审计。