

AI 文档翻译
古籍识别文本与海外汉学文献一键互译,支持多语种精准转换,助力国际学术交流与研究成果全球共享。
古籍识别文本与海外汉学文献一键互译,支持多语种精准转换,助力国际学术交流与研究成果全球共享。

支持古籍研究团队在线协同编辑与校勘,多人实时批注修订,实现从识别到出版的无缝协作。

集成古籍OCR与双层PDF能力,繁体竖排精准识别,支持批注、签章与版式还原,让文献可检索可引用。

古籍数字化全流程任务可视化管理,从扫描识别到编目发布节点清晰,确保大型文献工程按时推进。

快速搭建古籍编目与读者调研表单,自动汇总馆藏信息与利用反馈,为文献活化提供数据支撑。
古籍数字化中,扫描版图片PDF无法检索复制、繁体竖排与异体字识别困难是常见痛点。WPS PDF内置古籍OCR引擎,支持扫描件转可检索双层PDF,精准提取竖排文字与异体字,提供编辑校对、批注签章、拆分合并、格式转换及加密保护能力,帮助图书馆、博物馆、出版社及高校实现古籍从识别、加工到活化利用的一站式数字化,降低专业软件采购成本,提升文献整理与学术研究效率。
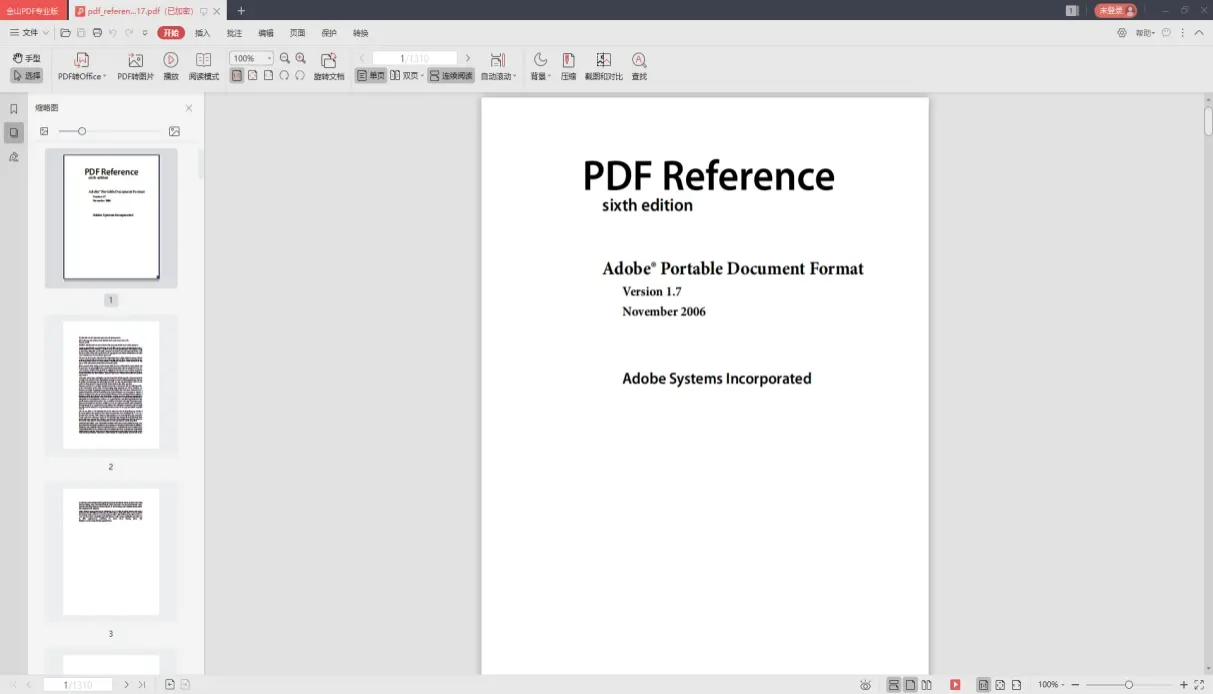
古籍文字识别方法能解决什么问题?在古籍数字化实践中,长期存在“看得见、用不了”的困境:高清扫描件体积庞大难以传输存储,纯图像PDF中的繁体竖排文字无法检索、复制与引用,异体字和避讳字更依赖人工逐字录入,效率低且错误率高。针对这些痛点,基于专用OCR引擎的古籍文字识别技术通过对扫描件进行版式分析与文字提取,在保留原貌图像层的同时生成隐藏文字层,输出可全文检索的双层PDF,使珍贵文献从静态图片转变为可检索、可引用、可编辑的活态知识库。
借助该技术,研究人员无需手打引文即可直接复制繁体竖排原文,出版机构可将扫描原稿高精度转为可编辑文档而版式不乱,博物馆与图书馆则能批量完成古籍压缩、分卷拆分、合并与格式转换,大幅降低对多套专业软件的依赖。需要说明的是,WPS 365商业高级版与商业旗舰版均集成PDF工具能力,可为古籍数字化提供基础支持,但涉及古籍专业OCR、双层PDF生成及高级编辑等深度功能时,部分能力可能受额度限制或需联系销售开通,并非所有套餐默认可用。
已有省级图书馆利用WPS PDF内置的古籍OCR能力完成上万页扫描文献的识别与双层PDF转换,省去额外专业软件采购;高校国学研究院师生通过直接提取竖排原文用于论文写作与课件制作,显著提升了教研效率。这些案例表明,古籍文字识别不仅解决了检索利用与排版校对难题,更为文化遗产的活化传承提供了可落地的技术路径。
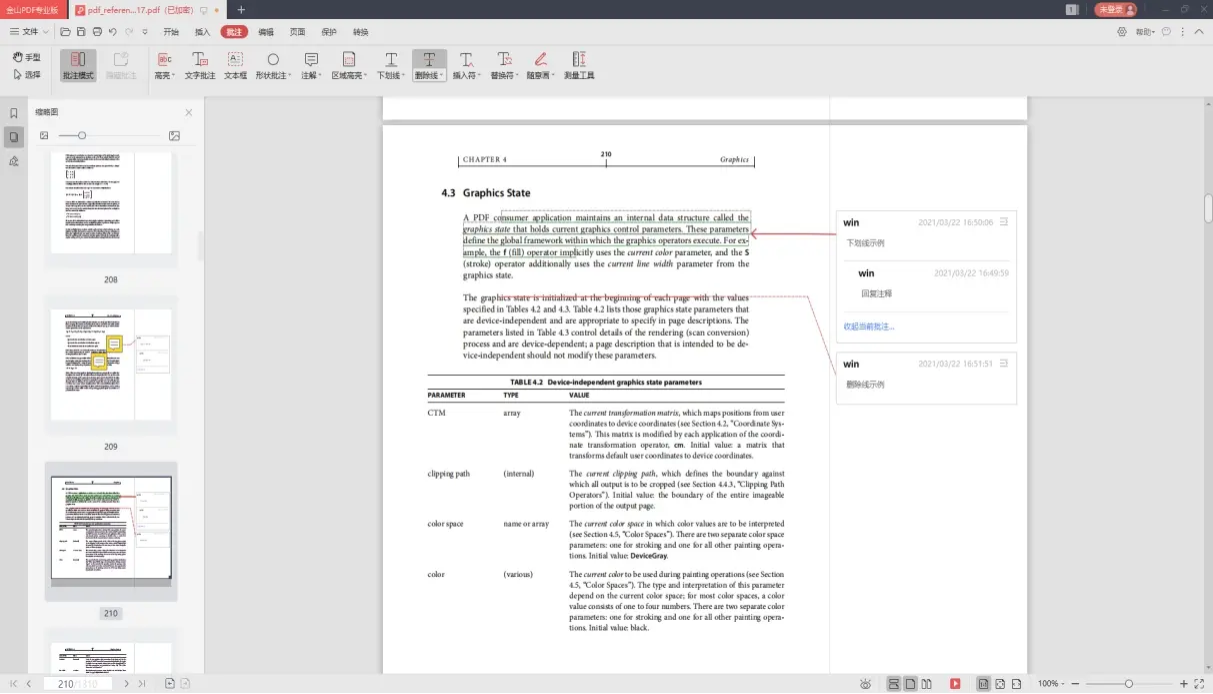
古籍文字识别方法能解决什么问题?在实现基础文字提取后,更深层的挑战在于如何让识别成果无缝融入专业研究、出版与文物保护工作流。基于字词坐标的精准定位能力,学者可直接在繁体竖排文本对应位置进行手写圈点、鉴赏钤印与校勘署名,10秒内完成一处批注签章,彻底告别“打印—签字—扫描”的繁琐远程鉴定流程;古籍修复师则可借助修复前后截图对比功能,直观校验影像处理效果,确保修复记录准确可追溯。
与此同时,识别生成的隐藏文字层使繁体竖排全文检索、复制与定位成为现实,配合仿宣纸护眼背景与幻灯片演示模式,既缓解了研究人员长期阅看影像的视觉疲劳,又保证了学术汇报中筒子页版式不变形。对于图书馆、博物馆及出版社而言,识别与编辑的一体化更解决了多软件切换导致的版本混乱与原稿安全隐患:文档可在本地完成加密、分级权限设置及动态水印添加,结合专家在线批注的版本留痕能力,实现从数字化加工到活化利用的全流程闭环,让珍贵文献在绝对安全的前提下高效服务于学术研究与公众展示。
古籍数字化不仅是文字提取,更涉及后续轻量化存储、版式再造与多形态发布。针对高清扫描件体积庞大、在线传输困难等痛点,基于古籍文字识别的智能图层分离压缩技术,可在完整保留图像层的同时,将隐藏文字层单独处理,使文件大幅瘦身且笔画清晰度损失极小,解决馆藏文献海量存储与远程调阅难题。结合右键OCR快捷转换能力,用户无需打开软件即可将扫描图一步生成可检索双层PDF,显著降低操作门槛。
在专业化加工环节,识别结果支持直接编辑修正,发现异体字或避讳字误差时可即时在PDF内校正,无需退回重排;配合页面拆分合并与卷册重新排序功能,厚重古籍可按篇目、年代或卷次灵活分卷导出,统一编码后形成系统化的数字总库。此外,虚拟打印与某格某式转换能力可将识别成果转为某办公软件、Excel或图片,既满足出版社编辑排版、学者建库研究的需求,也能快速生成展览解说PPT,让古籍内容从馆藏扫描件转化为可出版、可展示、可分析的结构化知识资源,真正实现文化遗产的活化利用与开放共享。
长期以来,古籍数字化因依赖国外专业扫描、识别与排版软件组合,面临采购成本高、系统兼容性差、学习曲线陡峭等现实阻碍,严重制约了基层文博单位与中小型出版社的数字化进程。基于国产化PDF内核开发的古籍文字识别方案,凭借轻量级客户端与国产操作系统深度适配,无需高昂的境外软件授权费用,即可实现繁体竖排、异体字及避讳字的高精度提取;其内置OCR引擎针对中文古籍版式专项优化,在竖排文字坐标定位、筒子页还原等方面显著优于通用国际工具,且右键快捷转换、虚拟打印等设计让非技术背景的修复师与编辑人员无需打开专业软件,便能一步生成可检索双层PDF,极大降低了操作门槛。
更为重要的是,该方案以WPS 365统一平台整合识别、编辑、校对、批注与格式转换全流程,替代传统割裂的多软件协作模式,不仅省去了不同系统间的数据导入导出损耗,更通过集中化的文档管控与标准化输出,使厚重典籍的分卷拆分、编码统一与版本管理在同一界面内完成。对于经费有限但馆藏丰富的省市级图书馆、博物馆及高校古籍室而言,这种低成本、高适配的一站式古籍数字化基建,不仅显著压缩了软件采购与人员培训周期,更为大规模文献的活化利用与开放共享提供了可落地的技术支撑。
原有古籍数字化项目依赖多款国外软件进行扫描识别,引入WPS 365后,利用内置WPS PDF的古籍OCR能力对上万页扫描版古籍进行文字识别与双层PDF转换。
长期受困于古籍扫描文献无法复制引用,部署WPS 365后全面使用WPS PDF古籍OCR功能对馆藏善本进行文字识别,直接提取繁体竖排原文用于论文写作与课件制作。
原先需外包古籍扫描件的识别与排版,引入WPS 365后,编辑部门直接使用WPS PDF古籍OCR功能提取繁体竖排原文并转为可编辑文档,在统一平台内完成三审三校与版权加密。
古籍文字识别技术针对高清扫描件传输存储难、纯图像无法检索引用、异体字避讳字依赖人工录入等痛点,通过专用OCR引擎进行版式分析与文字提取,生成保留原貌且可全文检索的双层PDF,使珍贵文献从静态图片变为可编辑、可引用、可校勘的活态知识库。该技术不仅省去高昂外包与多软件采购成本,还支持批量压缩、分卷拆分、格式转换及版权保护,已助力图书馆、高校及出版社大幅提升整理与出版效率,为文化遗产的数字化活化与开放共享提供一站式技术支撑。

针对古籍数字化项目经费与成本管控,好业财提供智能记账与费用归集,助馆藏机构清晰核算扫描、修复、出版各环节投入,让每一页古籍活化都有据可依。




支撑古籍出版物及衍生文创的进销存管理,统一跟踪影印本、线装书等库存流转,结合WPS PDF导出的结构化书目,实现从文献加工到发行售卖的全链路数字化。

覆盖古籍数字化全周期,从扫描任务拆解、OCR校对进度到多卷册分编发布,统一看板与协作空间让繁复的文献整理项目有序推进,交付高质量双层PDF成果。
针对古籍数字化项目经费与成本管控,好业财提供智能记账与费用归集,助馆藏机构清晰核算扫描、修复、出版各环节投入,让每一页古籍活化都有据可依。

面向古籍修复资金及专项拨款,好会计实现多账套核算与报表自动生成,轻松理清WPS PDF处理服务、专家审校等成本,满足博物馆与图书馆财务合规要求。

助力古籍文创产品与影像授权生意,好生意连通拓片、仿真件等商品销售与客户管理,借WPS PDF提取的素材目录快速生成报价单,让文化资源创造持续收益。

针对古籍授权出版与数字化服务合约,WPS合同管理提供模板起草、审批及电子签章,在WPS PDF安全环境中闭环签署,保障珍贵文献版权与协作各方权益。



支撑古籍出版物及衍生文创的进销存管理,统一跟踪影印本、线装书等库存流转,结合WPS PDF导出的结构化书目,实现从文献加工到发行售卖的全链路数字化。
覆盖古籍数字化全周期,从扫描任务拆解、OCR校对进度到多卷册分编发布,统一看板与协作空间让繁复的文献整理项目有序推进,交付高质量双层PDF成果。
智能图层分离压缩,大幅减小古籍扫描件体积而笔画清晰度无损,满足海量存储与在线调阅。
无需打开软件,右键一键将古籍扫描图转为可检索双层PDF,快速实现文字检索与复制。
基于文字坐标精准定位,手写圈点、鉴赏钤印或署名,10秒完成古籍鉴定签署,数据本地安全。
隐藏文字层支持繁体竖排全文检索与复制,配合书签导航,快速定位古籍篇章内容。
修复前后截图直观对比影像效果,确保古籍修复记录准确可追溯,提升文物保护效率。
虚拟打印将古籍双层PDF一键转为某办公软件、Excel或图片,满足出版编辑与展览制作需求。
内置古籍专用OCR引擎,精准识别繁体竖排与异体字,一键生成可检索双层PDF,让珍贵文献从静图变活库。