

WPS PDF
精准解析PDF扫描件中的复杂称谓格式,跨页关联不散乱,批量导出结构化数据。
精准解析PDF扫描件中的复杂称谓格式,跨页关联不散乱,批量导出结构化数据。

一键翻译中外文混排称谓,智能识别外籍姓氏前置格式,助力全球化人才库建设。

安全传输含敏感称谓的简历合同,双重鉴权保障金融政务数据不出域。

在线协作编辑称谓抽取模板,实时同步JSON/Excel结果,无缝对接CRM与OA系统。

智能生成desc描述规则与自然语言标注,自动配置单字段/组字段抽取逻辑。
针对称谓与实体混杂、中英文及少数民族复杂格式、多页跨页关联困难等痛点,WWO AI智能抽取提供单字段与组字段灵活配置、预置行业模板、OCR版式解析与跨页关联能力,支持JSON/Excel结构化导出,已落地金融、医疗、法律、互联网等多行业,助力企业称谓信息规范化回流。
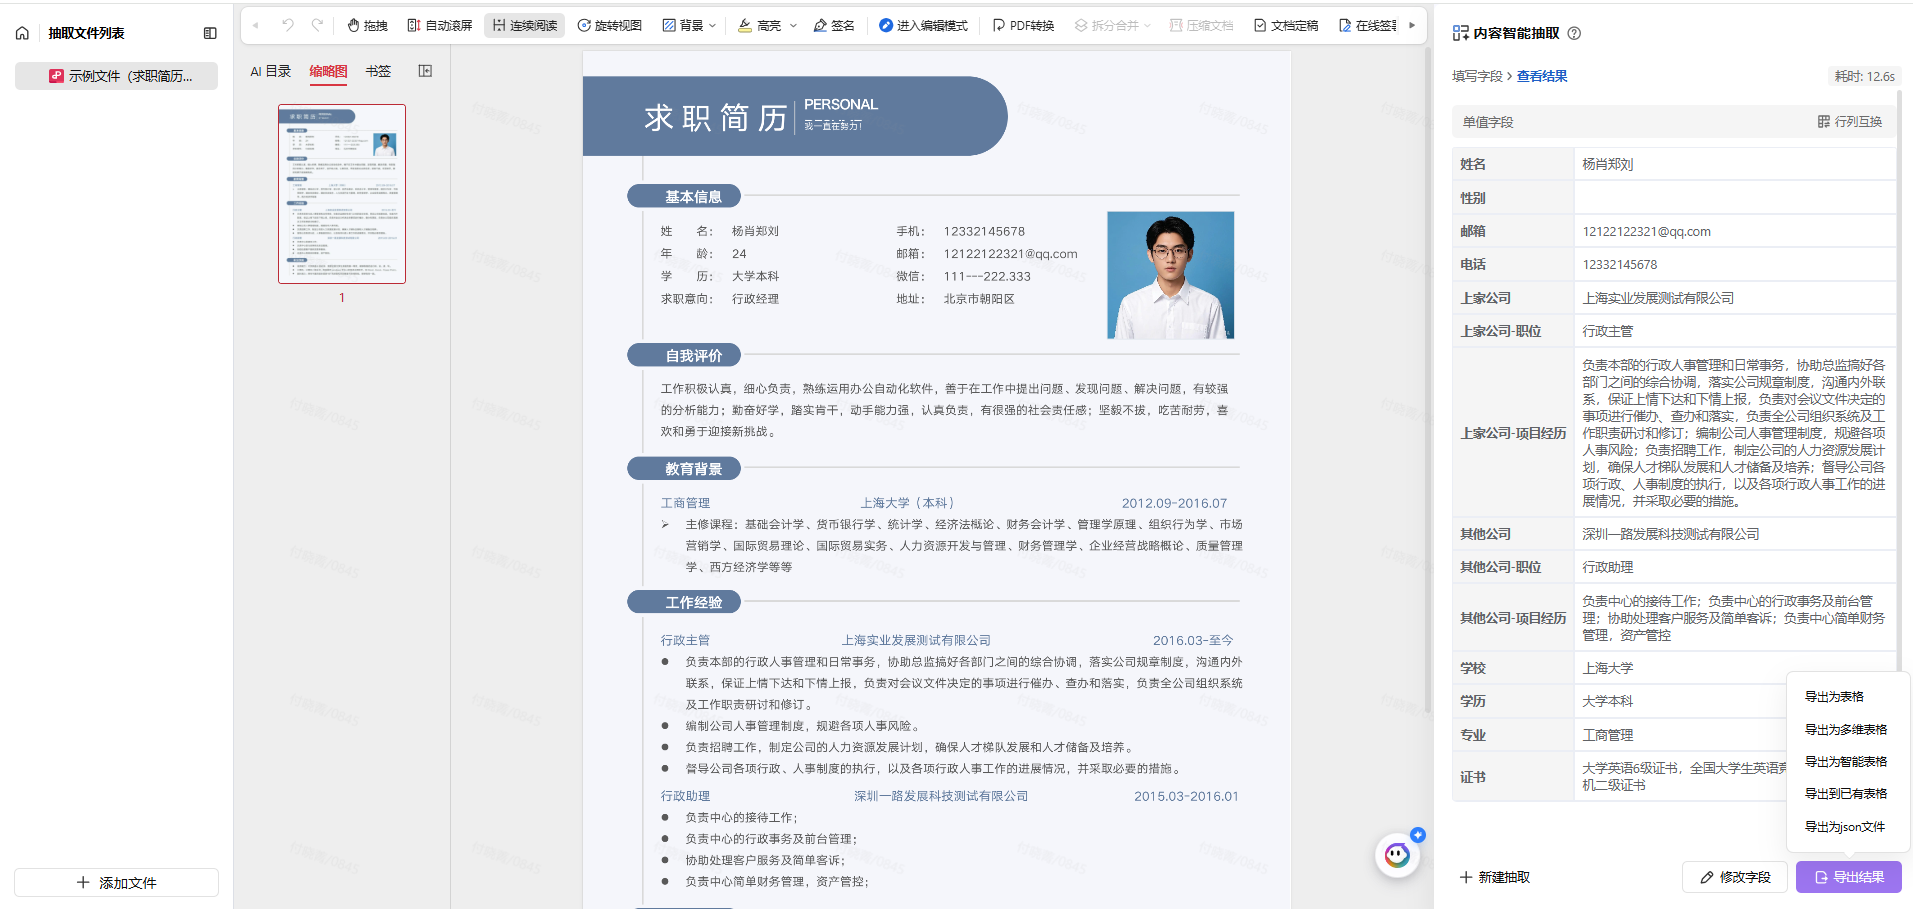
在企业非结构化数据处理中,称谓格式抽取常面临三大核心痛点:一是称谓与姓名、机构等实体混杂,同一文档内存在个人尊称、职称、学位等多种层级,导致人才库或台账信息混乱;二是中英文大小写、少数民族间隔符、外籍姓氏前置、生僻字、繁体字等复杂格式难以标准化识别;三是多页文档中称谓散落,跨页关联困难,人工抄录效率低且易出错。针对这些问题,智能抽取平台通过单字段与组字段的灵活配置加以应对——单字段适用于唯一称谓的精准提取,组字段则以数组嵌套结构将多类称谓拆分为独立记录,避免信息混叠。同时,平台支持为称谓字段配置parent层级、position页码与desc描述,精准识别复杂语境下的称谓边界。在结果输出层面,抽取数据以结构化键值返回,可直接导出为JSON或Excel格式,供人才库、CRM或OA系统回流,无需二次清洗。
从行业实践来看,金融保险领域的客户主数据治理、医疗健康领域的患者主索引建设、法律政务领域的档案数字化等场景,均对复杂称谓的规范化处理提出了迫切需求。例如,某股份制银行通过文档智能解析将历史开户资料中的复杂称谓统一标准化,核心系统重复建档率显著下降。值得注意的是,平台单次接口请求建议不超过十份文件,批量任务可通过异步队列处理;大并发场景需提前评估服务端资源,避免因超限导致任务阻塞。对于需要私有化部署的企业,平台亦支持单机版、集群版及容器化方案,适配国产化操作系统与硬件环境,满足数据安全合规要求。
针对招聘场景中简历称谓格式不统一、合同审查中当事人称谓层级复杂、发票场景中收付款方称谓与主体名称混用等痛点,智能抽取平台提供预置行业模板与文档智能解析的双重能力支撑。预置模板已覆盖人力资源、法务合规、财务发票等领域,内置中英文称谓、职称、学位等常见格式的抽取规则,同类文档可按统一口径反复抽取。以人力资源模板为例,候选人称谓作为单值抽出,推荐人、证明人称谓按组字段输出,多称谓各成一行;法务合规模板则将甲方/乙方/担保方称谓按层级抽出,与当事人姓名绑定供审查对照。
在文档智能解析层面,平台依托WPS文档结构解析底座,针对称谓格式进行OCR校正、版式分析与跨页关联增强。无论是jpg/jpeg/png图片、doc/docx文档还是PDF扫描件,均可识别手写体、印刷体、中英文混排等多样式称谓,并按段落、表格、版面布局解析称谓与姓名、公司的空间位置关系。单次最多支持50份、500页批量处理,抽取结果按字段溯源,可定位称谓在原文中的具体位置。对于需要实时处理的场景,如互联网平台大促期间亿级注册用户的昵称清洗,平台亦支持流式导出与毫秒级响应,虚假账号识别时效可由小时级缩短至秒级。
在部署与接入方面,平台提供标准开放API接口、网页端可视化控制台、主流开发语言SDK工具包及私有化定制对接四种方式。企业用户注册账号获取密钥后,可通过Postman验证示例,经沙箱环境测试后申请生产环境权限。抽取完成后返回标准JSON结构化数据,包含置信度分数与字段值,层级字段以嵌套对象呈现,组字段以对象数组呈现,同时提供原始文本定位信息便于人工复核,真正实现称谓信息从非结构化文档到业务系统的无缝回流。
在实际业务对接中,称谓格式抽取的常见技术难题集中体现在三个层面。首先是格式歧义问题,同一文档内可能出现"张三 先生""Dr. Li 教授""王(某)法定代表人"等混合格式,通用OCR容易将称谓与姓名、角色与实体误合并,导致后续系统无法自动拆分。其次是层级映射问题,复杂场景下存在个人尊称、职称、学位、部门称谓、机构后缀等多种层级,若缺乏parent层级与desc描述的精准配置,极易出现"甲方法定代表人"被拆分为孤立称谓字段、无法关联到具体当事人的情况。再次是结果对齐问题,当文档中存在多类称谓组时,如简历中候选人、推荐人、证明人三类称谓并存,若未启用group组字段区分,所有称谓将挤在同一行,造成人才库中信息混乱、难以追溯来源。
针对上述问题,平台建立了标准化的字段配置规范。single类型适用于唯一称谓场景,如简历中候选人的"博士"职称;group类型则通过数组嵌套结构将多类称谓拆分为独立记录,每条记录包含称谓值、所属实体、出现位置等完整信息。在规则定义层面,desc描述字段支持以自然语言标注抽取逻辑,如"提取冒号后的职称称谓";parent层级字段可配置所属部门或公司,实现"某部某经理"的层级化识别。结果输出时,键值对中的key严格对应配置字段名,value包含置信度分数与原始文本坐标,确保JSON可直接被CRM、OA等系统解析入库,Excel形态则适配财务台账等线下核对场景。
在金融保险、医疗健康、法律政务等强合规行业,平台进一步提供标准化清洗规则。例如处理少数民族姓名间隔符时,自动识别"·""•"等符号并转换为标准全角点;面对外籍人士姓氏前置格式,依据desc规则判断"Smith John"中姓氏位置并重组为"John Smith(某斯某)"的双语结构。对于多页合同、卷宗中跨页分散的称谓,版式分析引擎通过语义连贯性判断实现跨页关联,避免同一当事人因分页而被拆分为两条记录。这些标准规范的落地,使得称谓抽取结果可直接写入客户主数据、患者主索引等核心系统,无需二次开发适配。
企业级称谓格式抽取的规模化落地,对部署灵活性与数据安全性提出了双重考验。智能抽取平台提供标准开放API、网页端可视化控制台、主流开发语言SDK及私有化定制对接四种接入方式,覆盖从快速验证到深度集成的全生命周期需求。企业用户完成账号注册与密钥获取后,建议先用Postman调试示例请求,再经沙箱环境充分测试,最终提交工单申请生产环境权限。对于金融、政务等强监管行业,平台支持单机版、集群版及容器化私有化部署方案,适配国产化操作系统与硬件环境,结合KSO-1签名与Bearer token双重鉴权机制,确保敏感称谓数据不出域。
在性能保障层面,平台采用异步任务队列与流式处理双模式适配不同业务节奏。批量文档处理场景下单次可提交50份、500页,任务状态涵盖待处理、处理中、成功、失败及超时五类,支持实时查询与失败重试;实时处理场景如互联网大促期间的昵称清洗,则可实现毫秒级响应与秒级入库。抽取结果以标准化JSON返回,单字段呈嵌套对象,组字段呈对象数组,每条记录附带置信度分数与原始文本坐标定位,既便于人工复核,也支持直接写入CRM、OA、ERP等业务系统,真正实现称谓数据从非结构化文档到企业数字资产的闭环流转。
值得关注的是,平台通过持续迭代已沉淀覆盖金融、医疗、法律、人事等八大行业的预置模板,企业可基于模板快速复制调整,而非从零配置字段规则。这种"开箱即用+灵活定制"的组合策略,使典型项目的上线周期从数周压缩至数日,显著降低了复杂称谓抽取的技术门槛与实施成本。
历史开户资料中姓名含中英文大小写、少数民族间隔符及外籍姓氏前置等复杂格式,导致核心系统称谓混乱、重复建档率高达12%。通过文档智能解析统一抽取并标准化清洗,将标准化称谓直接写入客户信息主表。
门诊病历与住院记录中患者姓名含生僻字、繁体字及拼音备注混合格式,导致HIS系统识别失败、多院区同一患者被拆分为多条记录。通过智能解析建立标准化患者主索引,实现复杂称谓转码与重复记录合并。
20万卷历史裁判文书中当事人称谓含化名、曾用名及手写体潦草难辨,导致类案检索召回仅72%、档案数字化进度严重滞后。通过OCR及同义词库建立,实现化名关联与精准抽取。
企业称谓格式抽取面临三大核心痛点:一是称谓与姓名、机构等实体混杂,多层级信息导致人才库混乱;二是中英文大小写、少数民族间隔符、外籍姓氏前置等复杂格式难以标准化;三是多页文档中称谓散落,跨页关联困难。智能抽取平台通过单字段与组字段灵活配置应对,支持parent层级、position页码与desc描述精准识别边界,输出结构化JSON/Excel。金融、医疗、法律等行业已验证成效,建议企业优先选用预置模板快速上线,结合沙箱测试后接入生产环境,并评估私有化部署满足合规要求。

基于AI智能抽取,精准识别合同中甲方/乙方/担保方等多层称谓,自动绑定当事人姓名,解决合同审查中称谓混用与层级错乱难题,让复杂称谓一键结构化。




智能解析发票与财务单据中的收付款方称谓,自动清洗中英文、职称、机构后缀等杂乱格式,实现称谓标准化,直接回写财务系统,告别人工核对。

利用AI抽取能力,从项目文档中自动提取负责人、成员等称谓信息,支持多称谓组字段输出,确保项目台账中人员称谓准确、可溯源。

针对业财一体文档中的称谓格式混乱问题,提供智能抽取与标准化清洗,自动关联部门、职称等层级,助力企业主数据治理与合规存档。




快速抽取订单、客户档案中的称谓信息,智能处理双文、外籍姓名等复杂格式,结果直接写入CRM,大幅提升客户关系数据质量。
智能解析发票与财务单据中的收付款方称谓,自动清洗中英文、职称、机构后缀等杂乱格式,实现称谓标准化,直接回写财务系统,告别人工核对。
基于AI智能抽取,精准识别合同中甲方/乙方/担保方等多层称谓,自动绑定当事人姓名,解决合同审查中称谓混用与层级错乱难题,让复杂称谓一键结构化。
利用AI抽取能力,从项目文档中自动提取负责人、成员等称谓信息,支持多称谓组字段输出,确保项目台账中人员称谓准确、可溯源。

智能识别进销存单据中的联系人称谓,支持手写体、印刷体、中英文混排,并通过组字段区分多类称谓,实现库存与采购数据的自动化录入。
支持single/group区分唯一与批量称谓,按业务口径精准抽取,避免信息混叠。
内置人力、法务、财务等模板,称谓规则开箱即用,统一口径减少配置时间。
解析段落、表格布局,识别称谓与实体位置关系,解决多页文档称谓散落难题。
为称谓配置所属部门/公司,实现复杂层级化识别,关联当事人无误。
抽取结果以JSON/Excel键值返回,可直接写入CRM/OA等系统,无需二次清洗。
支持单机/集群/容器化部署,双重鉴权,确保敏感称谓数据不出域,满足合规要求。
精准识别多层级、某格某式称谓,支持跨页关联与结构化输出,无缝回流至业务系统,助力人才库、CRM等场景数据治理。
