

AI 智能抽取
智能识别公文发文字号,精准提取机关代字、年份、顺序号等要素,支持批量处理与API对接,大幅降低人工抄录差错率。
智能识别公文发文字号,精准提取机关代字、年份、顺序号等要素,支持批量处理与API对接,大幅降低人工抄录差错率。

输入主题一键生成专业PPT,智能排版配色,让公文汇报、政策解读演示更高效,节省大量制作时间。

支持多语种公文精准翻译,保留原文格式与专业术语,助力涉外政务、企业跨国文件高效流转。

快速创建收文登记、意见征集等在线表单,自动汇总数据,无缝衔接发文字号抽取后的归档管理流程。

高清稳定在线会议,支持屏幕共享与协作标注,方便远程核验发文字号抽取结果,提升跨部门协作效率。
发文字号智能抽取面向政府公文、企业红头文件等场景,解决收文登记人工抄录易遗漏、档案系统字段空白等痛点。支持PDF扫描件批量处理,按眉首、标题、版记自动提取机关代字、年份、顺序号,提供预置模板快速验证、自定义字段适配联合行文、标准API对接业务系统三步上手路径,单次批量处理50份公文,输出结构化JSON直接写入收文登记与档案管理平台。
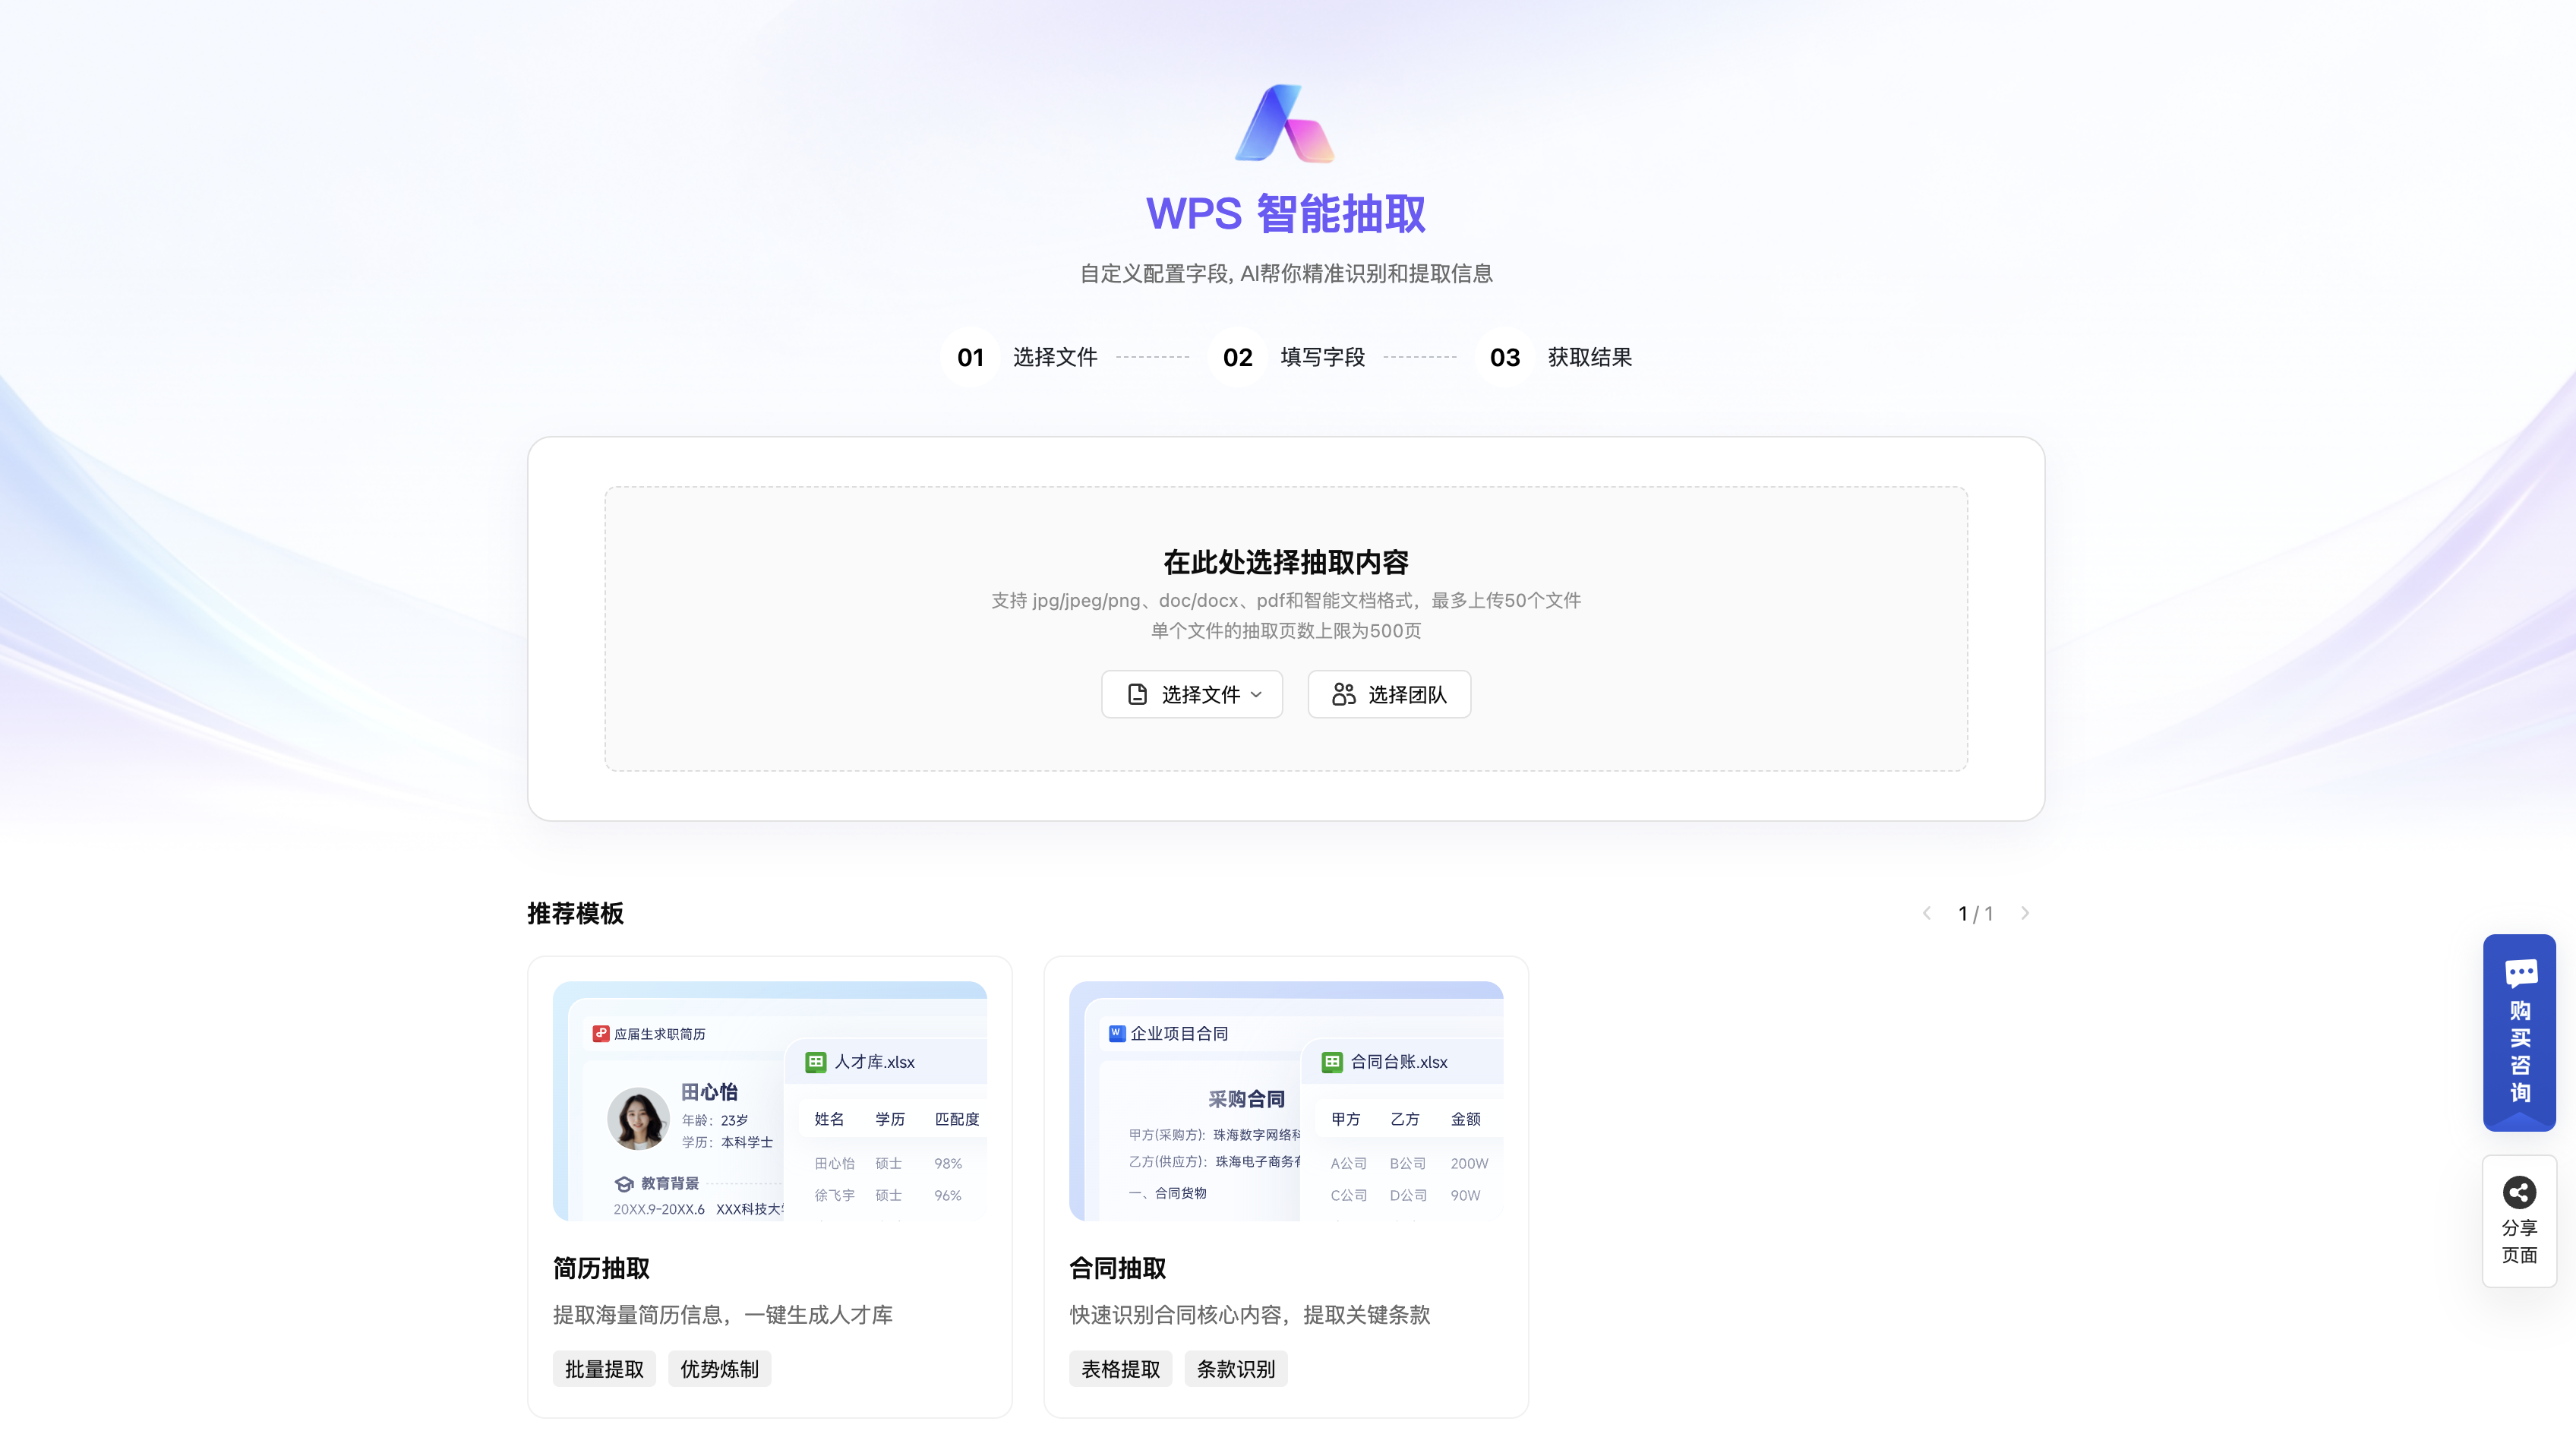
发文字号智能抽取面向政府公文、企业红头文件、机构函件等场景,旨在解决收文登记中人工抄录易遗漏错录、档案系统字段长期空白等痛点。上手时可从启用预置模板开始,该产品已针对公文特殊版式进行OCR校正与版面分析增强,可精准识别仿宋_GB2312等公文字体,并支持《党政机关公文格式》(GB/T 9704-2012)标准解析。用户仅需将PDF扫描件、图片或某办公软件文档提交至系统,即可按眉首、标题、版记等版面位置自动提取机关代字、年份、发文顺序号等关键要素,单次最多可批量处理50份公文。
若单位存在联合行文、多字号共存或格式变体等复杂情况,可进一步配置自定义字段与结果导出功能。系统支持single单值字段与group组字段灵活组合,能够将联合行文中的多个发文字号拆分为独立记录,并通过parent层级标注来源位置,输出结构化JSON或表格数据,直接对接收文登记、档案管理或OA流转平台。需要说明的是,该功能属于WPS 365商业旗舰版中的AI能力范畴,商业高级版及更低版本用户如需使用,需联系销售开通或评估升级某商某业旗舰版(599元/人/年),后者同时提供完整的AI Hub、AI使用分析及2TB/人存储空间。企业开发者可通过标准API接口接入,提交文件时优先使用file_id以保障传输稳定,抽取结果附带页码与段落坐标,可一键跳转原文核验,大幅降低公文数字化的人力成本与差错率。
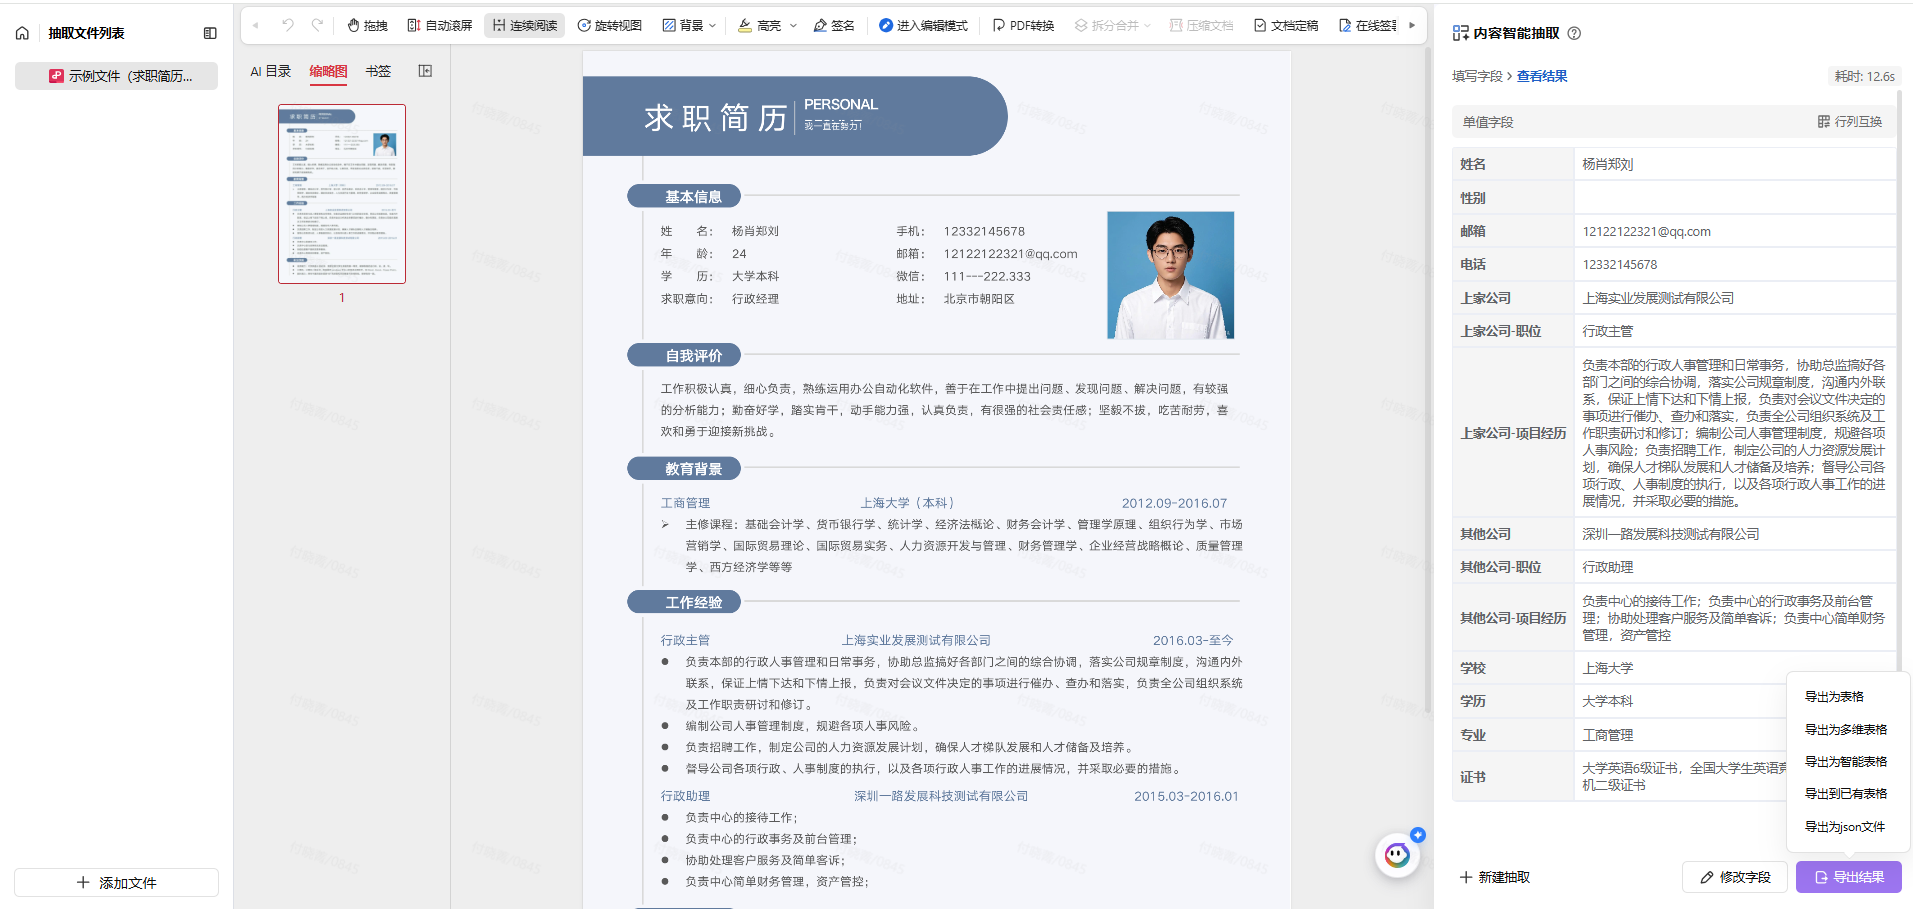
发文字号智能抽取的核心价值在于将分散于公文眉首、标题或版记的发文字号转化为结构化数据。实战上手时,建议先通过预置的政府公文模板快速验证效果:上传PDF扫描件或图片后,系统会自动识别红头、分隔线等版式特征,定位仿宋_GB2312、某正某小标宋等公文字体区域,输出机关代字、年份、发文顺序号等子字段。对于标准格式如“某发某〔2024〕1号”,抽取准确率已针对GB/T 9704-2012优化;若遇印章遮盖、扫描倾斜等场景,系统会结合上下文版式推断补全。
当遇到联合行文、多字号共存或单位内部特殊编号规则时,需启用自定义字段功能进阶配置。通过group组字段可将主送、抄送单位的多个发文字号拆分为独立记录,避免串号漏号;通过parent层级标注“眉首发文字号”“版记字号”等位置来源,便于按来源口径校验。抽取结果以JSON或表格形态返回,包含页码、段落坐标等位置信息,可一键跳转原文核验,亦可通过标准API接口直接写入收文登记系统或档案管理平台,实现全流程自动化。
对于初次接触发文字号智能抽取的用户,建议采用"模板验证—场景适配—系统对接"三步走策略。第一步,在WPS 365商业旗舰版的AI Hub中启用政府公文预置模板,直接上传本地PDF扫描件或图片进行测试验证,系统会自动完成OCR识别、版面分析与发文字号定位,输出机关代字、年份、顺序号等结构化字段。第二步,根据单位实际公文格式进行微调:若存在联合行文多字号场景,在自定义字段模块中将单值字段切换为group组字段,为每个字号独立配置机关代字、类别代字、年份等子字段,并通过parent层级标注眉首、标题、版记等来源位置,确保多字号不串行、来源可追溯。第三步,通过标准API接口将抽取能力嵌入收文登记系统或档案管理平台,提交时优先使用file_id参数保障传输安全,接收JSON结构化结果后自动写入业务数据库,实现从文件接收到数据归档的全流程自动化。
发文字号智能抽取的落地路径可概括为"试点验证—规则适配—系统贯通"三个阶段。试点阶段,用户应在WPS 365商业旗舰版中启用政府公文预置模板,选取本单位最具代表性的10-20份PDF扫描件或图片上传测试,重点关注眉首红色分隔线上方、标题附近、版记三个典型位置的识别效果,核查机关代字、年份、顺序号等子字段的拆分准确度。此阶段可同步检验系统对仿宋_GB2312字体、扫描倾斜、低对比度等复杂场景的适应能力,形成初步的效果基线。
规则适配阶段需针对本单位特殊格式进行自定义配置。若公文含联合行文多字号,应将single字段扩展为group组字段,使每个字号形成独立记录;若存在"某发〔2024〕人字第005号"等含类别代字的变体格式,需增补类别代字子字段并通过parent层级标注眉首或版记来源。配置完成后以JSON格式导出结果样本,验证字段层级与收文登记系统、档案管理平台的数据接口是否匹配,必要时调整字段命名与组合规则。系统贯通阶段则通过标准API完成嵌入,提交时优先采用file_id参数确保传输安全,异步获取结构化结果后自动写入业务数据库。整个过程中,抽取结果附带的页码与段落坐标为人工复核提供了精准锚点,业务人员可一键跳转原文比对,将差错率控制在极低水平。
各级来文PDF扫描件发文字号分散在眉首、版记,人工逐份抄录易漏号错号。启用预置政府公文模板后,系统自动识别版式与公文字体,抽取出机关代字、年份和顺序号,并自动写入收文台账。
传票、判决书等送达文书案号与开庭日期需人工摘录,多案件材料混杂易出错。通过法律文书模板智能抽取案号、案由、当事人,同类案件自动归集并同步日历提醒排期。
招标公告PDF中招标编号、截止日等信息分散,多项目并行时保证金缴纳易混淆。启用招标投标模板后,系统自动抽取关键字段并写入跟踪台账,对截止时限设置分级预警。
发文字号智能抽取上手建议采用"模板验证—场景适配—系统对接"策略:第一步,在WPS 365商业旗舰版AI Hub中启用政府公文预置模板,上传PDF扫描件或图片测试,系统自动完成OCR识别与发文字号定位;第二步,针对联合行文等多字号场景,将single单值字段切换为group组字段,通过parent层级标注来源位置,确保多字号不串行;第三步,通过标准API嵌入收文登记或档案系统,优先使用file_id保障传输稳定。日常单次批量建议控制在50份以内,结果附带页码坐标可一键跳转核验,大幅降低人工抄录差错率。

好业财集成AI智能抽取,自动识别财务公文发文字号,实现收文登记与凭证关联,提升档案数字化效率。




好会计结合发文字号智能抽取,精准提取机关代字与年份,快速完成公文自动记账与归档。

WPS 项目管理内嵌AI抽取能力,自动解析项目公文字号,实现任务文档自动归集与一键溯源。
好业财集成AI智能抽取,自动识别财务公文发文字号,实现收文登记与凭证关联,提升档案数字化效率。
好会计结合发文字号智能抽取,精准提取机关代字与年份,快速完成公文自动记账与归档。

好生意融合发文字号智能抽取,自动抓取商贸类公文字号,驱动订单与公文流转高效协同。

WPS 合同管理嵌入AI智能抽取,自动提取合同发文字号与关键条款,实现合同快速登记与合规审查。




WPS 进销存对接发文字号智能抽取,自动识别采购公文字号,精准匹配单据与收发记录,减少人工录入。
WPS 项目管理内嵌AI抽取能力,自动解析项目公文字号,实现任务文档自动归集与一键溯源。
启用政府公文模板,上传扫描件自动识别发文字号字段,验证效果。
针对单位特殊编号规则,增补字段与层级,适配变体格式。
配置group组字段,将多单位发文字号拆分为独立记录,避免串号。
单次提交50份,异步队列跟踪状态,收文高峰期不积压。
通过API获取JSON结果,自动写入收文或档案系统,全流程自动化。
抽取结果附带页码坐标,可一键跳转原文比对,降低差错率。
基于GB/T 9704-2012标准,精准识别眉首、版记等区域,自动提取机关代字、年份和顺序号,支持联合行文多字号拆分、结果一键跳转原文核验。异步批量处理,API直连业务系统,大幅降低人力成本。