

WPS 黑马校对
依托8000万词条专业库,支持形近字、音近字等14大类错误识别,嵌入三审三校流程,实现古籍生僻字、科技符号等深度校对,年处理能力超5000万字。
依托8000万词条专业库,支持形近字、音近字等14大类错误识别,嵌入三审三校流程,实现古籍生僻字、科技符号等深度校对,年处理能力超5000万字。

支持多人协作审校与实时错字标红,自动记录修改痕迹与术语更新历史,生成可视化质量报告,构建可追溯的动态优化知识库,提升编校协同效率。

集成智能初筛引擎与专家复核系统,支持自定义正词库、敏感词黑名单及14类专业术语库,实现跨地域分支机构错字检测标准统一与实时同步,保障内容安全合规。

内置邮件内容错字检测与敏感词过滤,自动校验格式规范与专业术语,确保商务往来文稿准确严谨,支持私有化部署满足保密单位内网审校需求。

贯通错字检测全流程任务管理,智能分配初审、复审、终审节点,实时追踪书稿处理进度与差错率统计,助力出版单位建立标准化质量管控体系。
WPS黑马校对提供错字检测完整流程解决方案,涵盖文本导入、自动分词、词库匹配、上下文语义分析、错误标红、格式规范化及专业术语校准。依托8000万词条专业库与30年技术积累,支持形近字、音近字、义近字等14类文字错误识别,10万字文稿3分钟完成初筛,适配出版、古籍、科技、数字内容等多场景,助力党政机关、出版社、企业建立可追溯的质量管控体系。
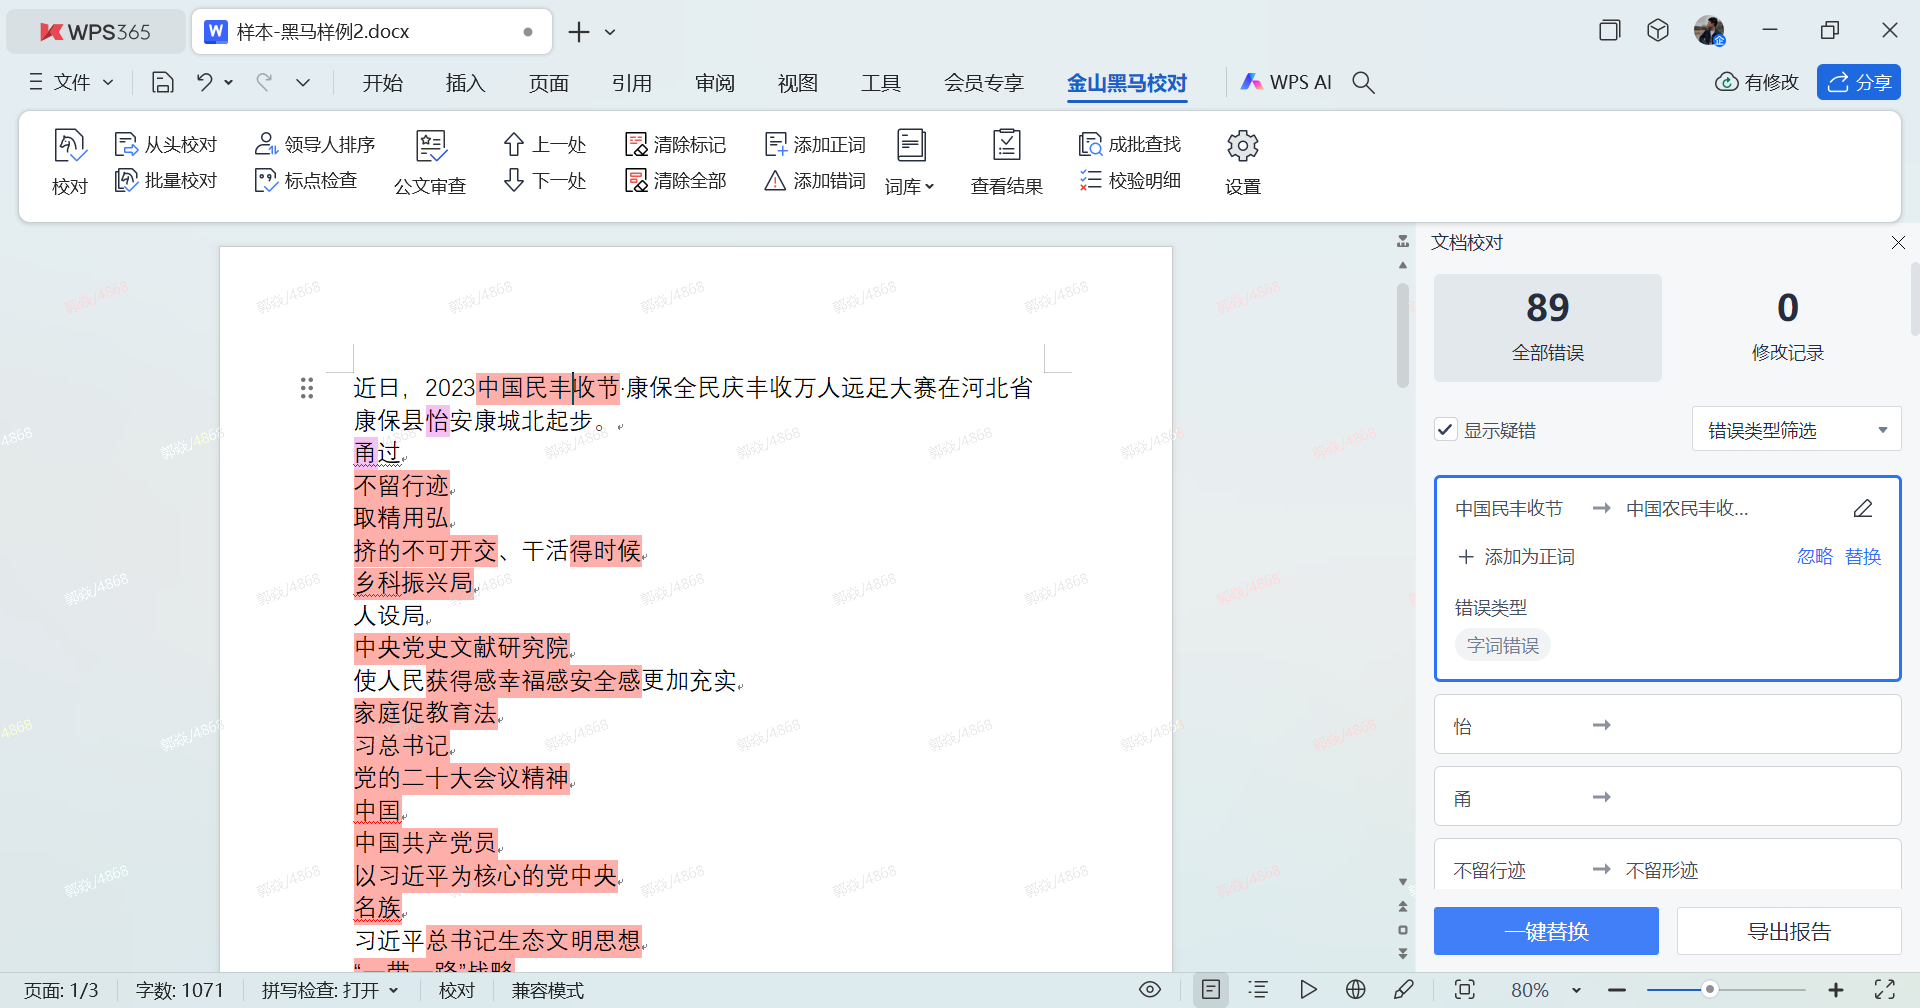
错字检测的完整流程涵盖从文本导入到质量报告生成的全链路闭环,首要环节为智能初筛引擎对文稿进行全文扫描。系统通过自动分词技术将文本切分为语义单元,依托8000万词条专业库进行词库匹配,结合上下文语义分析排除歧义,自动识别形近字、音近字、义近字、别字、漏字等14大类文字错误,实时标红并推送修正建议。针对WPS 365用户,商业高级版(399元/人/年)及商业旗舰版(599元/人/年)可接入该校对能力,但部分深度功能可能需联系销售开通或属于加价购服务,体验版及商业协作版用户需特别关注功能开放范围。
流程进阶阶段包含格式规范化与专业术语校准两大核心模块。系统在完成错字初筛后,自动检测标点符号误用、全半角混用、序号格式混乱等与错字相关的排版问题,确保文稿符合正式出版标准;同时通过正词库、错词库、重点词库等五大词库管理机制,避免专业术语被误判,支持企业自定义内部规范用语与敏感词黑名单。某省级出版社应用该流程后,年处理书稿规模超5000万字,重点图书差错率显著下降;古籍出版领域亦通过生僻字识别引擎完成3000万字数字化校勘,精准纠正异体字问题1.2万处。
整个流程支持批量文档并行处理与API实时接入,10万字文稿可在3分钟内完成初筛,生成的校对报告详细记录错误类型、位置、修改状态及术语使用统计,便于审核留痕与责任追溯。数字出版平台可通过云端接口实现秒级响应,将传统审校流程压缩至极速完成,但具体服务层级、处理额度及私有化部署方案需根据所选WPS 365套餐版本及企业级私有词库配置需求确定。
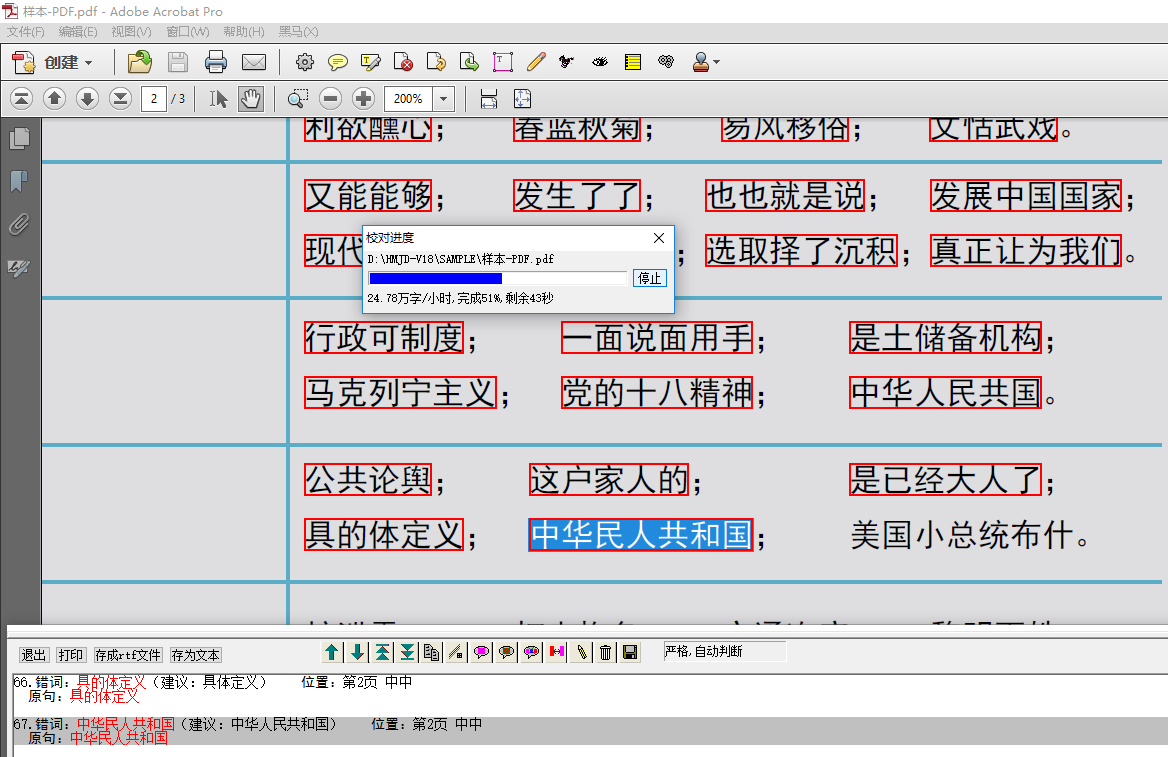
错字检测的完整流程并非止于机器初筛,而是构建人机协同的多级质量关卡。系统在自动标红疑似错误后,进入专家复核阶段,严格嵌入出版行业的三审三校流程:初审聚焦智能标记的形近字与音近字风险点,复审核查专业术语库匹配结果与上下文语义逻辑,终审则结合排版规范确认格式修正的完整性。针对古籍整理、科技出版等特殊场景,流程中增设专项校验节点——古籍编纂启用生僻字异体字溯源比对与繁简转换校验,医学科技类内容则启动希腊拉丁字符识别、公式符号纠错及数据单位一致性验证,确保学术严谨性。
流程的智能化闭环体现在持续学习与动态优化机制。用户在校对过程中手动标记的漏检错误或误报词汇,将实时反馈至系统训练模型,自动更新错词库与正词库规则。企业级部署支持多级权限管理,总部可统一配置领导人职务库、排序库及敏感词黑名单,分支机构在本地执行校对时同步云端词库标准,实现组织内错字检测规则的统一生效与实时同步。
最终生成的质量档案不仅包含错字清单,更形成涵盖错误类型分布、术语使用规范率、修改响应时效的可视化报告,为出版单位建立可追溯的质量管控体系。从网络文学平台的API实时接入到古籍出版社的离线私有化部署,该流程通过灵活的模块化配置,适配从秒级响应到深度学术考证的全场景需求,真正实现错字风险的全生命周期管理。
错字检测的完整流程需深度适配出版传媒、科技学术、数字内容等多元场景的差异化需求。针对科技图书与医学教材领域,系统内置希腊拉丁字符识别引擎与权威专业术语库,自动校验公式符号排版规范、数据单位一致性及图表交叉引用准确性,精准识别理工医类内容中因符号混排、术语更新迅速导致的特定错字;面向网络文学与自媒体平台,提供云端API实时接入能力,支持日更百万字级别的秒级极速校对,在创作端即实现错别字即时标红与修正建议推送,将质量管控前移至发布前的关键环节,显著降低多平台分发中的格式转换错误。
部署模式上,系统充分考量不同组织的IT架构与保密要求,支持WPS插件、独立客户端、私有化服务器及云端SaaS四种形态灵活组合。保密单位可采用纯软件授权方式,在内部网络完成账号激活与全流程操作,无需外接存储设备即可实现10万字文稿3分钟极速初筛;大型集团企业则可通过企业级私有词库部署,集中管理领导人职务库、敏感错词黑名单及14类专业术语库,实现跨地域分支机构的错字检测标准统一与实时同步,确保专业术语校准与格式规范化的组织级落地。
从古籍整理的生僻字异体字溯源考证到网络文学的实时质量把关,从纸质出版的严谨三审三校到数字内容的秒级极速发布,该流程依托30年技术积累与8000万词条专业库,通过模块化功能配置与多级权限管理,构建覆盖全媒介形态、全业务流程的文字质量保障体系。无论是年处理5000万字的书稿规模还是日更3000万字的平台流量,均能实现错字识别准确率近90%、校对速度较人工提升90%的高效产出,助力各类组织在数字化转型中建立可追溯的质量档案与内容安全合规屏障。
在实际应用中,错字检测的完整流程注重用户与系统的深度交互体验。当系统自动标红疑似错误后,界面会弹出按相似度排序的候选词列表,用户可执行一键替换、批量忽略或加入白名单等操作。针对专业术语或专有名词的误报,编辑可即时将其添加至自定义正词库,系统随后自动学习并在后续检测中排除同类干扰。若发现漏检错误,用户通过手动标记并提交反馈,系统将根据反馈结果动态调整分词引擎的敏感度参数,持续优化形近字与音近字的识别精度。
流程特别强化多语言混合内容的协同处理能力。面对中英文混排、拼音注释或希腊字母公式,系统启动并行检测机制:中文部分依托8000万词条专业库进行语义分析,英文内容启用独立词库与语法规则校验,拼音则校验拼写规范,确保科技文献与双语出版物中的错字无处遁形。所有操作记录与修改痕迹均实时同步至云端,形成可追溯的审校日志。
最终导出的校对报告不仅包含错误统计,更详细记录用户反馈与词库更新历史,为出版单位建立动态优化的质量知识库。通过这种人机双向赋能的闭环设计,系统在30年技术积累基础上不断进化,使错字检测从单纯的工具应用转变为持续精进的智能审校伙伴。
图书种类繁多导致审校标准难统一,人工核对效率低,多音字形近字易漏检。引入全流程智能审校体系,自动比对字形与语境,批量处理书稿,无缝嵌入三审三校流程,实现闭环管理。
生僻字异体字数量庞大,繁简转换易出错,人工核对要求极高。采用专业化错字检测引擎,融合字形分析与历史词库比对,支持专家协同复核,确保古籍整理严谨性。
专业术语更新快,符号公式混排,传统校对难以识别特定错误。构建科技医学错字检测流程,整合术语库与符号识别引擎,自动校验数据单位与图表引用,建立分级预警。
错字检测完整流程涵盖智能初筛、专家复核与持续优化三大阶段。系统通过自动分词与8000万词条库匹配,识别形近音近等14类错误并实时标红;嵌入三审三校流程,针对古籍、科技等场景增设专项校验节点,支持自定义词库与多级权限管理。用户反馈实时优化模型,形成质量档案。该流程支持WPS插件、API及私有化部署,10万字3分钟完成初筛,差错率降低90%以上,适配出版、传媒、学术等全场景需求。

与WPS文档无缝集成,支持合同起草、审批、存档全流程,内置黑马校对引擎,精准识别错漏别字,保障法律文书严谨合规,提升合同管理效率。




专业智能财务软件,与WPS表格深度打通,集成黑马校对引擎,可精准识别财务报告中的文字错误,保障财税数据准确合规,小微企业记账报税更省心。

智能生意管理助手,与WPS办公套件无缝对接,借助黑马校对技术自动排查商品信息、订单描述中的错别字,提升经营数据质量,让生意更高效。
与WPS文档无缝集成,支持合同起草、审批、存档全流程,内置黑马校对引擎,精准识别错漏别字,保障法律文书严谨合规,提升合同管理效率。

深度协同WPS表格,实现采购、销售、库存一体化管理,借助黑马校对自动校验商品信息与单据,杜绝人工录入错误,助力企业精准运营。

与WPS协作套件打通,支持任务分配、进度跟踪与文档协同,内置黑马校对能力,确保项目报告、计划书零差错,提升团队执行效率。

业财一体化管理平台,整合WPS文档处理能力,黑马校对确保业务单据、财务凭证文字无误,实现业务与财务数据精准同步,驱动企业智慧决策。



智能生意管理助手,与WPS办公套件无缝对接,借助黑马校对技术自动排查商品信息、订单描述中的错别字,提升经营数据质量,让生意更高效。
专业智能财务软件,与WPS表格深度打通,集成黑马校对引擎,可精准识别财务报告中的文字错误,保障财税数据准确合规,小微企业记账报税更省心。
自动识别14类错字,敏感词与领导人职务排序实时校验,确保公文权威性,降低政治性差错风险。
扫描形近字、漏字与全半角混用,避免因错字引发法律歧义,10万字3分钟完成初筛。
企业自定义正词库、错词库与重点词库,确保医疗、法律、金融等术语零误判,表述规范。
支持多文档并行校对,一键导出错字报告,审核留痕,大幅压缩多层审校周期。
自动统一标点、全半角、序号格式,修正引号书名号配对错误,改后即达出版标准。
中英文混排、希腊字母、公式符号并行校验,让科技文献与双语资料错字无处遁形。
基于8000万词条专业库,覆盖14类文字错误,3分钟极速处理10万字文稿,支持企业级私有词库与多场景灵活部署,赋能出版、科技、自媒体高效零差错。