

AI 智能抽取
精准识别PDF书签层级与页码映射,支持多级目录结构化为JSON/表格,无缝对接知识管理系统。
精准识别PDF书签层级与页码映射,支持多级目录结构化为JSON/表格,无缝对接知识管理系统。

灵活配置自定义字段与元数据管理,结构化存储书签抽取结果,助力编目数据可视化分析。

智能解析复杂版式与跨页表格,批量处理50份/500页文档,异步任务状态实时可查。

团队协同编目与书签模板共享,支持私有化部署与混合架构,保障敏感文献处理安全合规。

任务通知与解析结果即时推送,KSO-1双重鉴权确保传输安全,适配企业级系统对接需求。
企业在选型书签内容抽取方案时,需评估文档结构复杂度与业务系统对接需求。AI智能抽取依托WPS文档解析底座,支持PDF书签层级识别、多级目录结构化及自定义字段配置,输出表格或JSON对接知识管理系统。涵盖出版编目、招聘初筛、财务发票、物流运单等场景,单次支持50份500页批量处理,提供私有化部署方案。
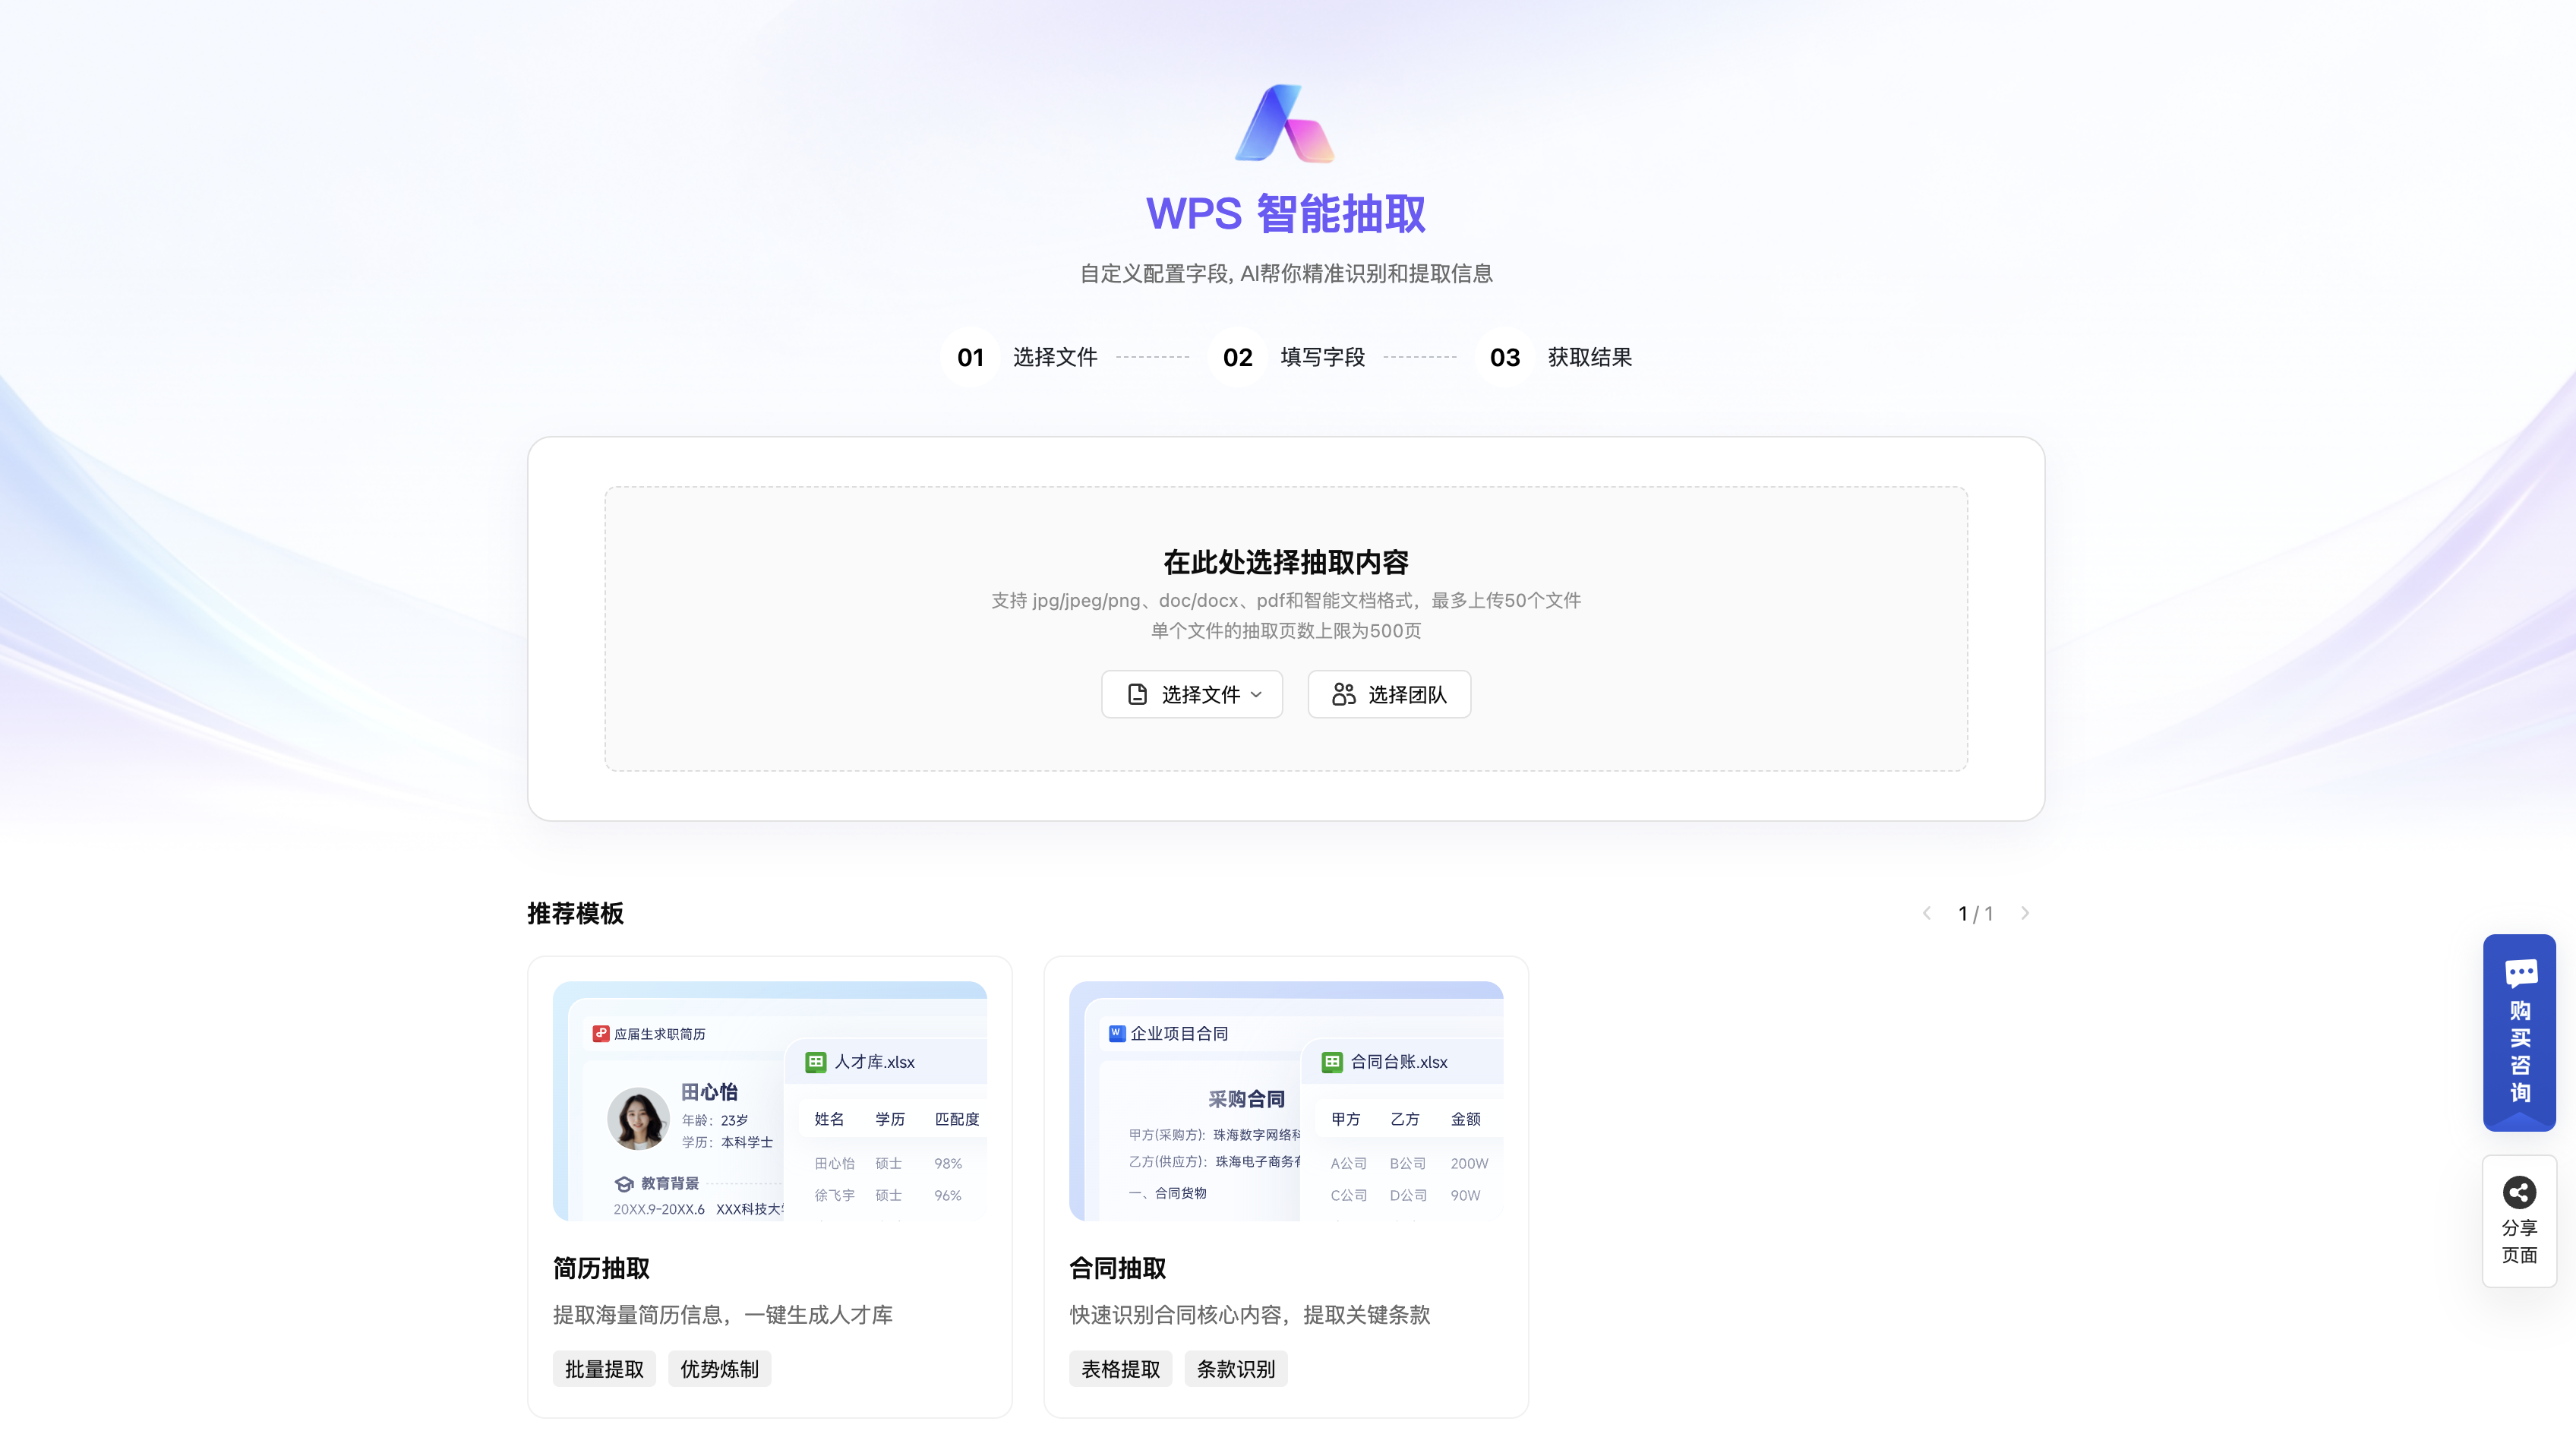
企业在进行书签内容抽取选型时,核心在于评估文档结构复杂度与业务系统对接需求。对于出版编目与知识管理场景,文档智能解析可识别PDF书签层级与页码映射,按章节目录抽取多级结构,解决纸质文献与扫描件书签混乱、手工编目耗时的问题。选型时需关注解析引擎对段落、表格、图片与版面布局的处理能力,以及是否支持跨页表格和复选框等复杂版式。自定义字段与结果导出功能则允许补充ISBN、作者等元数据,并可将多级书签结构化为可检索字段输出为表格或JSON,直接对接知识管理系统。
在技术实现层面,选型应考量异步处理能力与批量性能。文档智能解析支持单次最多50份、500页的批量提交,提交后可通过任务ID查询处理中、成功或失败状态,适配大批量与长耗时文档处理。调用方式上,云上文件可使用file_id或公开file_url二选一提交,鉴权采用KSO-1签名与Bearer token双重机制。若企业涉及简历、合同、发票等更多场景,可结合预置行业模板快速启用;而WPS素材库、WPS项目管理等功能在各档套餐中均需加价购买,需根据实际预算评估。对于数据安全要求较高的企业,该服务支持私有化部署方案,可将系统部署至企业内部服务器以满足合规需求。
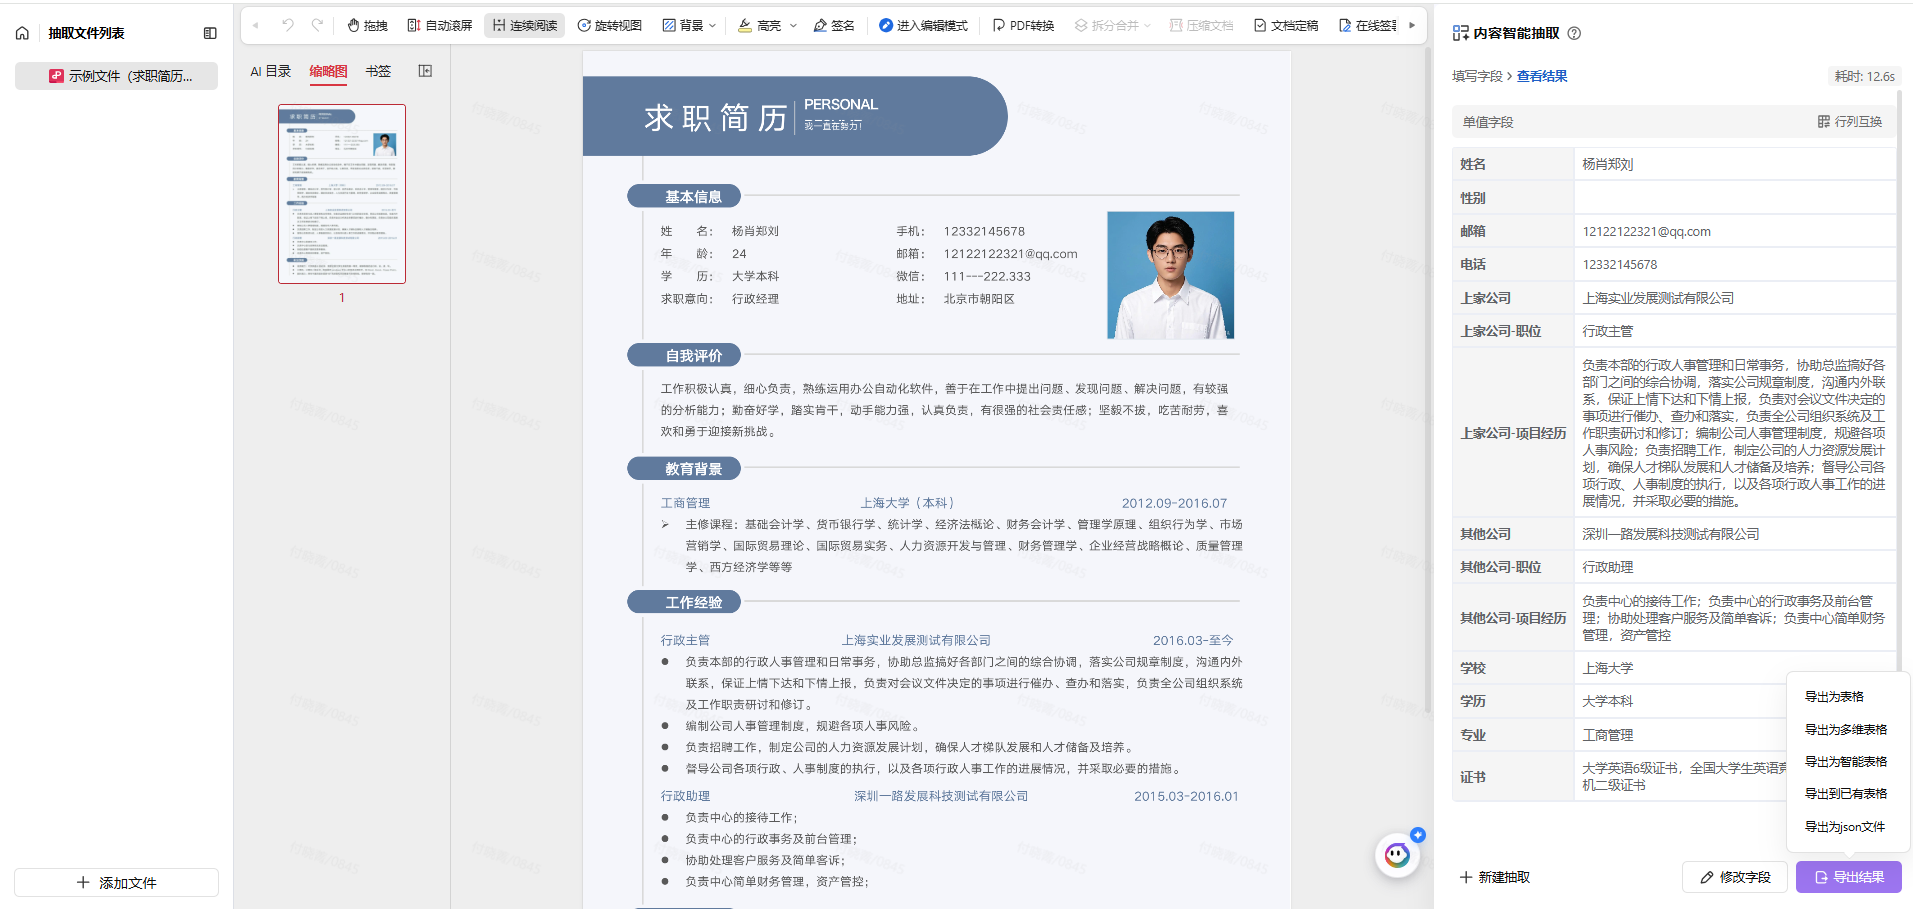
书签内容抽取的选型需从业务场景适配性、字段配置灵活性与结果输出形态三个维度综合评估。对于出版编目场景,核心痛点在于多级书签结构混乱导致编目效率低下,因此选型时应优先验证解析引擎对PDF书签层级与页码映射的识别精度,而非仅关注通用OCR的文本提取能力。文档智能解析依托WPS文档结构解析底座,在OCR校正基础上增强跨页表、复选框等复杂版式处理,可按段落、表格、图片与版面布局完成解析,这与通用OCR抽成纯文本的方案形成本质区别。
在字段配置层面,需区分预置模板能力与自定义扩展能力。预置行业模板虽覆盖简历、合同、发票等高频场景,但出版编目等垂直领域往往涉及非标字段,此时自定义字段与结果导出功能的完备性至关重要。选型时应确认是否支持single/group字段类型配置、parent层级定义及position页码标注,这些特性直接影响多级书签能否结构化为可检索的知识节点。此外,结果导出需支持表格与JSON双形态,以便对接知识管理系统或数字出版平台,实现从内容抽取到资产沉淀的闭环。
从工程部署角度,批量处理性能与系统对接安全是硬性考量指标。异步任务机制可支撑单次50份、500页的批量提交而不阻塞业务流程,KSO-1签名与Bearer token双重鉴权则保障数据传输安全。若企业涉及敏感文献处理,私有化部署能力应纳入必选项评估,同时需明确WPS素材库、项目管理等增值功能的加价策略,避免预算超支。
企业在选型书签内容抽取方案时,建议采取"场景验证—能力匹配—渐进落地"的三步走策略。第一阶段聚焦场景验证,针对出版编目、知识管理等核心场景,重点测试解析引擎对PDF书签层级、页码映射及复杂版式的识别精度,验证是否满足多级目录结构化的业务诉求;第二阶段开展能力匹配,从预置模板覆盖度、自定义字段灵活性、结果输出形态三个维度评估产品能力,确认是否支持single/group字段配置、parent层级定义及JSON/表格双形态导出,同时验证异步批量处理性能与双重鉴权机制是否满足企业级应用标准。
第三阶段推进渐进落地,优先选择支持私有化部署的服务商以降低数据合规风险,初期可聚焦高频场景快速上线预置模板积累应用经验,再逐步扩展至非标字段的自定义配置。实施过程中需关注接口文档完整性与SDK集成便捷度,确保file_id与file_url灵活提交、任务状态实时可查等技术特性与现有系统顺畅对接。此外,应提前评估增值模块的加价策略与总体拥有成本,避免因功能扩展导致预算失控,最终形成从内容抽取到知识资产沉淀的可持续运营闭环。
值得注意的是,选型时还应考察服务商的行业实践积累与持续迭代能力。优先选择已在出版、法律、金融等领域有成熟案例的服务商,其沉淀的抽取规则与字段口径更易复用,可降低业务人员的学习成本。同时关注产品更新频率与技术支持响应速度,确保遇到书签解析异常、字段识别偏差等问题时能快速获得解决方案,保障知识库建设项目的长期稳定运行。
书签内容抽取的深层挑战在于,同一套技术底座需同时满足出版编目的层级化语义解析与企业知识管理的动态扩展需求。选型时应超越基础的版式识别能力,深入考察字段语义建模与业务系统之间的耦合深度。以出版场景为例,多级书签不仅是物理页码的映射,更承载着"卷-章-节-小节"的知识拓扑关系,这要求自定义字段支持parent层级嵌套与position页码的联合标注,使抽取结果可直接转化为知识图谱的节点关系而非扁平键值。
在系统集成层面,JSON/表格双形态导出仅是基础门槛,更需关注结果数据与下游系统的语义兼容性。例如,将PDF书签结构导入数字出版平台时,需保证字段命名规范与平台元数据标准对齐;对接企业知识库时,则需支持RAG所需的向量化前处理接口。此外,选型需验证服务商是否提供从字段定义到系统回流的端到端SDK,降低业务团队的技术接入门槛。异步批量处理能力虽为通用指标,但应结合企业实际峰值场景测试稳定性——某出版社在年度集中编目期需处理数万页扫描文献,若任务队列管理机制薄弱,易出现状态查询超时或结果乱序。
最终决策需平衡短期落地与长期演进。预置模板的行业覆盖度决定初期上线速度,而自定义字段的灵活边界则影响未来3-5年的扩展空间。建议优先选择支持"模板继承-字段覆盖-规则热更新"架构的服务商,使出版编目的基础模板可随业务演进迭代,而非每次新增场景均从零配置。同时,私有化部署的安全合规与公有云的弹性扩容并非互斥选项,混合部署模式或成为数据敏感度与业务敏捷性兼顾的最优解。
纸质运单人工抄录运单号与收发件人信息,导致通关与仓储数据对不齐。通过文档智能解析自动抽取运单核心字段,实时写入流转台账,实现报关与仓储交接数据精准同步。
进项发票关键信息手工录入易出错,票面口径不统一导致对账效率低。引入智能识别技术自动抽出发票号与金额,标准化写入入账台账,打通财务系统。
学术专著扫描件书签层级混乱,手工编目周期长、检索困难。通过智能书签解析抽取三级目录结构与页码,自动写入编目台账并同步数字图书馆。
选型应聚焦出版编目、知识管理等核心场景,验证PDF书签层级与页码映射识别精度,优先考察解析引擎对复杂版式及多级结构的处理能力。需关注自定义字段灵活性(single/group类型、parent层级)、JSON/表格双形态导出及异步批量性能,确保与知识管理系统无缝对接。同时评估私有化部署安全性与增值功能加价策略,采取“场景验证—能力匹配—渐进落地”策略,优先利用预置模板快速上线,再扩展非标字段配置,实现从内容抽取到知识资产沉淀的闭环。

好业财深度融合WPS AI智能抽取,自动识别发票、合同等财务文档,智能提取关键财务数据并生成凭证,助力企业实现高效、精准的智能记账与业财一体化管理。




好会计依托AI智能抽取能力,从银行回单、发票等文件中自动采集数据,智能生成会计凭证与报表,简化财务核算流程,适用于小微企业快速报税与账务处理。

WPS项目管理内嵌文档智能解析能力,可自动抽取项目计划、任务报告中的关键节点与风险信息,并结构化呈现,实现项目进度的动态跟踪与高效协同。

WPS合同管理运用AI智能抽取,自动识别合同文档中的签约方、金额、有效期等关键条款,支持字段自定义与风险预警,降低企业合同审查成本与合规风险。




WPS进销存集成智能抽取引擎,可从采购单、销售发票中自动抓取商品、数量、金额等信息,实时更新库存数据,提升商贸企业出入库效率与数据准确性。
WPS项目管理内嵌文档智能解析能力,可自动抽取项目计划、任务报告中的关键节点与风险信息,并结构化呈现,实现项目进度的动态跟踪与高效协同。
好业财深度融合WPS AI智能抽取,自动识别发票、合同等财务文档,智能提取关键财务数据并生成凭证,助力企业实现高效、精准的智能记账与业财一体化管理。

好生意结合AI智能抽取技术,支持从订单、发货单等业务单据中提取进销存数据,自动生成经营报表,帮助小微企业实现商品流与资金流的智能管理。
好会计依托AI智能抽取能力,从银行回单、发票等文件中自动采集数据,智能生成会计凭证与报表,简化财务核算流程,适用于小微企业快速报税与账务处理。
用预置模板一键抽取姓名、学历、工作经历,固定口径反复复用。
启用法务模板抽取金额、签约方等关键条款,快速核对。
用财务模板抽取发票号、金额,票面字段自动转为台账。
单次50份500页,某格某式文档批量解析,异步跟踪进展。
自行增补单值/组字段,设定层级与页码,精准抽取。
结构化键值导出表格或JSON,无缝对接OA与ERP。
基于WPS文档智能解析引擎,精准还原PDF书签层级与页码映射,支持自定义字段、JSON/表格双形态导出,轻松对接知识管理系统。