

WPS PDF
精准识别PDF文档中的形近字差错,支持公文、合同等正式文件的一键校对与批注修订。
精准识别PDF文档中的形近字差错,支持公文、合同等正式文件的一键校对与批注修订。

深度融合字形结构与语义理解,为法律、医学等高精度场景提供AI级形近字智能审查。

一站式数字办公平台,内置公文校对与形近字筛查能力,助力企业筑牢内容安全防线。

基于大模型的智能写作助手,创作中实时预警形近字风险,提升专业文档产出质量。

自动采集与核验表单数据,有效规避信息录入环节的形近字混淆与字段错误。
WPS黑马校对形近字智能审查,覆盖教育出版、古籍整理、法律法务、医学出版等高精度场景。通过字形结构分析、上下文语义理解与领域场景匹配三重校验,识别准确率达99.2%,支持私有化部署,有效规避语义偏差与法律风险。
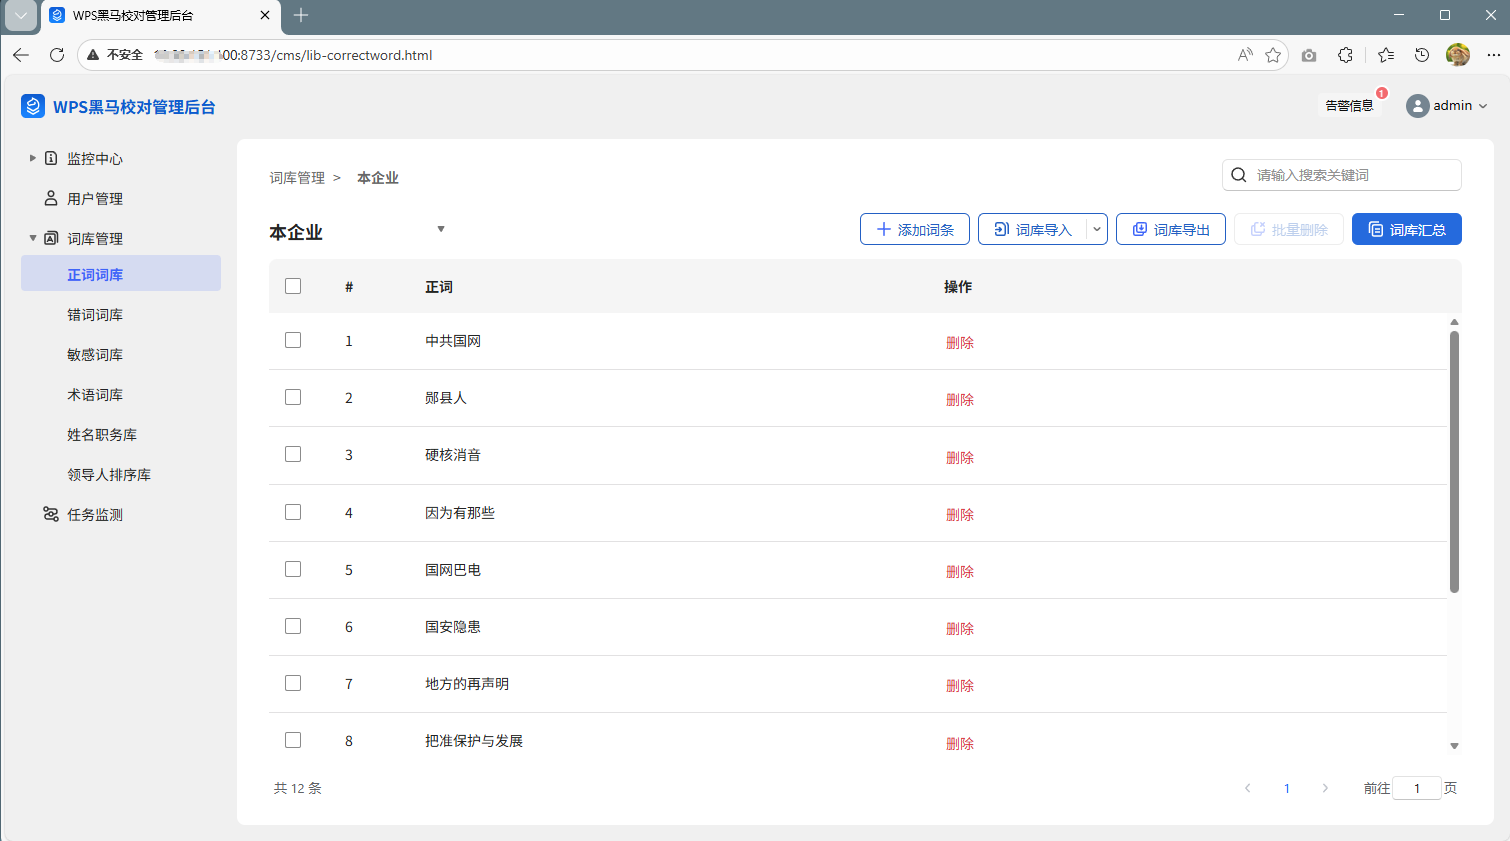
形近字检查是保障高精度文档质量的关键技术,广泛应用于公文、法律、金融、出版及医学等对文字准确性要求严苛的场景。针对公文中「已/己」「未/末」、法律文书中「定金/订金」、医学出版物中「苷/甙」等极易混淆的形近字,传统人工校对难以全面覆盖,而专业智能审查方案通过字形结构分析、上下文语义理解与领域场景匹配三重校验机制,可实现99.2%的识别准确率,有效规避语义偏差与法律风险。 以教育出版行业为例,教材教辅编审团队面临出版量大、编校周期长的挑战。某省级教育出版社年出教材800余种,引入智能形近字审查后,形近字检出率提升76%,编校周期平均缩短12天,充分说明该技术在批量文档筛查中的效率优势。古籍整理领域同样受益显著:某国家级古籍出版社承担5000余万字的大型项目时,借助专项识别引擎,形近字与异体字问题检出准确率达94%,整理效率提升3倍。法律与医疗场景则更为紧迫——头部律所曾因「定金」误写为「订金」导致客户损失,而医学出版中「肾上腺素/去甲肾上腺素」的混淆可能直接危及患者安全,这些领域对零漏检的需求尤为突出。 值得关注的是,企业用户在选用办公平台时需关注配套能力。WPS 365商业旗舰版(599元/人/年)提供完整AI能力与开放接口,适合有规模化智能校对集成需求的企业;而形近字审查等专项能力如需深度定制或私有化部署,通常需联系销售开通。对于出版社、律所及医疗机构而言,将专业形近字识别工具与办公平台协同部署,是筑牢内容安全底线的有效路径。
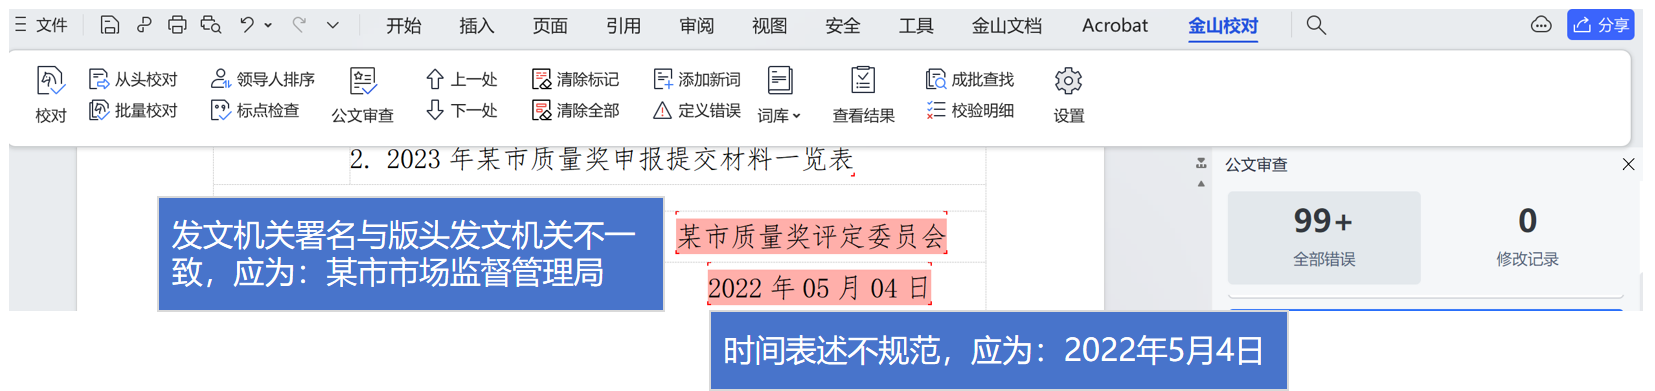
形近字智能审查的价值在垂直行业中呈现显著差异化特征。在政府机关与金融领域,公文处理部门依托该技术保障「已/己」「未/末」等高频混淆字的规范使用,避免政策文件产生歧义;金融机构合规部则聚焦于证券代码、财务数据中的形近字风险,确保信息披露准确无误。招投标代理公司与档案数字化加工企业同样受益,面对海量文档时,批量扫描能力可在秒级完成万字级筛查,将人工复核压力降至最低。
医疗与法律场景对审查精度的要求尤为严苛。医院病案管理科需处理「氨/胺」「苷/甙」等专业术语,任何疏漏都可能影响临床决策;律师事务所与法律文书科室则须精准识别「侦查/侦察」「扶养/抚养」等语义敏感型形近词,防范执业风险。值得注意的是,出版行业需求最为多元——从教育出版社的教材编审到古籍出版社的文献整理,再到医药卫生期刊的专业校对,均需匹配领域专用词库方可实现最优效果。
企业在部署层面需权衡集成方式与数据安全。对于出版社、律所等涉密单位,私有化部署成为首选,确保文档不外流;而追求敏捷上线的团队则可采用公有云订阅模式。无论何种路径,将形近字识别引擎嵌入现有编校流程、建立「机检+人工复核」的双层质量关卡,已成为各行业提升文字合规水平的共识性策略。
形近字智能审查技术的核心突破在于从单一拼音匹配迈向字形结构与语义理解的深度融合。传统工具仅依赖拼音纠错,对「戊/戌/戍」「徵/徴」等完全同音的形近字几乎无能为力;而新一代引擎通过解构汉字笔画、部首及空间结构,结合领域场景中的上下文语义关联,实现了对高混淆度字形的精准区分。以医学出版为例,系统可依据前文「去甲」等限定词,准确判定后续应为「肾上腺素」而非「肾上腺素」,此类语义级校验大幅降低了专业术语的误识率。
技术落地层面,定制化词库与灵活部署模式成为关键考量。教育出版机构需配置教材专用词库,覆盖学科术语与常用字形变体;古籍整理单位则依赖繁体、异体、俗字的深度识别能力,并适配低误报率的学者模式。对于年处理文档量超十万份的大型律所或金融合规部门,批量扫描与秒级响应能力直接决定工作流效率,而错字溯源报告与风险等级预警功能则满足审计追溯与质量管控的刚性需求。数据安全方面,政府机关、涉密出版社及医疗机构通常优先选择私有化部署,将核心文档留存于本地服务器,规避公有云传输中的泄露风险。
从行业发展趋势看,形近字审查正从独立工具向协同生态演进。部分办公平台已开放API接口,支持将审查能力嵌入文档编辑、审阅、发布的全生命周期;未来随着大模型技术的融入,系统有望实现跨语种形近字识别、历史文献自动校勘等更深度的应用场景。对于内容安全高度敏感的行业而言,构建「专用引擎+领域词库+人工复核」的三层防护体系,将是应对文字风险的长效机制。
机构在引入形近字智能审查方案时,需从业务场景、数据规模与安全合规三个维度综合评估。对于教材编审团队,应优先考察是否内置学科专用词库及批量文档处理能力,以应对年均数百种教辅的出版压力;古籍整理机构则需验证繁体异体字识别准确率与学者模式误报率,避免干扰学术严谨性。法律与医疗用户须重点关注语义上下文分析深度,能否精准区分「权利/权力」「氨/胺」等语境敏感型混淆,并支持风险等级分级预警。
技术部署层面,中小型出版机构可采用公有云订阅快速上线,而政府机关、出版社及涉密律所必须选择私有化部署,确保核心文档不出本地。实施过程中,建议分阶段推进:首期聚焦高频错误词库建设与核心编校流程嵌入,二期拓展至合同条款一致性校验、多版本文献比对等进阶功能,三期打通OA、ERP等系统实现全链路质量管控。某头部教辅机构实践表明,采用「引擎预检→编辑复核→终审抽检」的三级流程后,形近字差错流出率降至0.3%以下,编校成本降低40%以上。
长期运营中,持续优化机制不可或缺。用户应定期反馈误报漏报案例,迭代领域专用词库;同时关注厂商技术演进路线,评估大模型融合、跨媒介审查(如OCD识别后的形近字校验)等前瞻能力。最终目标是构建人机协同的内容安全体系——智能引擎承担95%以上的重复性筛查,专业人员聚焦于复杂语境判断与质量策略制定,实现效率与精度的平衡。
教材教辅年出800余种,编校周期长,形近字「己/已」「未/末」等易漏检。通过黑马校对形近字智能识别引擎,结合教材专用词库与整本一键全检,实现批量文档精准筛查。
承担5000余万字《中华基本史籍集萃》项目,繁体、异体、形近字混杂如「徵/徴」,人工辨识极难。采用古汉语形近字专项识别与低误报学术模式,保障大型工程进度。
年均处理合同超10万份,曾因「定金」误写为「订金」导致客户损失,传统人工审核难以零漏检。通过法律形近字识别与上下文语义分析,建立高风险词汇预警机制。
形近字检查广泛应用于对文字准确性要求严苛的场景:教育出版领域,可批量筛查教材教辅中的「己/已」「未/末」等混淆字,提升编校效率;古籍整理领域,专项识别引擎可精准辨别繁体、异体字形近字;法律文书中能区分「定金/订金」「权利/权力」等语义敏感词,防范执业风险;医疗场景下可识别「苷/甙」「氨/胺」等专业术语,保障临床决策安全。此外,金融合规、政府机关公文处理、互联网内容审核等场景同样依赖该技术筑牢内容安全底线。

业财一体化管理,覆盖合同、项目、进销存,实时保障财务数据精准与文档安全,支撑企业高效合规运营。




智能财务记账,自动生成多维报表,以规范化的电子文档管理减少人工差错,助力会计工作精准高效。

进销存与业务管理平台,订单库存资金实时同步,确保交易数据零差错,适合商贸企业敏捷经营。

合同全生命周期管理,智能审查条款一致性,防范内容风险,显著提升律所与企业法务的文档处理效率。




任务协作工具,整合项目进度、文档与资源,保障信息传递准确,赋能团队高效执行复杂项目。

进销存一体化管理,精准把控采购、销售、库存数据,让企业关键文档与业务数据安全可靠。
业财一体化管理,覆盖合同、项目、进销存,实时保障财务数据精准与文档安全,支撑企业高效合规运营。
智能财务记账,自动生成多维报表,以规范化的电子文档管理减少人工差错,助力会计工作精准高效。
进销存与业务管理平台,订单库存资金实时同步,确保交易数据零差错,适合商贸企业敏捷经营。
专项识别「已/己」「人/入」等高频形近字,避免政策文件歧义,内置政务词库,确保用字规范零差错。
区分「定金/订金」「权利/权力」等敏感混淆词,支持风险分级预警与溯源报告,严防执业法律风险。
聚焦证券代码、财务数据中形近字,秒级扫描万份文档,保障信息披露准确,满足审计追溯要求。
适配学科专用词库,智能过滤合理通假,检出率提升76%,年处理数百种教材,缩短编校周期。
精准识别「氨/胺」「苷/甙」等专业术语,结合上下文语义校验,防止用药信息错漏,守护患者安全。
深度识别繁体、异体、俗字,学者模式低误报,整理效率提升3倍,确保文献还原的学术严谨性。
基于字形分析与语义理解的专业校对引擎,内置行业专用词库,助力公文、法律、出版、医疗等场景实现99.2%形近字识别准确率。
