

AIPPT
AI智能生成PPT,输入主题一键出稿,多音字校对保障文案精准,演示更专业。
AI智能生成PPT,输入主题一键出稿,多音字校对保障文案精准,演示更专业。

统筹编审任务进度,多音字审校流程可视化追踪,团队协作高效无忧。

重要文件安全收发,支持多音字标注稿传输,保障出版机构信息安全。

多音字审校数据结构化呈现,读音规范库统一管理,知识资产沉淀复用。

全场景办公解决方案,AI赋能多音字智能校对,赋能出版、政务、教育高效协同。
WPS黑马校对多音字检查功能依托《现代汉语词典》等权威规范,通过上下文语义智能识别多音字正确读音,解决出版印刷、语音合成、教育教材等领域多音字误读问题。支持自定义读音词库、批量文档处理与团队读音规范统一,适配广播电视、出版社、AI语音企业等多场景,准确率超95%。
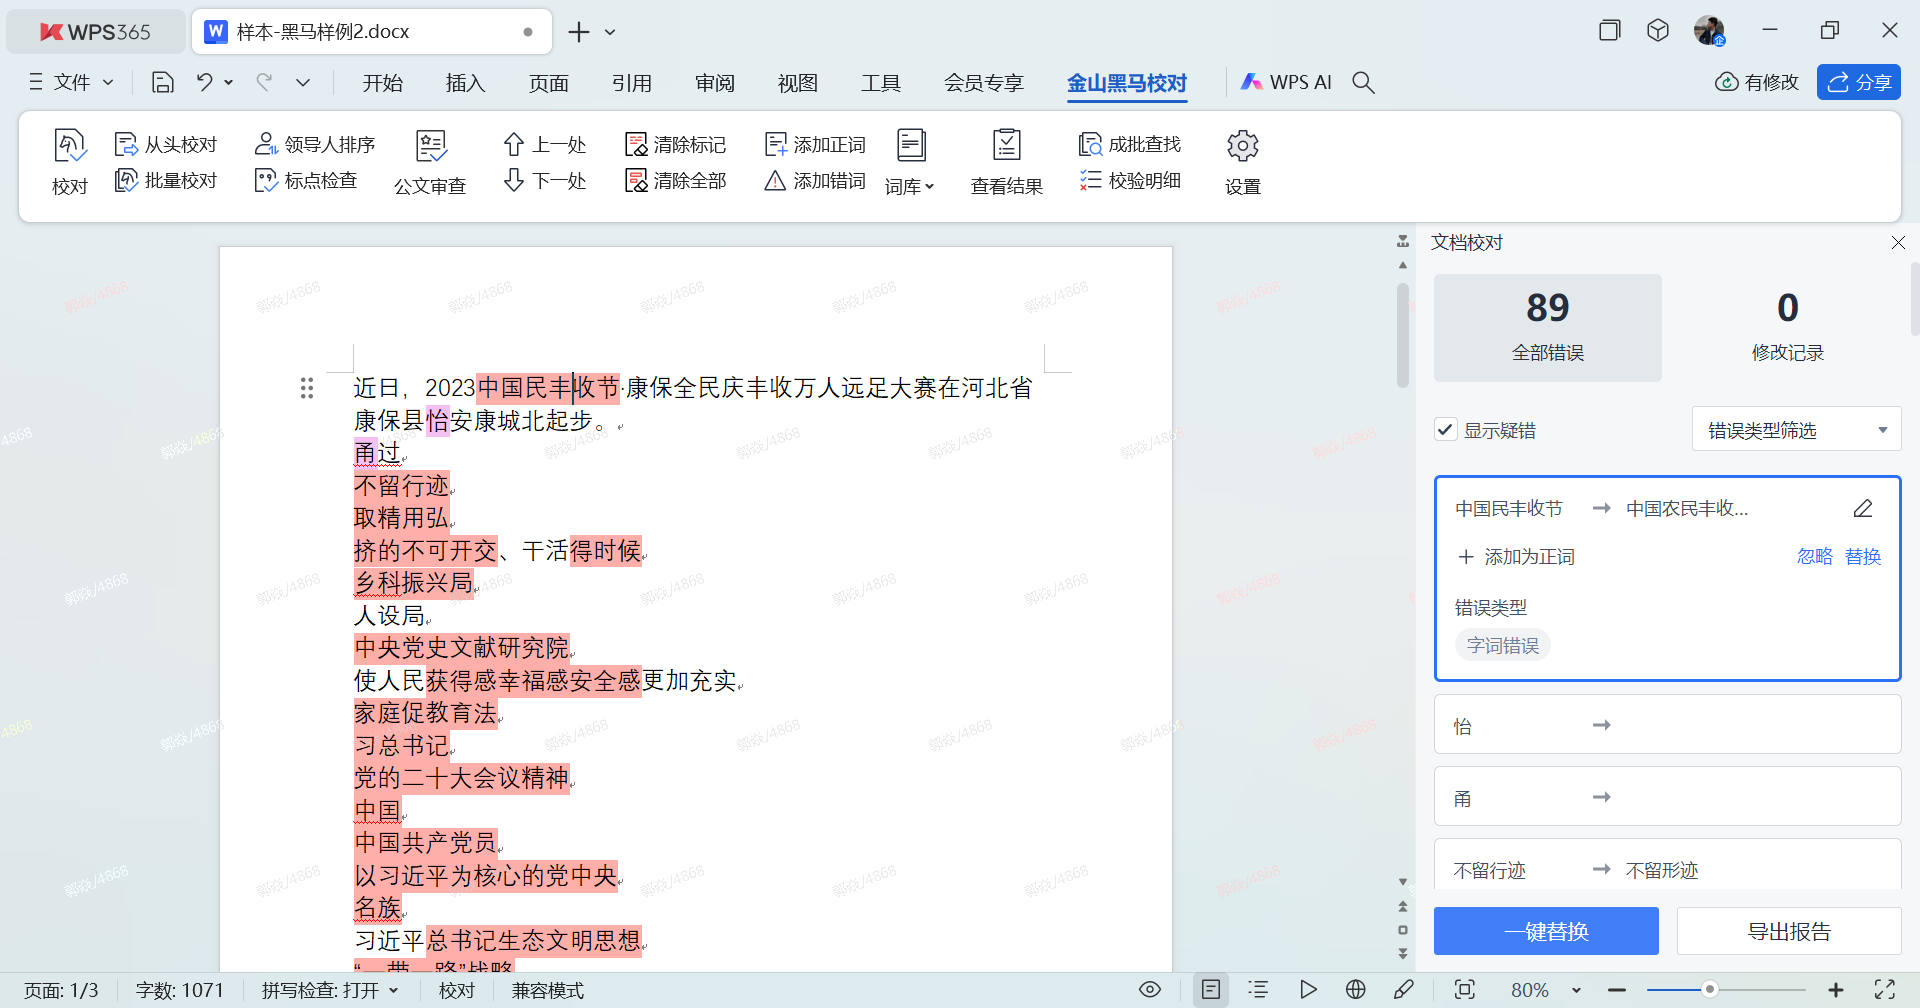
多音字检查能解决什么问题?这一核心痛点贯穿出版印刷、语音合成、教育教材等多个专业领域。在广播电视行业,节目字幕与配音脚本中的多音字误读可能直接导致播出事故,而人工逐字审核耗时费力、难以满足紧张的录制周期;在教育出版领域,语文教材注音的规范性关乎教学公信力,传统编审模式下百万字级书稿的审校周期往往长达数月。依托《现代汉语词典》《普通话异读词审音表》等权威规范,黑马校对的多音字智能校对功能通过上下文语义自动识别多音字正确读音,突破简单规则匹配的局限,实现语境化智能判别。
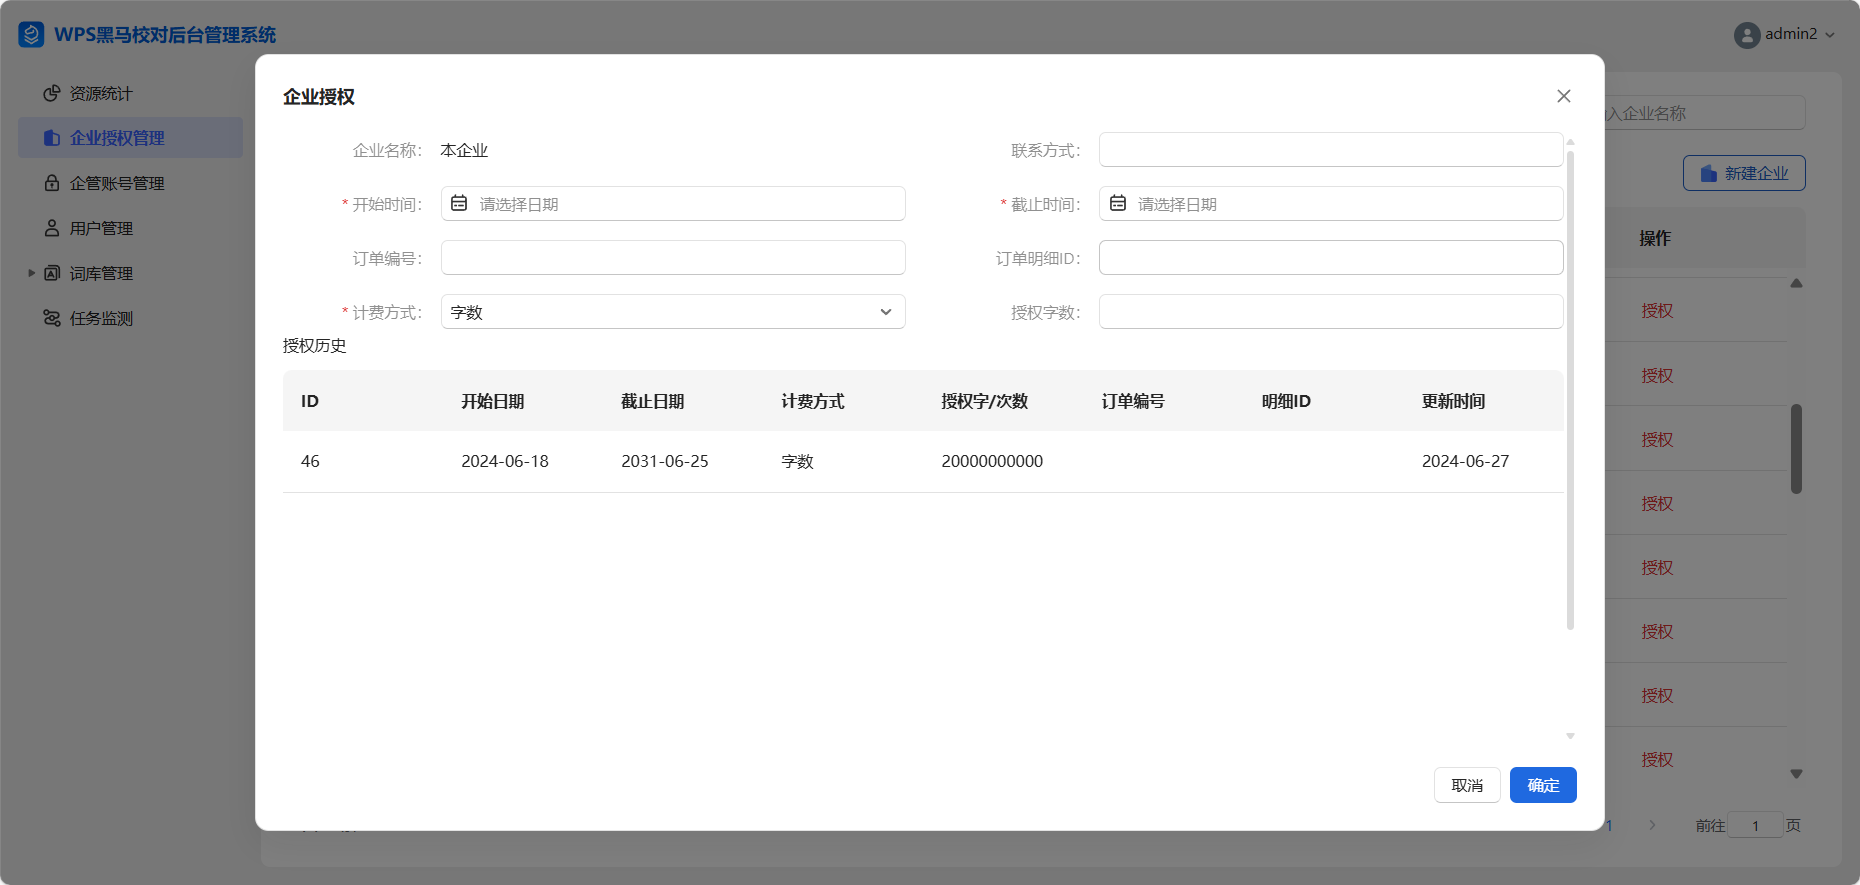
该功能覆盖出版印刷、人工朗读、语音合成全场景,既能对接出版社拼音标注规范需求,也可作为TTS训练前的预检环节,提前拦截发音错误、降低后期制作成本。针对企业专有名词、生僻人名地名等特殊读音,系统支持自定义读音词库锁定,并通过批量文档处理能力一次性完成全书或全稿的多音字排查。值得注意的是,WPS 365各档套餐中,体验版与商业协作版无WPS Office授权,商业高级版可在Windows和Linux版授权中二选一,商业旗舰版则同时提供双系统授权并支持完整AI能力与开放接口,企业可根据Office授权需求、存储空间及AI功能要求进行选择。对于古籍整理、地方志编纂等特殊场景,多音字批量精校与知识沉淀功能还支持古今读音对照标注与审校决策留痕,将专家经验转化为可传承的机构知识资产。
在人工智能语音交互领域,多音字处理始终是制约用户体验的关键瓶颈。TTS训练数据标注成本高昂,方言与专有名词场景下多音字识别准确率常出现断崖式下降,合成语音的机械感严重影响产品竞争力。黑马校对面向AI训练场景提供大规模语料清洗与读音标注服务,训练语料多音字标注准确率达97%,可降低人工标注成本80%,通过专有名词读音定制与方言区多音字适配,助力语音交互产品实现自然人声突破。
针对公共广播与城市服务场景,地铁机场播报读音不准将直接损害城市形象,法律文件中多音字歧义更可能引发严重理解偏差。多音字与朗读规范综合审校功能集成检测与规范审校能力,可自动标注文档中所有多音字并生成播音提示稿,支持团队共享读音规范库消除地域差异。与标点格式模块联动后,更能同步规范拼音标注符号与排版格式,实现端到端的文档级解决方案,覆盖从录制前发音预检到播出风险预警的全流程。
对于古籍出版社、央国企文宣部等机构,海量历史文档的多音字治理与知识传承尤为重要。多音字批量精校与知识沉淀功能支持百万字级存量文档回溯扫描,建立机构专属多音字知识库,自动沉淀校对记录与决策依据。API开放能力可嵌入企业OA、CMS、编审系统,实现工作流自动化,将分散的专家经验转化为可迭代传承的机构资产,从底层支撑内容权威性与传播准确性的长期保障。
在基础教育与对外传播领域,多音字的规范使用直接关系文化传承与国际形象。中小学语文教材中,同一多音字在不同学段的呈现梯度、经典篇目的古今读音取舍,稍有不慎便引发社会舆论争议;对外汉语教材中,多音字注音混乱更会误导学习者形成错误的语音习惯。黑马校对面向教育场景打造分级标注体系,严格对标《普通话异读词审音表》及部编版、人教版等版本差异,实现小学至高中全学段的多音字智能适配。
该功能支持百万字级教辅书稿的批量注音审核,将传统数月的编审周期压缩70%以上,同时提供语音朗读一致性校验,确保数字化教材与有声读物的读音准确同步。针对海外汉学研究与中华文化走出去战略,系统兼容历代音韵演变查询与繁简转换中的多音字自动适配,以权威规范的读音标准提升国际学术话语权,让多音字从教学难点转变为文化传播的精准支点。
机构用户可通过专家审定协同平台建立跨团队读音规范库,将编审专家的判定经验沉淀为可追溯的知识资产,即便人员更替也能保障多音字审校标准的连续性与权威性,从根本上化解教育出版领域"人走经验散"的行业困境。
在品牌传播与政务公开领域,多音字误读往往成为损害机构专业形象的隐性风险点。企业宣传片中的品牌名、创始人姓名若读音标注混乱,将直接削弱品牌公信力;政府机关、央国企在重大会议发布、政策解读中,领导人姓名、行政区划名称的特殊读音一旦出现偏差,更可能引发舆论关注。黑马校对针对这一痛点,提供企业专有名词与政务敏感读音的定制化锁定服务,通过自定义读音词库将品牌标准发音、官方审定读音固化为机构级知识资产,确保对外传播中的读音统一与权威。
该功能深度适配大型集团品牌部、连锁机构总部及少数民族地区政务部门的多场景需求。连锁企业的全国门店广播、产品说明需保持读音高度一致,而跨区域团队常因方言影响对同一多音字产生认知分歧;少数民族地区政务部门在双语或多语环境中,地名、机构名的规范读音更显关键。系统通过团队共享读音规范库与审校决策留痕机制,将分散在各地的品牌管理人员、播音员、审核岗纳入统一协作流程,自动沉淀校对记录与决策依据,从根本上消除地域差异与人员流动带来的标准波动。
从技术实现层面,该模块支持与企业OA、CMS、编审系统的API级对接,实现工作流自动化嵌入。无论是新闻某稿某发布前的批量预检,还是历史存量文档的回溯勘误,均可通过私有化部署保障数据安全。对于需同时满足效率与合规双重需求的机构而言,这一方案将多音字审校从被动纠错转向主动防控,以标准化、可继承的技术能力支撑品牌资产与政务形象的长期建设。
面对直播与录播中字幕、配音脚本多音字频发,引入智能多音字识别与语音校对系统,自动标注风险读音并生成播音提示,实现从录制前预检到播出端预警的全流程闭环。
教辅与教材书稿动辄百万字,人工审校多音字注音工作繁重且周期长。通过部署分级标注与批量审核系统,自动识别不同学段读音规范并一次性完成全书多音字排查。
TTS训练中多音字标注成本高、覆盖不全导致合成语音机械。利用智能语料标注服务进行大规模读音清洗与专有名词适配,内嵌API实时校对。
黑马校对多音字检查依托权威规范与AI技术,通过上下文语义识别突破规则匹配局限,精准解决出版印刷、语音合成、教育教材等领域多音字误读痛点。该功能覆盖TTS训练预检、广播电视播报、古籍整理等全场景,支持自定义词库锁定特殊读音与批量文档处理,可大幅缩短编审周期、降低人工标注成本。典型案例显示,其多音字识别准确率达95%以上,能显著提升内容权威性与传播准确性,并将专家经验转化为可传承的机构知识资产。

WPS 合同管理集成多音字智能审校能力,自动识别合同文本中的异读词,确保条款表述无歧义,规避法律风险,提升合同签署与归档的专业规范性。




WPS 进销存支持单据与产品说明的批量多音字校对,帮助连锁零售企业统一物品读音规范,减少门店语音播报和标签注音的差错。

好会计内置黑马校对引擎,可对财务报表、凭证备注中的多音字进行语境化审校,保障财税文档的准确性与合规性,降低人工复核成本。
WPS 合同管理集成多音字智能审校能力,自动识别合同文本中的异读词,确保条款表述无歧义,规避法律风险,提升合同签署与归档的专业规范性。
WPS 进销存支持单据与产品说明的批量多音字校对,帮助连锁零售企业统一物品读音规范,减少门店语音播报和标签注音的差错。

WPS 项目管理融合文档审校模块,可对项目文书、汇报材料进行多音字排查,保障跨团队沟通中命名、术语读音的一致性,沉淀机构知识资产。

好业财支持业务单据与商业文档的多音字批量校对,避免因读音歧义导致的业务差错,适合连锁经营与公共服务机构使用。




好生意配备黑马校对能力,可快速检查商品描述、营销文案中的多音字误读,助力品牌传播中读音统一,维护企业专业形象。
好会计内置黑马校对引擎,可对财务报表、凭证备注中的多音字进行语境化审校,保障财税文档的准确性与合规性,降低人工复核成本。
上下文智能判别多音字读音,批量审核教辅书稿注音,压缩编审周期70%以上。
录制前自动筛查语音稿多音字,生成播音提示稿,避免棚内返工与播出事故。
自定义品牌名、人名、地名读音词库,确保对外传播中发音统一与权威。
集成播报规范审校,消除地铁机场等场景多音字误读,维护城市形象。
回溯扫描百万字级存量文档,批量修正多音字错误,满足审计与质检要求。
自动记录审校决策与依据,将专家经验转化为可传承的机构读音资产。
基于权威词典与语义判别,实现多音字全场景智能审校,覆盖出版、教育、品牌传播,支持自定义词库与批量精校,将专家经验沉淀为机构知识资产。
