

WPS AI 企业版
集成多音字智能辨析与文档校对能力,支持自定义读音库与合规检测,助力出版、新闻等行业实现精准文字规范与高效内容生产。
集成多音字智能辨析与文档校对能力,支持自定义读音库与合规检测,助力出版、新闻等行业实现精准文字规范与高效内容生产。

支持创建读音规范采集表单,快速收集团队多音字使用反馈与术语标准,实现私有词库的动态更新与维护。

搭建多音字审核项目管理看板,追踪百万字书稿校对进度,管理自定义词库与分级权限,实现出版流程数字化管控。

内置智能写作助手,在公文写作与新闻采编中实时检测多音字、政治性差错,确保对外沟通内容的专业性与合规性。

支持多人实时审校与批注留存,实现"三审三校"流程线上化,确保多音字修订痕迹可追溯,提升团队内容审核效率。
WPS黑马校对多音字辨析功能使用指南,解决教材教辅、新闻出版中多音字语境判断错误难题。提供AI智能语境分析(准确率95%以上)、自定义读音库、合规检测三大模块,支持批量处理与TTS预检,覆盖3000余常用多音字,校对效率比人工提升90%,一键生成合规报告满足教育出版与广告语言文字规范审查需求。
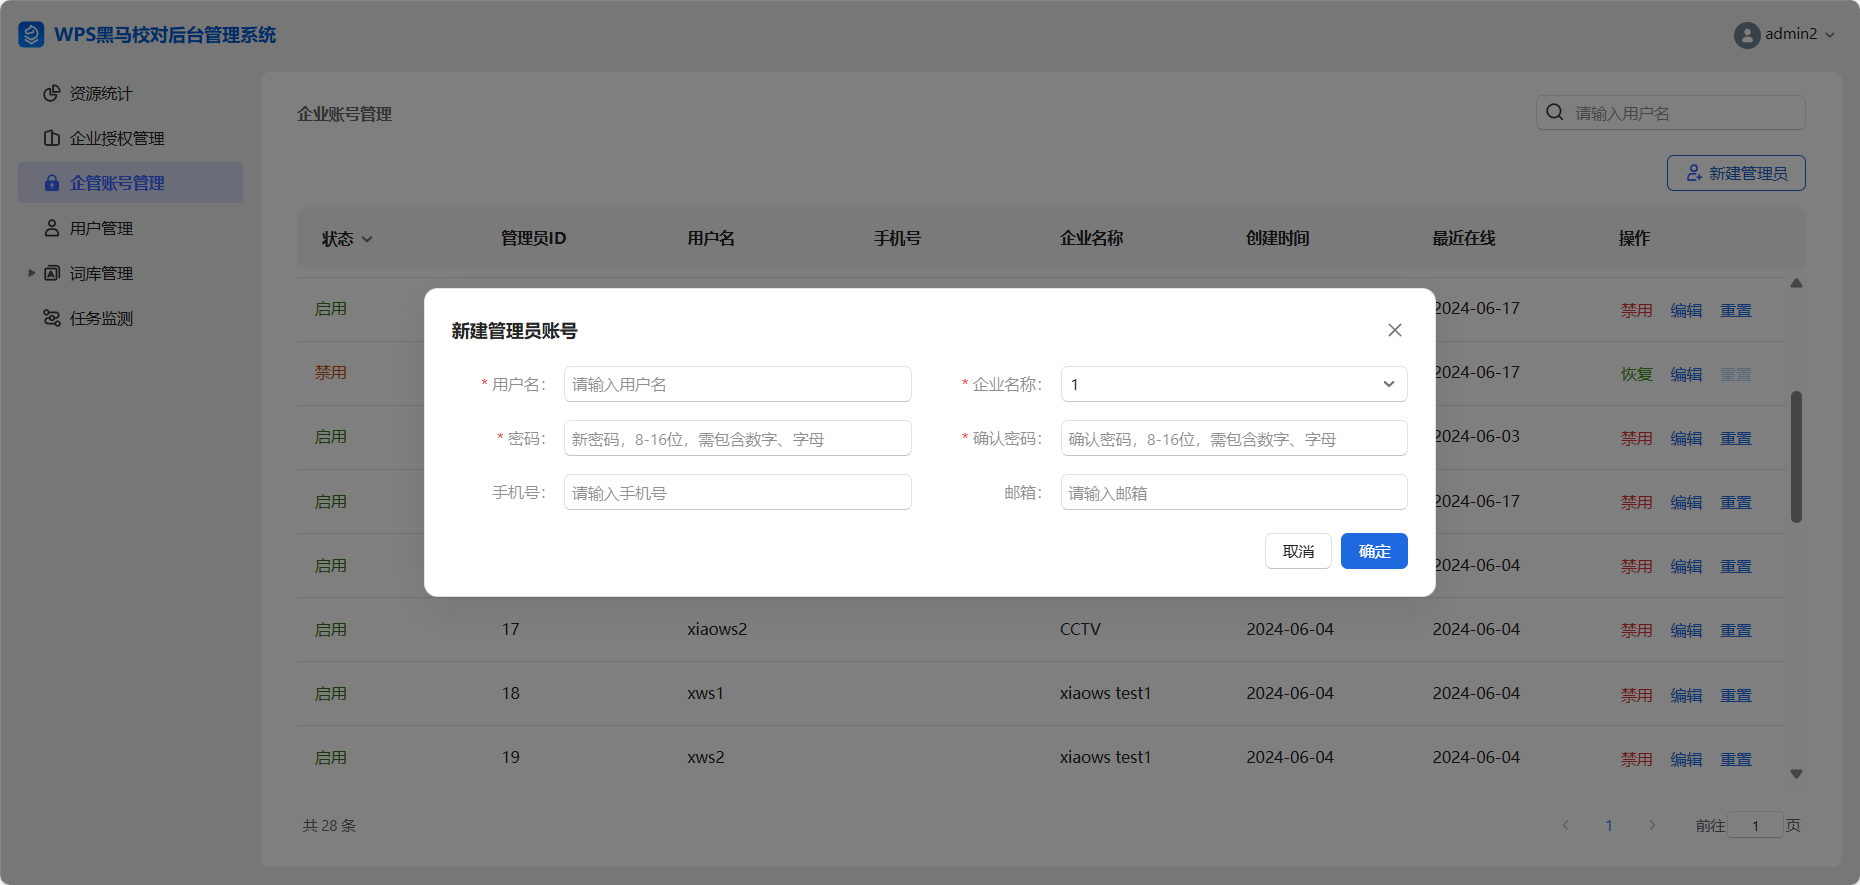
对于初次接触多音字智能辨析的用户,建议从基础配置开始逐步深入。在WPS文档校对界面勾选"多音字检查"选项即可开启功能,系统会自动标出疑似多音字并给出读音建议。新手可先使用系统内置的通用规则进行校对,通过输入"他长大了"等测试句验证效果,熟悉后再根据业务需求调整敏感度。针对长文档,系统采用流式处理架构,即使百万字书稿也能在数分钟内完成读音校核,且支持批量汇总与一键替换。
深入应用时,可结合三大核心模块提升专业度。智能语境校对模块依托《普通话异读词审音表》和深度学习模型,能自动分析"长""行"等字在上下文中的正确读音,覆盖3000余常用多音字;自定义读音管理模块允许企业建立私有读音库,统一品牌术语、人名地名的特殊发音标准,支持批量导入与分级权限管控;知识性与合规检测模块则严格对接国家语委标准,智能拦截地名、姓氏及成语典故中的读音错误,满足教育出版与广告合规审查需求。无论是教材教辅出版中的拼音标注一致性检查,还是新闻采编中的政治性人名地名审核,抑或是辞书编纂中的古今异读辨析,均可通过自定义词库与专用语料库实现精准校对。
需要注意的是,多音字辨析及相关高级校对功能可能涉及特定服务档位或需单独开通,企业用户可根据实际业务规模与合规需求,选择适合的服务版本或联系销售获取详细方案,部分专业模块如TTS预检、云端分级管控等可能需要额外配置。
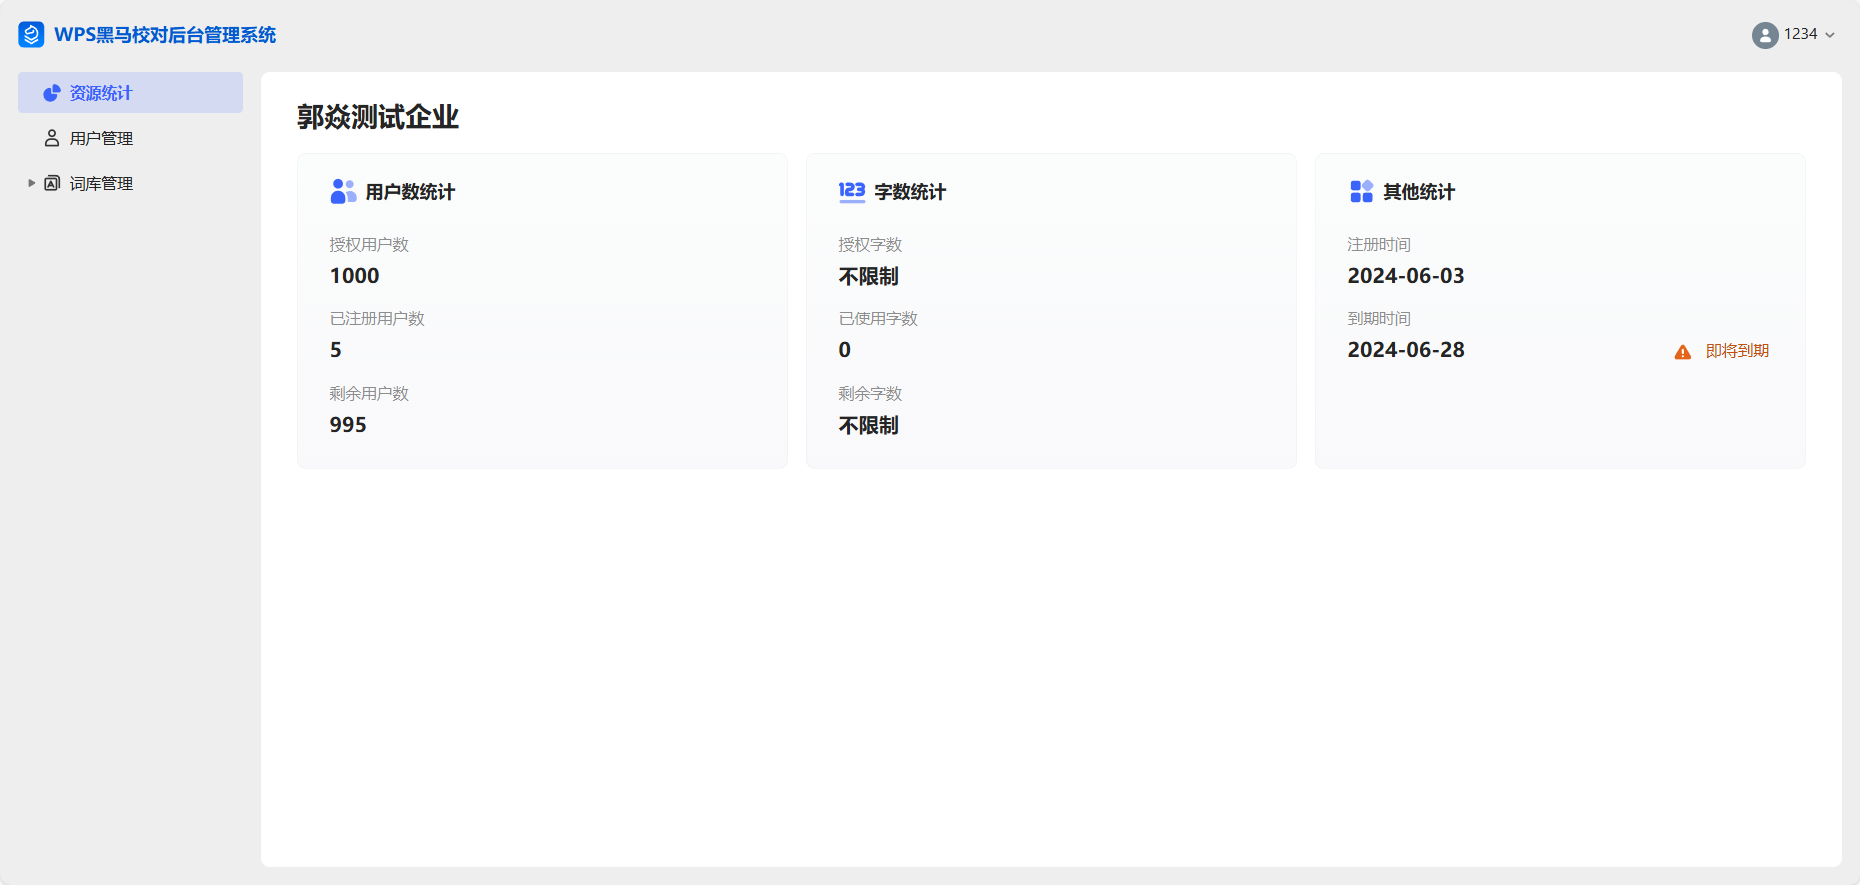
掌握基础开启方法后,精准辨析的关键在于自定义配置与场景适配。针对企业专有名词、品牌术语或特殊人名地名(如“盛”大读shèng、“单”姓读shàn),可进入用户词库管理中的“多音字词库”,添加特定语境下的读音绑定规则,支持批量导入与分级权限管控,避免专业术语被通用规则误改。若需兼顾效率,可在校对设置中灵活开关“多音字检查”选项;若面向语音合成场景,建议联动TTS预检功能,在生成音频前拦截“乐”“行”等字的读音错误。
长文档处理建议采用批量汇总模式,系统基于流式架构可在数分钟内完成百万字书稿的读音校核,校对完成后一键生成规范报告,并导出带批注的WPS版本保留修订痕迹,便于多人协作复核。不同行业上手侧重点各异:教育出版需重点关注“得”“地”“着”等助词与《审音表》合规性,利用教材专用词库确保拼音标注零差错;新闻采编应优先加载时政人名地名库,防范“解”“查”等姓氏误读风险;少儿读物编创则需开启低幼龄语料过滤,针对“好”“兴”等儿童易混字优化提示方式。
新手可通过输入“他长大了”等测试句验证上下文分析效果,系统基于深度学习模型自动区分“长”cháng与“长”zhǎng,综合准确率达95%以上。建议根据常见误报动态调整敏感度,逐步优化校对体验,确保从基础使用到专业审校的平滑过渡。
尽管系统综合准确率达95%以上,但针对地名、姓氏及成语典故等知识性多音字(如"番禺"读pān、"单"姓读shàn、"暴虎冯河"读pù),仍需建立人工复核机制。建议对生成的读音规范报告进行抽检,特别是对领导人姓名、历史地名、专业术语等高风险区域进行二次确认,利用"一键生成合规检测报告"功能实现出版审校留痕,满足教材教辅三审三校与广告法语言规范审查的合规要求。
企业应建立动态词库维护机制,定期将业务中积累的专有名词(如品牌术语、内部称谓)通过批量导入功能更新至私有读音库,支持主流TTS引擎读音标记格式导出。通过多级权限管理实现集团内读音标准统一,避免分支机构各自为政导致的读音混乱,形成组织级语言规范资产。
针对有声书制作与语音合成场景,建议启用TTS预检功能,在音频生成前拦截"乐""行"等字的语境误读,实现"文本-拼音-语音"三重校验。结合批量处理与批注导出功能,可将多音字修订痕迹完整保留至WPS文档,便于编审团队追溯核查,真正实现从智能识别到规范落地的全流程质量管控。
对于希望快速上手的团队,建议先对标行业标杆实践。教育出版机构可参考直属教材出版社的年处理3亿字经验,重点配置"得""地""着"等高频助词库与《审音表》合规检测;新闻出版团队应借鉴中央级日报社的时政词库建设,优先导入领导人姓名、重要地名读音规则,确保政治性差错零发生;辞书编纂单位则可学习国家级辞书出版中心的古今异读对照模式,建立学术读音自定义规则。通过复用这些经过验证的行业模板,新用户可在1-2周内完成基础环境适配,避免从零摸索的试错成本。
在借鉴基础上,需建立内部知识沉淀机制。建议成立由语言专家、业务骨干和技术支持组成的"读音规范会",定期将校对过程中发现的专有名词、生僻地名、新兴科技术语等通过批量导入功能更新至私有读音库。针对跨地域集团企业,可利用多级权限管理功能,确保总部与分支机构的读音标准统一,避免"盛"大、"行"家等品牌术语在不同区域读音混乱。同时建立"误读案例库",将人工复核中发现的系统性错误(如"番禺""蚌埠"等地名误读)转化为培训教材,形成组织级语言规范资产。
最终形成"机器初校-专家复核-知识入库-持续优化"的闭环。建议每季度生成多音字合规检测报告,分析"单""解""查"等姓氏及"暴虎冯河"等成语的误读趋势,针对性调整AI模型敏感度。对于有声书、TTS合成等语音输出场景,应建立"文本-拼音-语音"三重校验样本库,将黑马校对的读音标注与实际语音输出进行比对校准,确保智能辨析准确率从95%向更高标准持续精进,真正实现从工具使用到规范治理的能力跃升。
小学语文教材中“得”“地”“着”等高频多音字错误频发,人工核查难以全覆盖。引入黑马校对多音字辨析功能,自动识别上下文读音错误,嵌入审校流程实时提示,实现拼音标注一致性检查。
时政新闻中领导人姓名、重要地名等多音字(如“单”“解”“查”)误读风险高,夜间排版时间紧,人工逐字核查困难。全面部署黑马校对多音字辨析系统,加载时政词库,实现毫秒级实时校对与政治性敏感检查。
百科绘本中“行”“重”“间”等儿童易混多音字,拼音标注与图文对应核对繁琐,易影响儿童语言习得。应用黑马校对多音字辨析,自动校验绘本拼音标注,结合低幼龄语料过滤,精准识别2000余处错误。
在WPS校对界面勾选"多音字检查"开启功能,新手建议先用系统内置通用规则,通过"他长大了"等测试句验证上下文分析效果,熟悉后再调整敏感度。不同行业需针对性配置:教育出版重点关注"得""地""着"等助词与《审音表》合规,新闻采编优先加载时政人名地名库,少儿读物启用低幼龄语料过滤。进阶时可建立私有读音库,批量导入品牌术语、生僻地名等专有名词,配合分级权限实现集团标准统一。长文档采用流式处理,支持批量汇总与一键替换,但对地名、姓氏及成语典故建议人工复核,形成"机器初校-专家复核-知识入库"的闭环,逐步提升校对准确率。

智能财务软件,提供记账、报表、税务管理,与WPS文档协同,确保财务数据准确,适合小微企业。




项目计划、任务分配、进度跟踪,支持团队协作,与WPS Office无缝集成,高效管理项目文档。

库存、采购、销售一体化管理,实时数据同步,助力中小企业精细运营。
智能财务软件,提供记账、报表、税务管理,与WPS文档协同,确保财务数据准确,适合小微企业。

进销存管理工具,支持多仓库、多计量,简单易用,帮助生意人管好货、算清账。

智能云财务,自动生成凭证报表,支持多端同步,让会计工作更高效。

合同创建、审批、归档,电子签章,保障合同安全,与WPS文档深度集成,提升法务效率。



项目计划、任务分配、进度跟踪,支持团队协作,与WPS Office无缝集成,高效管理项目文档。
库存、采购、销售一体化管理,实时数据同步,助力中小企业精细运营。
输入“他长大了”等测试句,体验AI语境分析,验证多音字辨析效果,快速熟悉系统。
基于《审音表》检测“得”“地”“着”等助词,确保拼音标注零差错,生成合规报告。
加载领导人姓名、重要地名库,防范“解”“查”等姓氏误读,实现政治性差错零发生。
启用TTS预检,提前拦截“乐”“行”等语境误读,实现文本-拼音-语音三重校验。
自定义私有读音库,强制统一“盛”大、“行”家等品牌术语读音,支持批量导入。
智能检测成语、地名人名等多音字误读,拦截违规读音,满足广告法语言规范审查要求。
依托深度学习模型,覆盖3000+常用多音字,支持自定义词库与行业模板,流式架构快速处理百万字书稿,满足出版、新闻、教育等场景的审校与合规需求。
