

WPS 邮箱
支持公文级邮件合规检查,自动识别正文成语误用与敏感表述,确保政务及商务通信严谨准确,维护机构专业形象。
支持公文级邮件合规检查,自动识别正文成语误用与敏感表述,确保政务及商务通信严谨准确,维护机构专业形象。

AI实时协作创作时自动拦截成语误用与语义重复,内置百万级语料库智能提示,让团队文档从起草即符合出版级语言规范。

集成黑马校对引擎的企业级办公平台,为出版、教育、政务机构提供从成语合规到格式规范的全链路内容安全风控体系。

依托百万级成语语料库与语义分析技术,精准识别近音形近混淆、褒贬误用及对象错配,系统性解决多领域语言规范问题。

智能代码辅助同时支持技术文档成语规范检查,确保开发文档、学术论文中的中文表达严谨专业,避免技术术语与成语混用。
WPS黑马校对成语误用检查功能依托百万级权威语料库与语义分析技术,精准识别褒贬误用、对象错配、语义重复及谐音篡改等问题。适用于教育出版、新闻政务、学术期刊及广告合规场景,自动检测"不孚众望"与"不负众望"等易混成语,防范政治性表述风险与教学误导,提升审校效率60%以上,确保文本符合《现代汉语词典》及广告法规范,保障机构公信力与内容权威性。
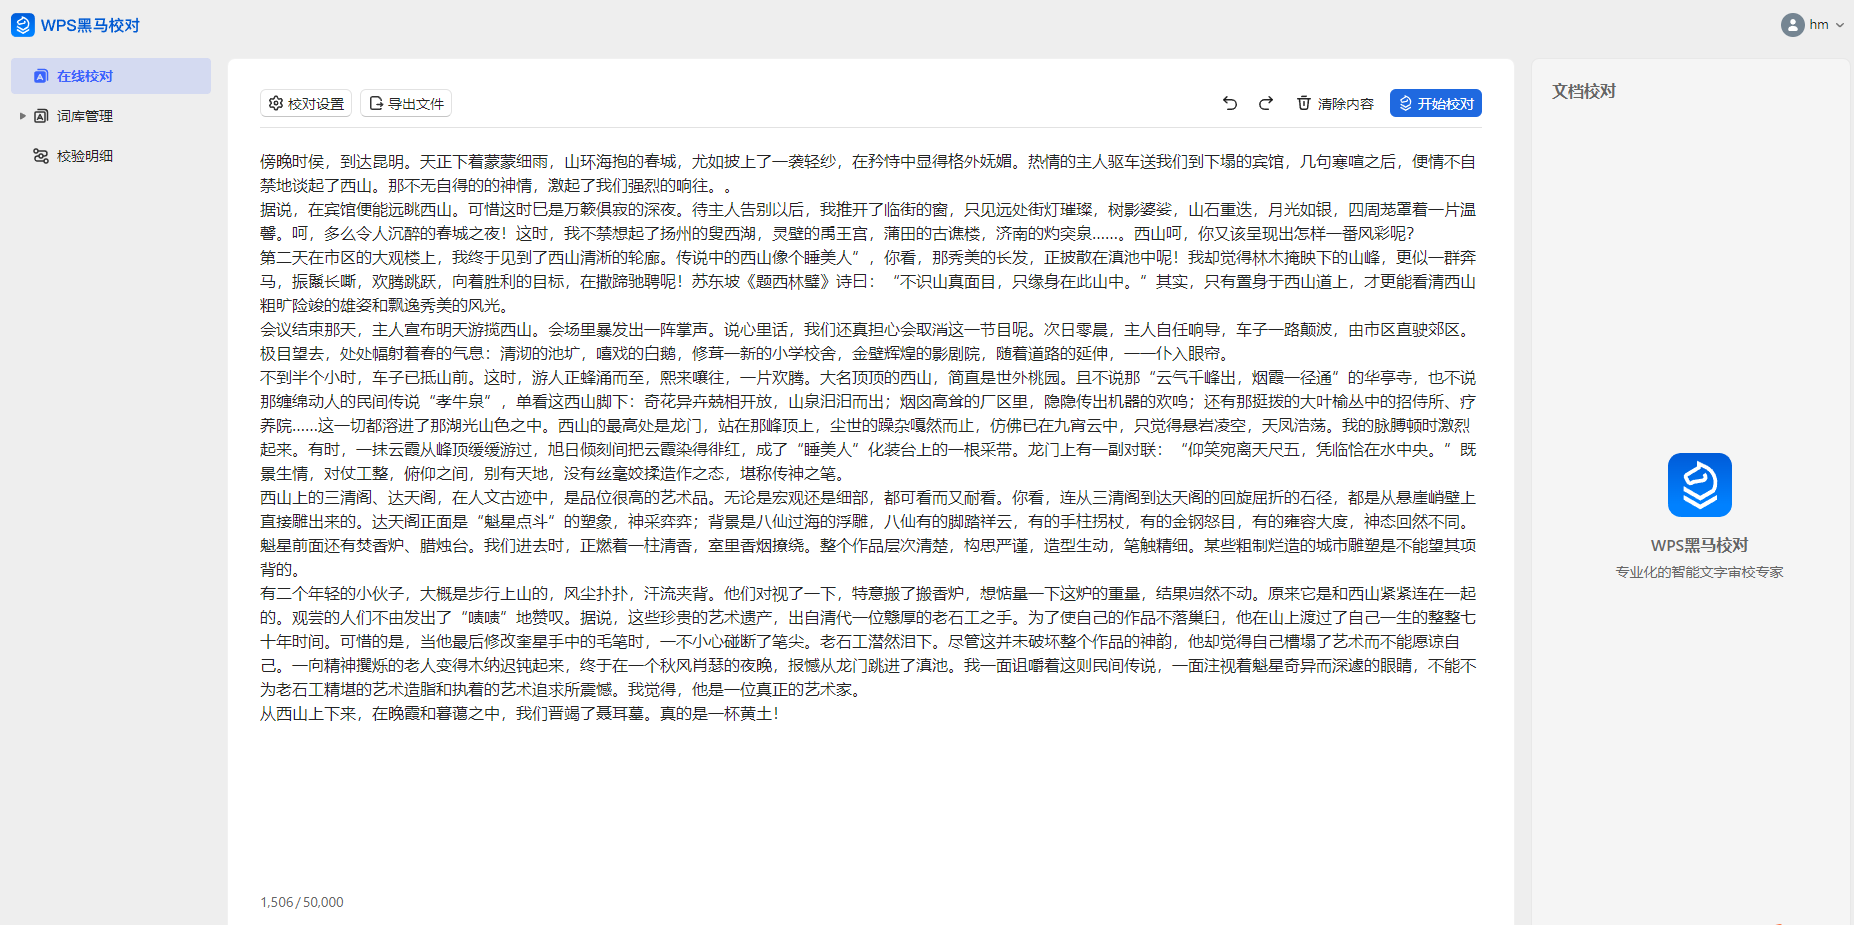
成语误用检查依托WPS黑马校对V31的百万级成语语料库与语义分析技术,能够系统性解决媒体、出版、教育及公文写作中的多维度语言规范问题。该功能不仅精准识别"不孚众望"与"不负众望"等近音形近混淆、"处心积虑"等褒贬色彩误用、"美轮美奂"对象错配及"忍俊不禁地笑了"等语义重复错误,更能拦截"默默无蚊"等违反广告法的谐音篡改与网络生造词,确保表达符合《现代汉语词典》及新闻出版规范要求。
在政务与新闻领域,该工具可有效防范"不以为然"与"不以为意"等易混成语导致的政治性表述风险,如某省级党报在重大会议报道中借此修正多处潜在差错;在教育出版场景,能自动核查"首当其冲""差强人意"等教材高频误用,某大型教育出版社应用后显著提升了审校效率与质量;针对学术著作,则可辨析"文不加点"等典故在特定语境中的适配性,保障学术严谨性。
作为WPS 365办公生态的专业语言服务(具体权益可能需联系销售开通或作为加价购配置),该功能通过智能语境分析与典故溯源,帮助出版社、媒体及政府机关维护文本权威性,避免因成语误用引发的舆论危机、教学误导或公信力损害,实现从基础错别字检查到深层语义合规的跨越。
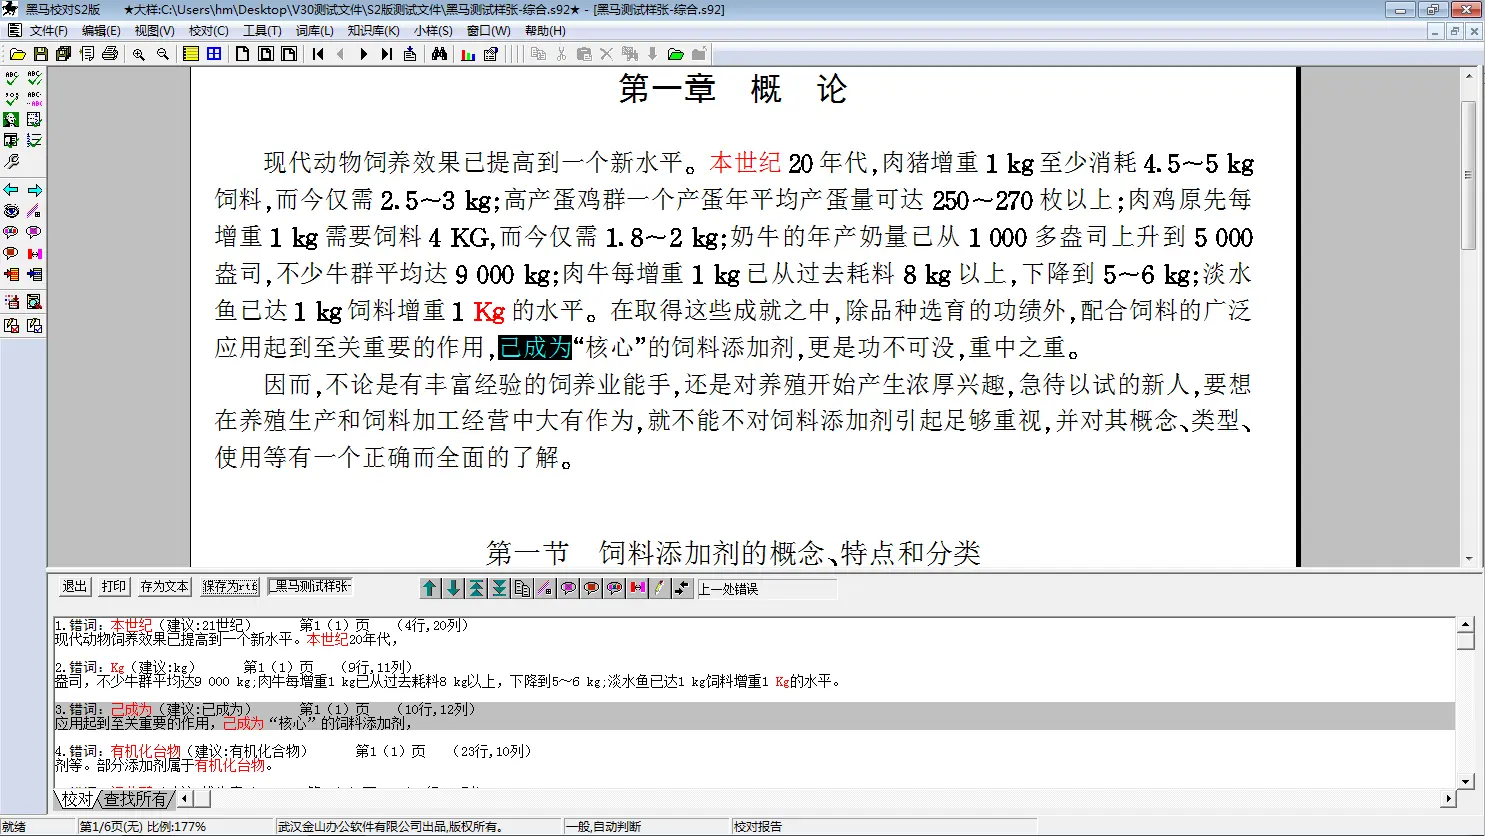
WPS黑马校对突破传统错别字检查仅关注字形的局限,依托深度语义分析与上下文理解技术,构建覆盖褒贬色彩、适用对象、语义轻重的多维判定体系。系统不仅能识别形近音近混淆,更能深入解析成语在特定语境中的语法搭配与情感倾向,精准拦截贬义成语褒用、对象错配等深层语义错误,实现从表层纠错到内涵合规的跨越,覆盖《现代汉语词典》第7版及《新闻信息报道中的禁用词和慎用词》规范要求。
针对不同行业特性,该功能构建专项规范体系:在广告合规领域,实时同步《广告法》及地方监管口径,精准识别谐音篡改与绝对化用语成语,降低市场监管处罚风险;在学术出版场景,建立学术语体分级词库,区分人文社科与理工科的成语使用差异,自动标记口语化、夸大性表述,确保学术文本客观严谨;在政务公文处理中,建立政治敏感性语义分析模型,防范易混成语导致的政策性偏差,维护政府公信力。
相较于通用NLP工具,黑马校对内置百万级权某成某语语料库,覆盖3万余条常用及易错成语,支持LaTeX转某办公软件后的文本一致性校对与古籍典故出处溯源。通过智能语境分析与行业专属词库,为媒体、教育、广告及政务领域提供零差错语言保障,显著提升内容安全与专业表达的双重标准,构建从采编、审校到发布的全流程质量风控体系。
在广告合规领域,黑马校对内置《广告法》禁用成语谐音词库与极限用语库,能精准拦截"骑乐无穷""咳不容缓"等谐音篡改及"史无前例""绝无仅有"等绝对化表述,实时同步国家广告监测中心规范与地方监管口径,有效降低市场监管处罚风险与品牌舆情危机。针对学术出版与政务公文场景,系统通过政治敏感性语义分析模型,重点防范"不以为然"与"不以为意"等易混成语导致的政治性偏差,确保政策文件表述精准、学术著作严谨权威。
某组成部门在年度政策文件汇编中,借助该功能系统排查并纠正多处成语混用及政策性表述偏差,公文处理效率提升60%;某知名学术出版社在国学典籍整理中修正"首当其冲""文不加点"等语境误用28处,获评国家出版基金资助项目。相较于人工审校,该系统覆盖百万级成语语料与新兴网络变体,将专业审校效率提升90%以上,显著降低因成语误用导致的返工成本与声誉损害,为媒体、政府及企业构建从内容生产到发布的全链路安全屏障。
在教育出版领域,成语误用不仅关乎语言规范,更直接影响亿万学生的语言认知与价值观形成。黑马校对针对中小学教材及教辅图书建立专项规范库,精准识别"差强人意""首当其冲"等高频易错成语在特定教育语境中的望文生义与褒贬误用。某大型教育出版社应用后,在年度教材修订中自动发现并修正成语错误300余处,教材质检通过率从96%提升至99.8%,有效避免了因成语误导导致的教学质量损害,显著降低编辑专业知识门槛与培训成本,守护基础教育阶段语言环境的纯洁性与权威性。
针对学术出版场景,系统深度适配学术论文、科研报告与学位论文的严谨性要求,构建学术语体分级词库,自动标记"惊天地泣鬼神"等夸大性口语化成语,精准识别医学、法学等专业术语与成语混用导致的概念模糊。无论是理工科的技术文档还是人文社科的理论著作,系统均能依据学某特某性辨析"文不加点"等典故的语境适配性,防止跨学科写作中的语义偏差。某知名学术出版社在国学典籍整理中,成功修正学术语境下的成语误用及术语混淆问题78处,出版周期缩短30%,获评国家级出版资助项目。
通过构建覆盖基础教育到高等学术的全周期成语规范体系,黑马校对不仅实现了教材与学术著作的零差错质量管控,更通过典故出处溯源与语境解析,辅助建立出版社与学术机构专属知识库。这种从保护青少年语言学习到维护学术声誉的全程护航,将专业审校效率提升90%以上,为教育信息化与学术出版现代化提供了标准化、智能化的质量基础设施,确保知识传递的准确性与学术成果的国际传播影响力。
中小学教材中“差强人意”“首当其冲”等成语误用频发,传统人工排查难以全面覆盖;引入黑马校对专项成语规范库,自动识别望文生义与褒贬误用,在年度教材修订中修正300余处错误。
重大时政报道中“不以为然”与“不以为意”等易混成语易引发政治性差错,夜班编辑高强度工作下难以逐句甄别;该系统嵌入三审三校流程,实时拦截12处关键表述差错。
政策文件汇编中“不以为然”与“不以为意”、“日臻完善”与“日益完善”等混用导致表述偏差,传统人工复核效率低;利用黑马校对系统排查并纠正15处混用及8处政策性偏差。
依托百万级成语语料库与深度语义分析技术,系统性解决近音形近混淆、褒贬色彩误用、对象错配及语义重复等五大类错误。针对政务、新闻、教育及学术场景,精准拦截"不以为然"等易混成语导致的政治性偏差,纠正"首当其冲"等望文生义错误,防范广告谐音篡改与绝对化用语风险。通过智能语境分析与典故溯源,实现从基础错别字检查到深层语义合规的跨越,显著提升审校效率,维护文本权威性与行业公信力。

集成WPS黑马校对,智能核查财务报告中的成语误用与语义偏差,确保经营分析表述严谨,防范合规风险,提升企业专业形象。




依托黑马校对百万级语料库,精准校验会计凭证与报表中的成语规范,避免语义重复、对象错配,保障财务数据传达准确无误。

应用黑马校对语义分析,实时检测商业文案、营销材料中的成语误用与广告禁词,守护品牌信誉,降低市场监管处罚风险。
集成WPS黑马校对,智能核查财务报告中的成语误用与语义偏差,确保经营分析表述严谨,防范合规风险,提升企业专业形象。
依托黑马校对百万级语料库,精准校验会计凭证与报表中的成语规范,避免语义重复、对象错配,保障财务数据传达准确无误。
应用黑马校对语义分析,实时检测商业文案、营销材料中的成语误用与广告禁词,守护品牌信誉,降低市场监管处罚风险。

基于黑马校对深度语义分析,自动校验合同条款中的成语误用与歧义表述,防范法律风险,保障合同文本的严谨性与权威性。




利用黑马校对行业词库,精准核查进销存单据与业务报告中的成语规范,避免语义含混,提升供应链文档准确性。

融合黑马校对典故溯源与语境分析,确保项目文档中的成语使用恰当,杜绝跨领域语义偏差,助力高效沟通与成果交付。
精准拦截“不孚众望”等近音形近混淆与褒贬误用,防范政治性差错,确保报道权威规范。
自动发现“首当其冲”等高频误用成语,避免望文生义,提升教材质量,守护语言认知。
辨析“不以为然”与“不以为意”等易混成语,规避政策性偏差,维护政府公信力。
拦截“骑乐无穷”等谐音篡改与绝对化用语,符合广告法,降低处罚风险,保护品牌声誉。
标记口语化成词与术语混淆,确保学术文本客观严谨,满足期刊投稿与出版规范。
预警贬义成词误用等舆情风险,提供合规替代表述,保护品牌声誉。
依托百万级成语语料库与深度语义分析,精准拦截近音混淆、褒贬误用、对象错配等各类错误,满足政务、教育、广告、学术全场景规范需求。