

WPS 智能表格
支持生僻字数据规范化管理,智能识别表格中人名地名异体字,批量处理古籍文献数字化信息。
支持生僻字数据规范化管理,智能识别表格中人名地名异体字,批量处理古籍文献数字化信息。

支持生僻字信息标准化采集,自动校验户籍地名专用字,适配古籍整理与地方志数据录入场景。

AI智能识别文档生僻字与异体字关系,提供字形结构解析与Unicode编码对照,加速古籍数字化与学术出版。

管理生僻字核对与古籍审校流程,设置三级审核任务节点,跟踪人名地名规范化进度,确保出版质量。

专业生僻字核对工具,覆盖CJK扩展区A-G字符集,自动检测人名地名异形字,3分钟完成百万字扫描,支持古籍与公文处理。
WPS黑马校对提供生僻字智能核对功能,覆盖CJK扩展区A-G共8万+字符,支持Unicode 15.0与GB18030-2022编码。3分钟可完成100万字批量扫描,自动识别古籍、地方志、中医药典籍中人名地名生僻字及异体字,提供字形标注与规范化方案。支持软授权无需U盘,可挂接75个专业词库,适用于出版社、档案馆、政务窗口等场景,解决OCR识别错误与人工考证效率低的问题。
对于需要处理人名、地名或古籍文献的用户,掌握生僻字核对功能的关键在于理解WPS黑马校对的核心能力。该系统内置超大字符集(CJK扩展区A-G),覆盖8万以上生僻字及异形字,联合部户籍字库、地名库,能够自动识别文档中人名、地名专用生僻字,检测因输入法限制导致的形似字替换错误(如“喆”误作“吉吉”),并提供标准字形与拼音标注。相比仅支持GB2312的常用工具,其生僻字检出率超95%,且兼容GB18030-2022与Unicode 15.0编码,可有效避免显示乱码。
上手操作时,用户首先需确认所在企业使用的WPS 365版本权益。该功能通常集成于商业高级版或商业旗舰版套餐中,但部分高级功能可能需要联系销售开通或属于加价购项目。激活后,系统支持自动扫描与批量处理,可在3分钟内完成100万字生僻字扫描,生成分布报告并提供异体字转标准字方案。针对保密单位,支持软授权方式,无需U盘加密锁即可使用。用户还可根据需求自定义企业生僻字白名单,挂接古籍专用库或中医药生僻字库等专业词库。
实际应用中,某国家级古籍出版社在整理《中华大典》时,通过该功能成功识别并校正三千余个异体字与扩展区生僻字,出版周期缩短40%;某省地方志办公室则在编纂《地名志》过程中规范八千余处人名地名生僻字。无论是处理少数民族音译用字,还是校对中医药典籍中的草药名、穴位名,该功能均能提供字形结构展示与Unicode编码对照,确保学术出版与公文处理的严谨性。如需API接口集成或私有化部署,建议与官方洽谈合作。
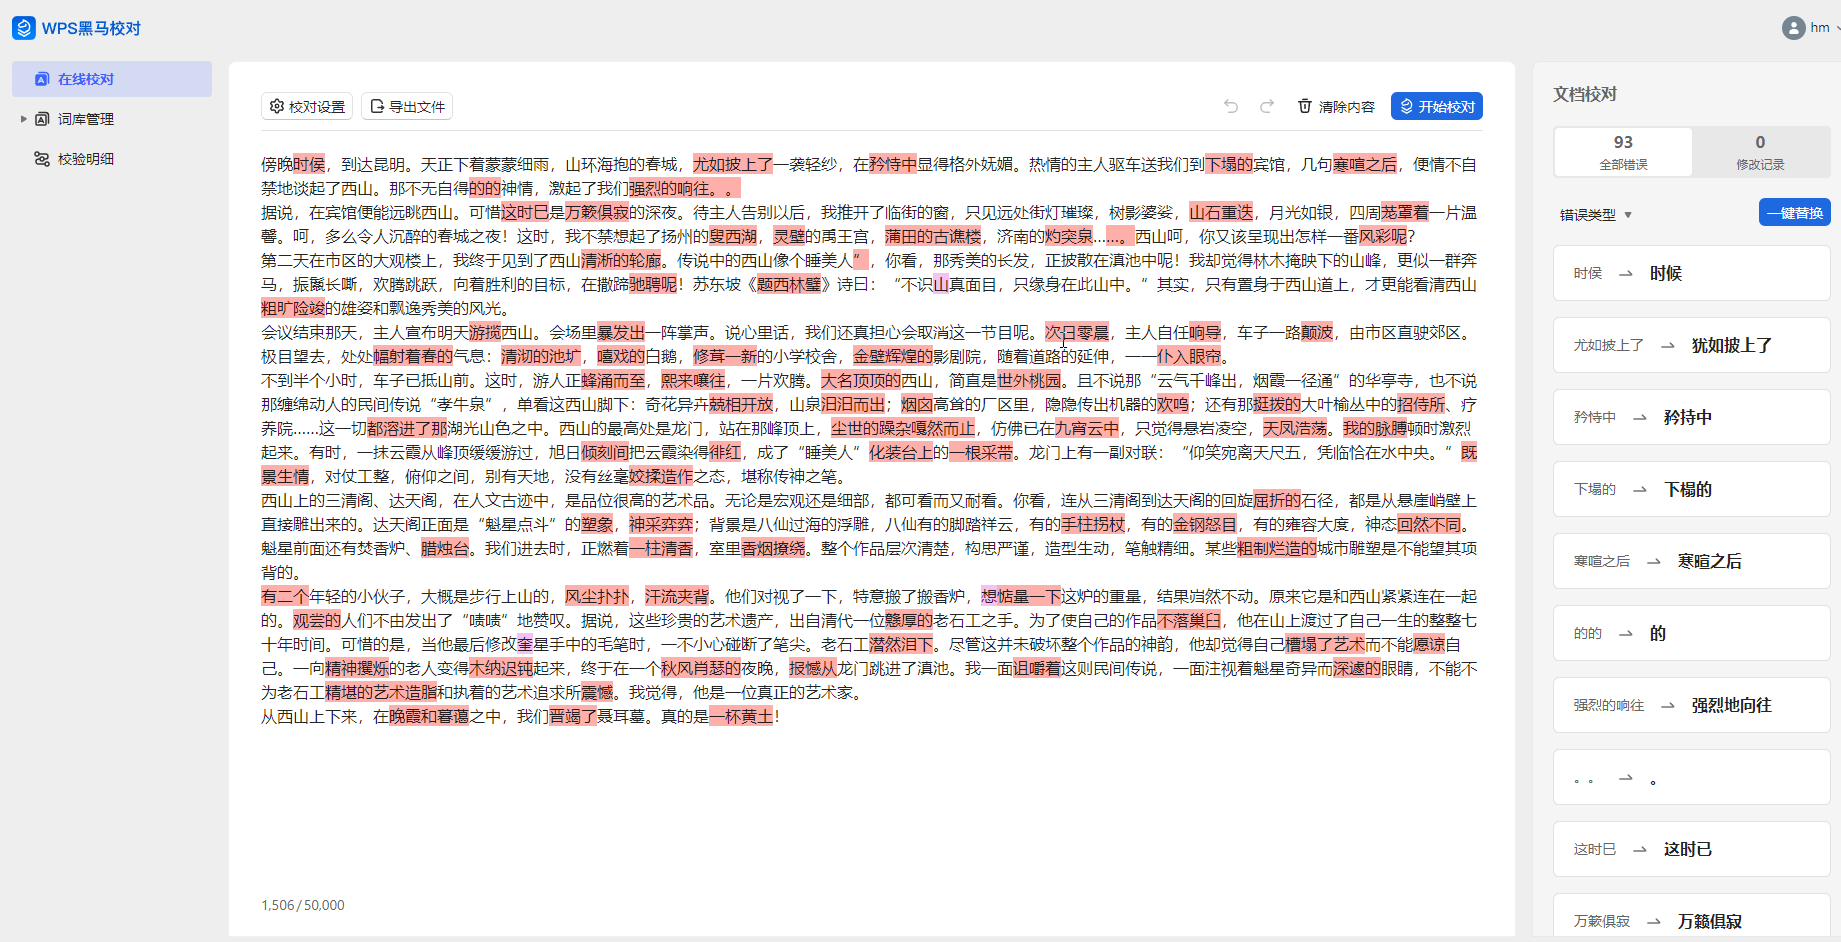
首次使用需确认WPS 365商业高级版及以上版本权限,联系管理员完成软授权激活(无需U盘,适配保密单位环境)。进入校对模块后,建议先执行"生僻字全景扫描"建立文档基线,系统将在3分钟内完成百万字级检测,生成包含字形结构、Unicode编码、读音释义的差异报告。
针对专业场景,用户可一键挂接古籍专用库、中医药字库或少数民族语言库等75个专业词库,自动识别避讳字、缺笔字及异体字关系图谱。对于企业特有术语,通过"自定义词库"功能添加白名单,设定专属生僻字标准写法,避免"喆""堃"等人名常见字被误报。系统支持批量替换与上一处/下一处导航,结合AI推荐的异体字转标准字方案,实现3分钟内完成百级生僻字规范化。
进阶用户可申请API接口,将生僻字核对能力嵌入采编系统或OA流程,实现OCR识别后的自动修正。操作时注意开启GB18030-2022编码合规检查,确保扩展区字符在数字化传输中零丢失。对于音译人名地名,建议同步启用方言读音库与音译用字统一功能,配合人工复核标注,既保留学术严谨性又提升十倍编纂效率。
在实际部署生僻字核对系统时,建立标准化流程是确保校对质量的关键。建议企业在启用WPS黑马校对前,先完成文档预处理设置:统一采用支持CJK扩展区的开源字体(如某源某宋体扩展版),强制嵌入字体子集以避免跨设备显示异常;在系统设置中开启"UTF-8编码合规性检查"与"IDS描述字符验证",确保𠀀、㚻等Unicode 15.0新增字符能被正确解析。对于历史文档迁移,建议先执行"乱码修复"功能,将GBK、Big5等旧编码转换为GB18030-2022标准,防止生僻字在转换过程中丢失或变为问号。
团队协作层面,建议建立"机检-初审-专家复核"的三级审核机制。初审编辑利用系统的"上一处/下一处"导航快速处理常见异体字转换;遇到户籍字库、地名库中的疑难生僻字(如"彧"、"龘"),可一键调用云端专家库或导出差异报告提交文字学顾问。系统支持生成可视化的生僻字分布热力图,帮助管理者识别高频出错区域,针对性调整自定义白名单。对于保密单位,可通过私有化部署实现局域网内的生僻字库共享,确保敏感人名数据不出域。
质量复核阶段需特别关注变体选择符(VS1-VS16)与假名修饰符的处理,避免因显示层渲染差异导致的误判。建议每月执行一次"词库健康度检查",利用系统提供的生僻字使用统计报表,清理过时异体字条目,补充新收录的专业术语(如中医药新发现草药名、民族语言新转写规范)。通过将生僻字核对嵌入ERP或采编系统的CI/CD流程,可实现文档上线前的自动化门禁检查,从制度层面杜绝"吉吉"误作"喆"等硬性错误流入出版环节。
针对不同业务场景,建议采用“先扫描后精读”的冷启动策略。首次使用时,利用批量生僻字扫描功能在3分钟内生成全文档生僻字分布热力图,优先处理高频出错区域。对于户籍、银行等窗口单位,重点开启“人名地名专用模式”,系统可智能区分“彧”“堃”等合法人名用字与“吉吉”类输入法形似错误,避免误报干扰。古籍整理团队则应先行挂接避讳字库与IDS描述字符支持,确保𠀀、㚻等Unicode 15.0扩展区字符正常解析,防止缺笔字被误判为错字。
常见上手误区需特别警惕:一是忽略字体嵌入导致跨设备显示异常,建议统一使用支持CJK扩展区的开源字体;二是未开启GB18030-2022编码检查,造成生僻字在传输中变为问号。针对地方志、中医药等OCR识别场景,应利用“字形相似度匹配”功能批量修正“峯/峰”“淩/凌”等异体字混淆。通过建立企业专属生僻字白名单,将本单位高频出现的少数民族音译用字、古籍专用字纳入豁免库,可大幅降低重复审核工作量,实现从“逐字查证”到“智能过滤”的效率跃升。
整理《中华大典》时,海量异体字与Unicode扩展区生僻字识别困难,人工考证效率低,字形显示异常。引入黑马校对生僻字模块,智能比对异体字并自动标注,确保字形完整显示与学术规范。
整理《中华医藏》时,草药名、穴位名等冷僻字辨识难,繁简转换易混淆,人工注音释义效率低。部署黑马校对中医药专用词库,自动识别并规范异体字,添加注音与释义。
编译《民族词典》时,多民族语言音译用字混乱,Unicode扩展区字符显示异常,双语混排易出错。应用黑马校对多民族语言功能,统一音译标准,校验字符完整性。
确认WPS 365商业高级版权限并完成软授权激活。首次使用执行"生僻字全景扫描",3分钟完成百万字检测并生成包含字形结构、Unicode编码的差异报告。根据业务场景挂接古籍、中医药等专业词库,通过自定义白名单添加企业专属术语避免"喆""堃"等常见人名用字被误报。注意统一使用支持CJK扩展区的字体并开启GB18030-2022编码检查,防止跨设备显示异常或传输丢失。采用"机检-初审-复核"三级流程,利用批量替换和AI转标准字方案提升效率,保密单位可选私有化部署。

好业财深度融合WPS黑马校对,自动识别业务单据中人名、地名生僻字与形似字错误,确保业财数据准确,减少因生僻字导致的报销退回与数据歧义,提升财务合规效率。




WPS项目管理集成黑马校对能力,对项目文档、成员名单中的生僻姓名、专业术语进行一键扫描与规范,避免因字形错误引发的沟通障碍,助力项目文档零差错交付。

好生意结合WPS黑马校对,针对商品名称、客户信息中的生僻字实现智能勘误,支持自定义行业白名单,避免形似字替换错漏,优化进销存全链路数据准确性。
好业财深度融合WPS黑马校对,自动识别业务单据中人名、地名生僻字与形似字错误,确保业财数据准确,减少因生僻字导致的报销退回与数据歧义,提升财务合规效率。
好生意结合WPS黑马校对,针对商品名称、客户信息中的生僻字实现智能勘误,支持自定义行业白名单,避免形似字替换错漏,优化进销存全链路数据准确性。

好会计嵌入WPS黑马校对引擎,对凭证、账簿中的单位名称与个人姓名生僻字进行自动校验,杜绝乱码与缺字,保障财务档案的准确性与可读性,减轻人工复核压力。

WPS合同管理搭载黑马校对,精准检测合同文本中的生僻人名、地名及法律术语,防止形似字输入错误引发的法律风险,确保合同条款严谨有效,提升审查效率。



WPS项目管理集成黑马校对能力,对项目文档、成员名单中的生僻姓名、专业术语进行一键扫描与规范,避免因字形错误引发的沟通障碍,助力项目文档零差错交付。

WPS进销存通过黑马校对实现商品名、供应商名生僻字自动识别修正,支持批量替换与字形比对,减少因字符显示异常导致的出入库错误,提升库存管理精度。
首次使用执行全景扫描,3分钟完成百万字检测,生成差异报告并优先处理高频区域。
开启“人名地名专用模式”,智能区分“彧”“堃”等合法用字与“吉吉”类输入法错误,降低误报。
一键挂接古籍专用库,自动识别避讳字、缺笔字,提供古今字对照,确保古籍整理规范。
通过自定义词库添加专属生僻字标准写法,避免单位特有术语误报,减少重复审核工作量。
开启GB18030-2022编码检查与UTF-8合规,确保扩展区字符传输零丢失,杜绝显示乱码。
建立“机检-初审-专家复核”流程,利用导航快速处理,敏感数据支持私有化部署不出域。
覆盖8万+生僻字与异形字,支持古籍、人名、地名专业校对,自动扫描秒级生成报告,确保文档零差错。