

WPS 多维表格
结合OCR识别结果自动提取扫描件表格数据,实现建筑图纸、医疗档案等结构化存储与多维度分析,降低人工录入成本。
结合OCR识别结果自动提取扫描件表格数据,实现建筑图纸、医疗档案等结构化存储与多维度分析,降低人工录入成本。

提供PDF扫描识别、版式还原及双层PDF生成完整能力,支持本地化批量处理与国密加密,满足企业档案数字化安全合规需求。

基于AI深度识别技术智能解析扫描件图文版式,精准还原多栏排版与表格结构,实现病历、合同等复杂版面高精度数字化。

将OCR识别内容转化为结构化任务,自动提取合同关键节点、病历随访计划等,实现纸质档案到数字化工作流的无缝衔接。

支持双层PDF在线共享与团队批注,在保留扫描件法律效力同时实现协同编辑,确保敏感文档在精细化权限管控下高效流转。
WPS PDF针对扫描件文字识别不准确、模糊歪斜、版式错乱等常见问题,提供AI图像增强、复杂版面还原与本地批量OCR方案。自动纠偏去阴影,精准识别表格多栏排版,支持建筑图纸、法律合同、医疗病历等垂直场景。全程本地运算保障涉密文档安全,识别准确率提升30%以上,助力企业高效完成档案数字化。
PDF扫描识别文字在实际应用中常面临多重技术挑战。首先,扫描件质量缺陷是主要障碍:页面倾斜、阴影遮挡、图像模糊或褶皱会导致OCR识别率显著下降,甚至产生乱码;手机拍摄文档时的角度偏差与光线不均同样会造成识别失败。此外,特殊内容处理难度高:手写体字迹潦草、印章红章覆盖文字、多语种混排以及建筑图纸中的专业符号等场景,均容易出现识别残缺或错误。值得注意的是,若扫描分辨率低于300DPI或语言包设置不当,也可能导致文字变成方块或乱码。
版式还原与批量处理是另一大痛点。复杂版面如多栏排版、图文混排、表格嵌套的文档,常规OCR往往丢失原有结构,导致表格变为纯文字堆砌、阅读顺序错乱,后期整理成本高昂。同时,历史档案数字化过程中,大量扫描件逐一处理效率低下,且敏感文档上传云端存在数据泄露风险,本地批量处理又可能因内存不足导致进度卡顿。
针对上述问题,WPS 365提供分级解决方案:商业高级版(399元/人/年)已包含PDF工具与OCR基础能力,支持扫描件智能增强与版式还原;商业旗舰版(599元/人/年)则提供完整AI Hub与高级识别功能。需特别说明的是,WPS合同、WPS电子签等特定功能在各档位均需加价购买,部分企业级功能需联系销售开通。医疗机构、律所及设计单位等可参考行业案例部署专项优化方案,但具体效果因文档质量而异。
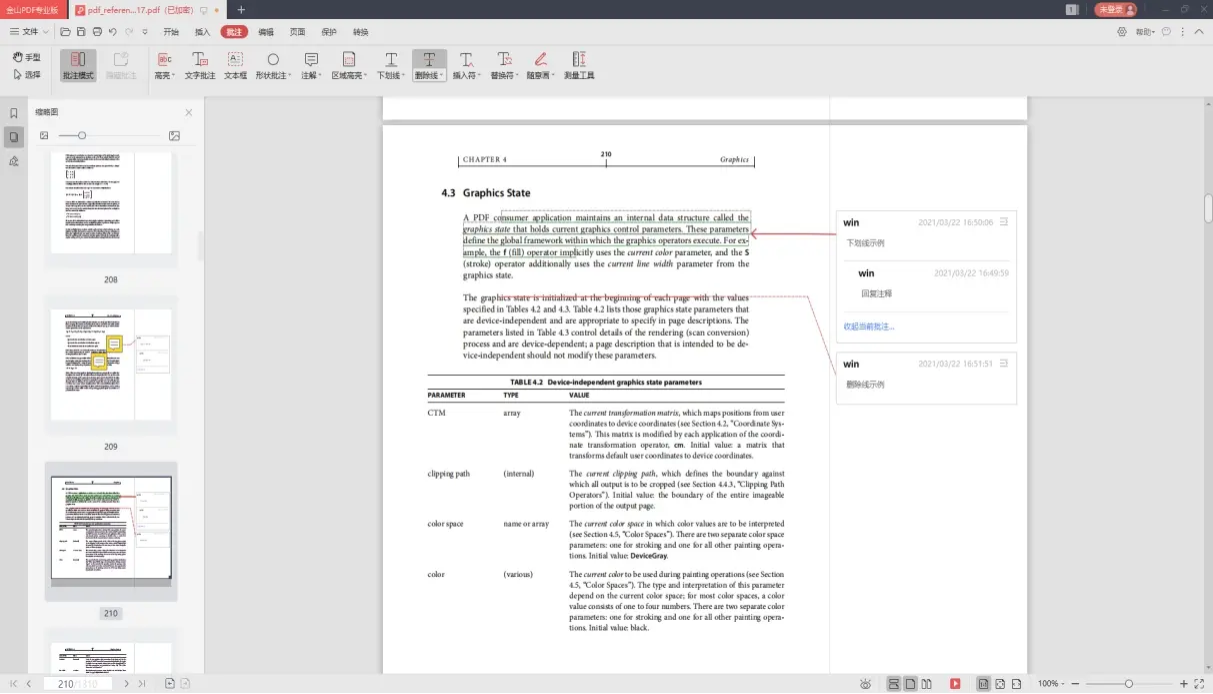
针对建筑设计、法律服务、医疗健康及物流快递等垂直领域的文档数字化需求,金山PDF通过构建行业专属OCR引擎,有效解决了通用识别工具在专业场景下的适应性不足问题。在建筑行业,系统深度优化钢筋符号、混凝土标号等专业术语识别模型,结合图签信息智能提取技术,使扫描图纸转换CAD格式时文字图层保真度达95%以上;法律领域采用印章干扰去除与手写体分离算法,确保合同审查中红章覆盖区域的文字完整识别;医疗场景针对3000余条医学术语及潦草手写病历进行专项训练,实现电子病历系统建设中的高质量数据迁移。
技术层面,系统融合AI图像增强与深度学习版面分析能力,自动完成纠偏、去阴影、锐化等预处理,并通过版式理解技术精准还原表格结构、多栏排版及图文混排关系。支持生成双层PDF格式,在保留原始扫描图像的同时叠加可搜索文字层,解决版式错乱与后期整理成本高昂问题,使复杂版面还原度达95%以上。
针对批量处理与数据安全痛点,企业版提供本地化批量OCR处理能力,全程离线运算杜绝网络传输风险,识别完成后自动应用国密标准加密与精细化权限管控。历史档案数字化项目可实现文件夹级自动处理与目录结构保持,相比在线OCR服务效率提升10倍以上,且满足涉密档案、法务证据等敏感场景的合规要求,实现从图像增强到安全分发的全生命周期闭环管理。
为确保OCR识别效果达到业务要求,文档预处理与质量管控至关重要。首先,扫描环节应严格遵循技术规范:确保扫描分辨率不低于300DPI,避免页面倾斜与阴影干扰;对于手机拍摄文档,需利用透视校正功能修正角度变形并保证光照均匀。在识别设置层面,应根据文档内容选择正确的语言包,针对印章覆盖或手写批注区域采用智能分离算法,必要时手动框选识别区域以排除背景干扰。建议优先采用"双层PDF"输出模式,在保留原始扫描图像的同时叠加可搜索文字层,既满足存档合规要求又实现内容检索。
识别后的数据治理同样关键。针对专业术语或特殊符号可能产生的识别误差,可利用查找替换功能批量修正,并建立行业专用词库进行二次校对。对于涉密文档,应启用本地批量处理模式,确保全程离线运算不上传云端,识别完成后自动应用国密标准加密与精细化权限管控(如禁止复制、限制打印),并开启操作日志审计功能满足合规要求。通过标准化的预处理流程与后置校验机制,可将低质量扫描件的识别准确率提升30%以上,显著降低后期人工校对成本,实现从图像采集到安全归档的全流程质量保障。
OCR识别并非文档处理的终点,而是企业知识资产数字化价值转化的关键起点。通过将扫描件转换为可编辑、可检索的结构化数据, organizations得以打破纸质档案的信息孤岛,实现与核心业务系统的无缝对接。在建筑行业,识别后的图纸图签信息可自动同步至PLM或档案管理系统;法律领域可将合同条款结构化提取并纳入案件管理数据库;医疗机构则能把病历数据直接导入HIS系统支撑临床科研统计,从而构建起贯通设计、法务、医疗等全流程的数字工作流,避免信息在纸质媒介中的停滞与损耗。
在知识管理与协同办公层面,双层PDF技术不仅保留了原始凭证的法律效力,更通过可搜索文字层激活了历史档案的潜在价值。企业可建立跨年度、跨项目的全文检索知识库,实现合同条款智能比对、病历数据深度挖掘或工程图纸秒级调阅。配合精细化权限管控(如禁止复制、限制打印),不同部门可在确保涉密信息安全的前提下进行协同编辑与批注,如施工图纸会审中的在线修改、法律证据材料的团队共享分析等。这种从静态图像到动态数据资产的转变,使文档处理从单纯的成本中心转变为支持业务决策、驱动创新的知识引擎,真正实现降本增效与数字化转型的双重目标。
纸质施工图纸扫描件无法编辑,钢筋符号等专业术语OCR识别准确率低,图签信息提取困难。采用WPS PDF工程OCR方案,深度优化建筑术语识别模型,实现图纸高精度数字化转换与图签智能提取,无缝衔接CAD流程。
扫描合同无法检索关键条款,印章红章覆盖导致文字识别残缺,手写批注与印刷体混合识别困难。采用WPS PDF法律专用OCR,智能去除印章干扰,精准识别手写体与法律术语,生成可搜索双层PDF。
手写病历字迹潦草,医学术语与药品名称识别错误率高,检查报告表格结构丢失。采用WPS PDF医疗OCR,专项训练手写体与医学术语模型,实现病历高精度识别与结构化提取,直接对接HIS系统。
PDF扫描识别常见质量缺陷包括分辨率低于300DPI、页面倾斜、阴影遮挡导致的识别率下降,以及手写体潦草、印章覆盖、专业符号等特殊内容造成的识别残缺或乱码。版式还原困难表现为表格结构丢失、多栏排版错乱和图文混排关系破坏。建议扫描时确保300DPI以上精度,利用透视校正与AI图像增强预处理,选择正确语言包并采用双层PDF格式保留原图与可搜索文字层。针对建筑、法律、医疗等专业场景,应使用行业专属OCR引擎提升术语识别准确率,并通过本地化批量处理保障敏感数据安全,实现高质量数字化转换。

好业财是业财一体化管理工具,与WPS办公套件无缝集成,支持票据OCR识别与智能记账,助力小微企业实现财务数据自动同步,提升经营效率。




WPS 项目管理基于文档协作,支持任务拆解、进度跟踪与团队沟通,可与WPS PDF审阅批注联动,实现设计图纸、合同等文档驱动的高效项目交付。

好会计是智能财税软件,与WPS表格数据互通,自动生成凭证账簿,支持发票扫描识别,满足中小企业财税管理及合规申报需求。

WPS 合同管理覆盖合同起草、审批、履约全流程,融合WPS PDF OCR技术,精准提取合同关键字段,实现红章覆盖区域文字完整识别,保障法务合规。

WPS 进销存专注商贸企业,集成WPS文档实现采购、销售、库存单据电子化,结合PDF扫描件识别,快速录入货品信息,提升运营效率。

好生意是营销型进销存,与WPS Office深度整合,支持客户跟进、订单管理与数据看板,助力小微企业实现生意增长与数字化转型。
WPS 合同管理覆盖合同起草、审批、履约全流程,融合WPS PDF OCR技术,精准提取合同关键字段,实现红章覆盖区域文字完整识别,保障法务合规。



WPS 项目管理基于文档协作,支持任务拆解、进度跟踪与团队沟通,可与WPS PDF审阅批注联动,实现设计图纸、合同等文档驱动的高效项目交付。
WPS 进销存专注商贸企业,集成WPS文档实现采购、销售、库存单据电子化,结合PDF扫描件识别,快速录入货品信息,提升运营效率。
好业财是业财一体化管理工具,与WPS办公套件无缝集成,支持票据OCR识别与智能记账,助力小微企业实现财务数据自动同步,提升经营效率。
好生意是营销型进销存,与WPS Office深度整合,支持客户跟进、订单管理与数据看板,助力小微企业实现生意增长与数字化转型。
好会计是智能财税软件,与WPS表格数据互通,自动生成凭证账簿,支持发票扫描识别,满足中小企业财税管理及合规申报需求。
自动纠偏、去阴影、锐化增强,修复低质量扫描件,识别准确率提升30%以上
智能检测文档边缘,透视校正角度变形,消除手机拍摄的光线不均与倾斜问题
精准保留表格结构、多栏顺序与图文混排位置,版式还原度达95%以上
文件夹级自动处理,保留目录结构,全程离线运算,杜绝云端传输风险
识别后自动应用国密加密与精细化权限管控,支持禁止复制、打印等操作
保留原始扫描图像的同时叠加可搜索文字层,兼顾存档合规与高效检索
集成AI增强与深度学习版面分析,自动纠偏去阴影,精准还原表格、多栏排版,输出双层PDF,让扫描件可搜索、可编辑,高效安全实现文档数字化。
