

WPS 365
覆盖教育出版、政务公文等多场景,提供Windows/Linux双授权及AI审音能力,支持大型古籍数字化项目的多音字精准校对与规范化处理。
覆盖教育出版、政务公文等多场景,提供Windows/Linux双授权及AI审音能力,支持大型古籍数字化项目的多音字精准校对与规范化处理。

在信息采集场景中自动校验登记内容的多音字与特殊读音,确保教育登记、文化普查等数据的文字规范性,减少人工审核成本。

管理教材教辅、新闻稿件等内容审校流程,确保多音字纠错任务及时完成,助力教育出版与媒体机构实现文字质量全流程管控。

基于语境智能判断技术,自动识别教育、播音、公文等场景中的多音字与古汉语特殊读音,支持私有化部署与信创环境适配。

内置5000+易错字词库,精准识别教材、新闻、景区标识等场景中的多音字、生僻字与异读字,保障公共文化内容的准确性与权威性。
WPS黑马校对内置5000+易错字词库与《普通话异读词审音表》,智能识别教育出版、广电播音、博物馆展陈及新闻快讯中的多音字与易错读音,支持CJK生僻字跨平台兼容与Unicode 15.0标准,适配Windows及信创环境,提供API接入与自定义读音库,帮助企业避免舆情风险,保障内容权威性。
在教育出版与语言文字规范应用领域,教材教辅中的多音字、形近字及古诗文异读字错误直接影响教学权威性。例如"长(cháng)征"与"长(zhǎng)大"、"莘(shēn)莘学子"等易错读音,传统人工审核难以覆盖海量文稿。通过内置《普通话异读词审音表》的5000+易错字词库,结合语境智能判断技术,可自动识别"处(chǔ)理"与"处(chù)所"等语境差异,精准校验拼音标注一致性,保障教材符合国家语言文字规范,避免误人子弟的风险。
有声内容制作与公共文化传播场景同样面临严峻挑战。播音稿件中的"大(dài)夫"、"单(shàn)于"等人名地名异读,或"心宽体胖(pán)"、"博闻强识(zhì)"等古汉语特殊读音,一旦误读将引发舆情危机并损害机构公信力。该技术不仅支持CJK扩展区A-F生僻字(如"昝"、"爨")在全平台的一致显示,确保古籍文献数字化准确,还能通过API接入TTS语音合成、在线学习等业务系统,实现读音标注的前置化风险排查,使主播读错率大幅下降。
针对政务公文、法律文书及新媒体快讯,系统可自动标记"给(jǐ)付"、"六安(lù)"等特殊读音,避免外宣材料与法律文书的理解偏差。企业用户可根据WPS 365套餐选择服务层级:如需Windows/Linux双授权及2TB存储空间处理大型古籍数字化项目,商业旗舰版提供完整AI能力与开放接口;基础协作需求可选用商业协作版,但需注意部分专业功能可能需加价购买或联系销售开通,以实现多音字辨析、生僻字兼容等能力的深度集成。
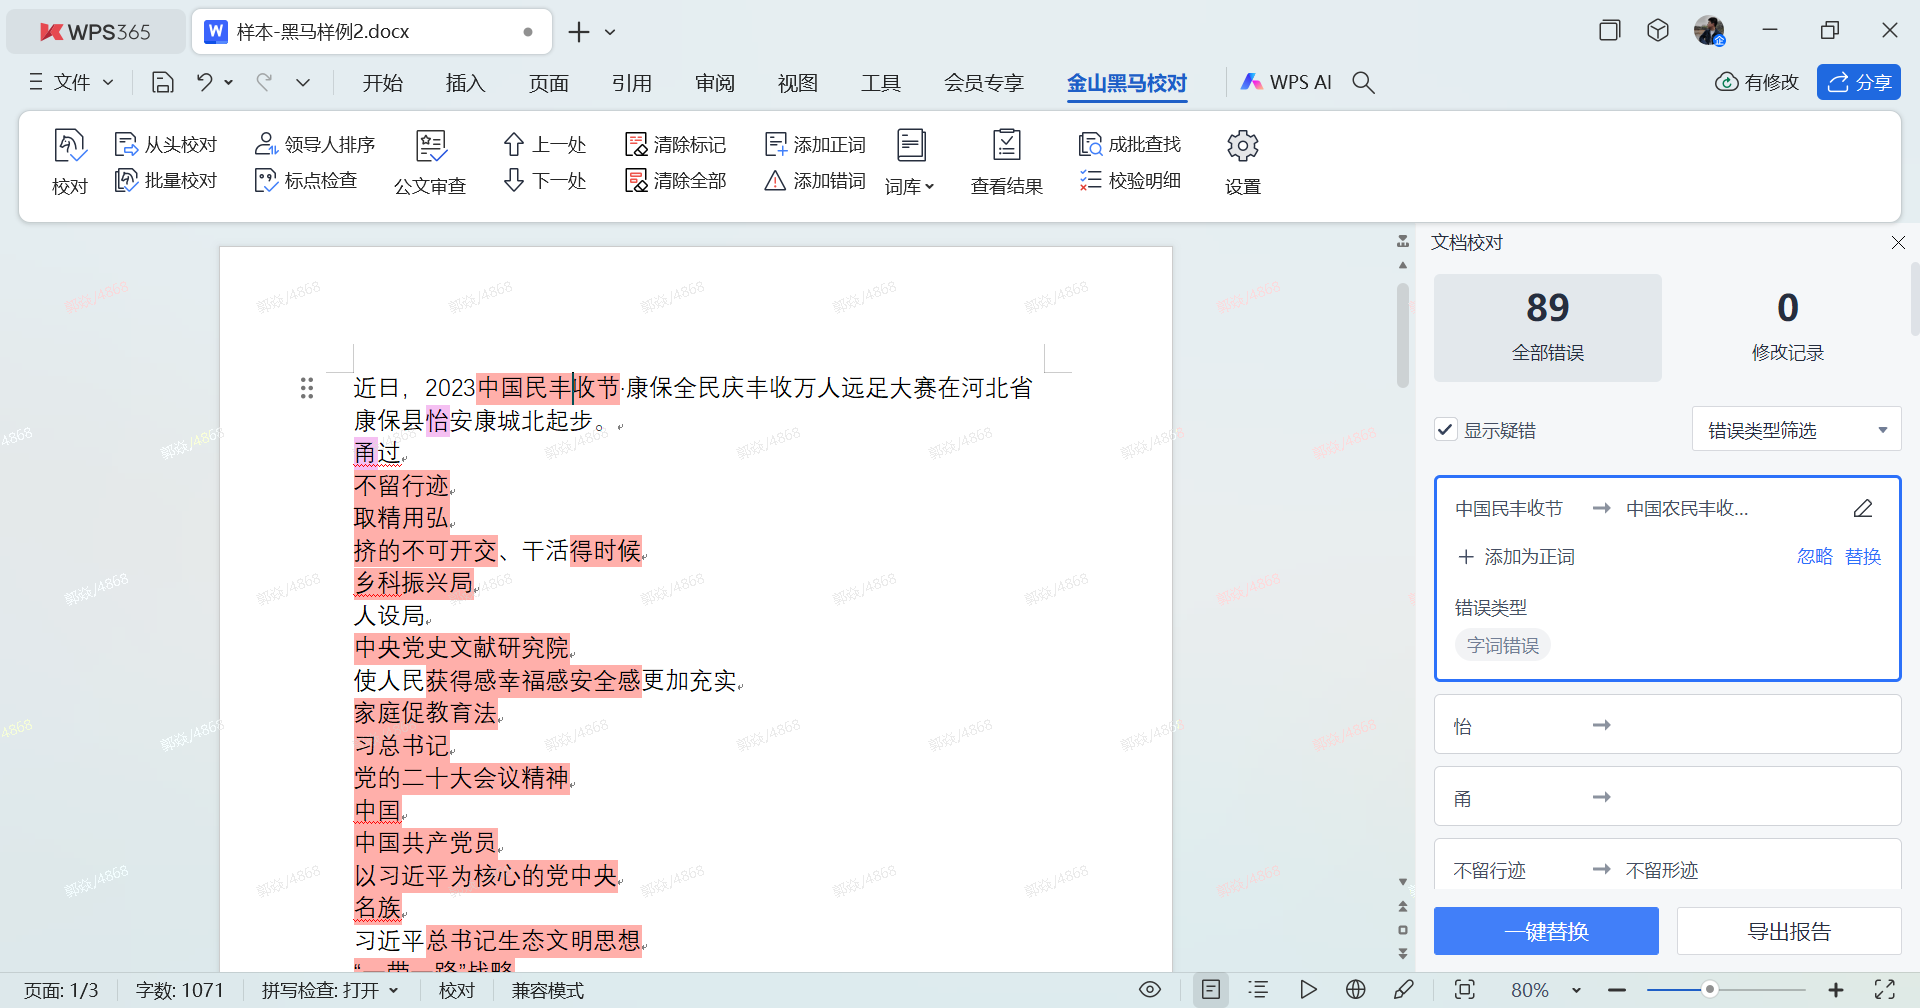
在博物馆展陈、旅游景区及公共交通标识等文化公共服务场景中,文字准确性直接关系到文化机构的权威性与城市形象。文物介绍中的"昝(zǎn)姓"古器、"爨(cuàn)底下村"等地名,以及"博闻强识(zhì)"、"心宽体胖(pán)"等文化典故特殊读音,一旦误读误用将造成难以挽回的文化尴尬。更棘手的是,导视标识牌与展陈物料一旦制作安装,错误将长期公开展示,且传统校对难以覆盖CJK扩展区A-F的生僻字(如"𬀩"、"𬬭")及跨平台显示差异,导致信创环境下古籍文献与文物名称显示异常。
针对此类痛点,系统通过Unicode 15.0全字符集支持,确保生僻字在Windows与信创环境(某麟某、统信等)下的一致显示与准确识别。内置的历史人物称谓库、古地名多音字规则及文化典故专用词库,可自动适配"大(dài)夫"、"单(shàn)于"等文化语境特殊读法,结合公共标识排版规范检查,在内容生产阶段即完成读音风险拦截。同时支持WPS、PDF等常用文档格式的生僻字无损处理,保障跨平台传输中字形与读音标记不丢失,兼容某芯某、某腾某等国产芯片架构。
该方案不仅杜绝了因"六安(lù)"等特殊地名读音错误或生僻字显示异常导致的返工制作成本,更通过文化语境智能分析,确保展陈解说、景区导览与公共交通标识的专业性与准确性,有效维护历史文化传播的严肃性,助力文旅机构构建零差错的内容展示体系,避免因文字失误引发的舆论质疑与品牌形象损害,成为博物馆与公共服务内容审核的标准防线。
在语音合成(TTS)、在线教育平台及智能客服系统的开发中,多音字与易错读音的技术处理长期困扰开发者。当AI主播将"模(mú)具"误读为"模(mó)具",或电子课件把"大(dài)夫"读作"dà夫"时,不仅损害用户体验,更可能引发专业性质疑。更严重的是,企业内部特殊人名地名(如"柘(zhè)树"、"亳(bó)州")及行业术语的特定读音,无法通过通用词库满足,而自建审音系统面临生僻字处理准确率低、开发成本高昂等难题,尤其在私有化部署与信创环境下,多音字语境分析的技术门槛更高。
针对这一技术痛点,系统提供标准读音校对API与JS SDK,支持Java、Python、C++等多语言接入,可无缝嵌入OA、采编、在线教育等业务流程。区别于仅提供字形匹配的通用接口,该方案通过音形义结合的智能语境分析,精准判断"处(chǔ)理"与"处(chù)所"等差异读音,并允许企业自定义专属读音规则库,将特定客户人名、内部术语纳入校验体系。同时支持私有化部署,确保敏感人名地名数据不出内网,且全面兼容某芯某、某腾某等国产芯片架构,满足信创环境要求。
这一技术方案不仅使语音合成系统的读错率大幅下降,更通过统一企业文字读音规范,实现了从内容采编到语音输出的全流程读音管控。教育机构可据此构建标准化的拼音标注体系,政务平台可确保播报内容的权威性,而开发团队则能以较低成本获得覆盖5000+易错字词的专业审音能力,避免重复造轮子,显著提升智能内容生产系统的专业度与可靠性。
在新闻客户端、短视频平台及广播电视的实时播报场景中,发稿时效性与读音准确性之间的矛盾尤为尖锐。当新闻标题将"下载(zài)"误作"zǎi"、"莘莘(shēn)学子"错读为"xīn xīn"时,或热点事件中的"六安(lù)"、"拓跋(tuò bá)"等人名地名出现误读,极易引发网友大规模纠错与舆情危机。传统人工审校难以支撑"秒级发稿"的节奏,而错误内容一旦发布便随流量迅速扩散,对媒体公信力造成不可逆的损害,尤其在涉及文物"青铜罍(léi)"、"昝(zǎn)姓"专家等文化热点时,读音错误直接引发专业性质疑。
针对这一痛点,系统通过实时多音字高亮与读音提示技术,在编辑输入阶段即完成"处(chǔ)理"与"处(chù)所"等易混读音的秒级判定,并动态更新热点事件人名地名专用词库,确保突发新闻中的特殊读音准确无误。其口语化场景易错词库可精准识别"心宽体胖(pán)"、"博闻强识(zhì)"等古汉语读音在新闻解说中的正确用法,配合形近字秒级检测,在发稿前完成最后一道风险扫描,实现快节奏生产与内容安全的平衡。
该技术不仅使日均万篇稿件处理成为可能,更通过舆情敏感读音风险预警,将"给(jǐ)付"、"大(dài)夫"等法律与历史专用读音错误拦截在发布之前,有效避免因读音失误导致的品牌信任危机。无论是24小时滚动新闻的实时字幕,还是短视频平台的爆款文案,均能在确保传播速度的同时,维护媒体的专业权威与文化传播的准确性,成为新媒体时代内容安全的关键防线。
教材中多音字、古诗文异读字错误频发,人工审核覆盖海量教辅困难。通过多音字语境智能识别与拼音一致性校验,精准拦截“长(cháng)征”误作“长(zhǎng)征”等易错点,确保读音与标注符合国家规范。
历史类有声书制作中“大(dài)夫”“单(shàn)于”等多音字和特殊人名地某易某误读,引发用户投诉。采用读音预警模块,自动标注正确读音并前置化风险排查,大幅降低主播备稿负担与读错率。
文物展陈中“昝(zǎn)姓”“爨(cuàn)底下村”等生僻字易误读,且标识牌制作后难以更改。利用生僻字识别与文化专用词库,在展前自动校验解说词与导览文本,确保读音与字形准确。
易读错字广泛应用于教育出版、传媒播报、有声制作、文旅展陈、政务公文及法律外宣等场景。在教育领域关乎教材权威与教学规范,在传媒播报中影响机构公信力与舆情安全,在文旅场景涉及文化严肃性与城市形象,在语音合成与智能客服中直接决定用户体验。建议机构根据业务特性选择适配方案:教育出版侧重拼音标注一致性,传媒侧重实时审校,文旅侧重生僻字跨平台兼容,通过智能语境分析技术构建从内容生产到传播的全流程读音风控体系,实现专业性与准确性的双重保障。

WPS合同管理集成智能校对,精准识别法律文书中的多音字与特殊读音,如“给(jǐ)付”“大(dài)夫”,避免合同歧义,保障条款严谨性,是法务审核的得力助手。




好会计智能财务软件,内置多音字与敏感词校验,确保财务报表、税务文档中专业术语准确无误,避免读音错误引发核算偏差,提升财务合规性。

WPS项目管理工具内置语境校对,自动识别项目文档中的多音字与生僻字,保障计划、报告的专业表述,避免读音误差影响团队沟通与执行。
WPS合同管理集成智能校对,精准识别法律文书中的多音字与特殊读音,如“给(jǐ)付”“大(dài)夫”,避免合同歧义,保障条款严谨性,是法务审核的得力助手。

WPS进销存支持商品名称与单据中的多音字智能校验,确保“模(mú)具”“六安(lù)”等特殊读音准确,避免供应链沟通失误,提升数据规范性。
WPS项目管理工具内置语境校对,自动识别项目文档中的多音字与生僻字,保障计划、报告的专业表述,避免读音误差影响团队沟通与执行。

好业财业财一体化平台,通过智能语境分析,保障业务单据与财务凭证中人名、地名读音准确,如“单(shàn)于”,提升业财数据精准度,助力合规。



好会计智能财务软件,内置多音字与敏感词校验,确保财务报表、税务文档中专业术语准确无误,避免读音错误引发核算偏差,提升财务合规性。

好生意智能进销存管理,内置5000+易错字词库,校验商品名与客户称谓中的特殊读音,避免“拓跋(tuò bá)”等误读,保障营销物料专业性。
自动识别‘处(chǔ)理’‘长(zhǎng)大’等语境差异,5000+易错字库保障拼音标注准确,符合国家规范。
前置排查‘大(dài)夫’‘单(shàn)于’等异读,API接入TTS降低主播读错率,维护机构公信力。
自动标记‘给(jǐ)付’‘六安(lù)’等特殊读音,避免外宣与法律文书理解偏差,确保权威性。
兼容CJK扩展区生僻字,适配‘爨(cuàn)底下村’等文化典故读音,杜绝展陈标识长期错误。
实时高亮‘下载(zài)’‘莘莘(shēn)学子’等易错读音,秒级拦截舆情风险,平衡时效与安全。
通过API与SDK提供语境化读音判断,支持私有化部署,自定义企业专属读音规则,降低开发成本。
基于5000+易错字词库与语境智能分析,自动识别多音字、生僻字及特殊读音,确保教材、媒体、公文零差错。